Gemini 4 Argon实测:哪些任务超越Claude与GPT?

Gemini 4 Argon 以多模态输入见长,但选型需按任务而非单价。
文章以用 Gemini 4 Argon 三次提示词做出 3D 小游戏原型为引,梳理其能力边界:原生支持文本、图片、音频、视频、PDF 五类输入,并具备 agentic video 片段定位能力;百万 token 上下文实为输入、思考与输出共享的预算,常规输出上限约 6.5 万 token。基准上,Argon 在 Vibe Code Bench、GraphWalks、LV Bench 等混合输入与视频任务领先,但在 Terminal Bench、困难工程题上明显落后 Opus 与 Astra。价格促销期 2/10 美元,11 月 30 日后涨至 4/20,且思考 token、缓存、工具调用与返工成本都会影响总账。结论是按任务选型并在自己的场景实测。
Gemini 4 Argon 发布后,一个 3D 小游戏成了测试样本:三车道、能量拾取、60 秒目标,三次提示词迭代跑通原型。这背后是模型能力边界的重新划分——它不是全能选手,但在特定场景下确实压过 Claude 和 GPT 一头。
多模态输入:Argon 的硬底牌
Argon 原生支持文本、图片、音频、视频和 PDF 五类输入。对比之下,Claude 和 GPT 的公开规格只列出文本与图片,其他能力依赖应用层工具补齐。这个差距在"从一段录音开始"的工作流里会被放大——你不需要先转写再喂给模型,Argon 直接吃原始素材。
视频还展示了一个 agentic video 模式:模型可以调用工具定位视频中的相关片段,而不是像普通聊天那样整段上传。对于需要从长视频里提取关键帧做分析的任务,这省掉了大量预处理工程。
输出与上下文:一个容易误读的数字
六个对比模型都标称约 100 万 token 上下文。但"能装下"和"能用好"是两回事。
Argon 常规输出上限约 65,000 token,其他模型标称约 128,000。它有一个特殊长输出模式,可以借用共享预算里剩余的空间继续生成——但输入、思考过程和答案共用同一块预算。这意味着百万上下文不等于百万输出,实际可用空间取决于输入占用了多少。
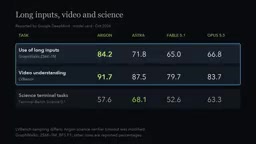
在 GraphWalks 长上下文测试和 LV Bench 视频测试上,Argon 领先。这两个测试正好对应它的两个卖点:长输入的处理效率,以及视频理解能力。需要注意视频分数受各模型帧采样策略影响,横向对比时要带上这个前提。
共享预算(shared budget) 指模型在一次请求内为输入、思考过程(reasoning/thinking tokens)和最终输出共同划定的 token 总额度。它不是三个独立配额,而是一个总池子:输入越长、思考越久,留给答案的空间就越小。因此,标称百万上下文只说明池子的大小,不说明答案能写多长。理解这一点,才能解释为什么 Argon 常规输出上限约 6.5 万 token,却能通过长输出模式“借用”剩余空间继续生成——可借多少,取决于本次输入和思考消耗了多少。
基准对决:赢在哪,输在哪
Argon 领先的项目:
- Vibe Code Bench 91.9,Opus 和 Fable 紧随其后为 90.3——优势微弱,且只覆盖一类编码任务
- Vals Index 专业任务测试
- Automation Bench 工作流自动化
对手领先的项目:
- Terminal Bench 4:Opus 66.4 对 Argon 57.4,终端工作流 Opus 更稳
- Frontier SWE v2 困难工程题:Astra 65.5 对 Argon 55,差距明显
- 科学终端测试:Astra 同样领先
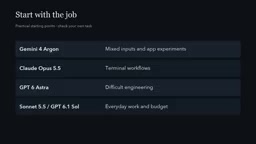
这张分化图很清晰:Argon 强在混合输入和端到端应用实验,Opus 强在终端操作,Astra 强在硬核工程问题。Fable 5.1 定位在重推理和长任务,但没有在上述测试中领先;Sonnet 5.5 和 GPT 6.1 Sol 则主打速度与成本平衡。
GraphWalks 是一类长上下文基准,用来测量模型在超长输入中定位、连接和推理分散信息的能力,而不只是“能不能塞进去”。LV Bench 则针对长视频理解,考察模型从多帧、长时间跨度的视频中抽取事件与因果关系的能力。两者都强调“有效利用”而非“容量”。此外,帧采样策略指模型处理视频时每隔多久抽一帧、抽多少帧:采样越密细节越多但成本越高,采样越稀则可能漏掉关键瞬间。不同模型的采样策略不同,直接横向比较视频分数并不公平,需带此前提。
价格账:标价之外的真实成本
Argon 当前定价每百万 token 输入 2 美元、输出 10 美元,与 Sonnet 和 Sol 持平。Opus 是 4/20,Astra 和 Fable 是 10/50。Argon 的 introductory rate 在 11 月 30 日结束,之后涨到 4/20。
但单价不等于总成本。思考 token、缓存、工具调用和服务模式都会计入账单。OpenAI 的费率在输入超过 272,000 token 后上浮。更关键的是返工成本——一个便宜但需要多次修复的答案,总价可能超过一次到位的高价模型。视频里的建议是按任务选模型,而不是按价格选模型。
思考 token(thinking/reasoning tokens) 是模型在给出最终答案前内部推理所消耗的 token,通常按输出价格计费,但对用户不可见。缓存(prompt caching) 则允许重复使用的长前缀(如系统提示、长文档)以折扣价复用,能显著压低多轮对话的成本。工具调用会额外产生输入输出计费,而服务模式(如批量、优先级、快速响应档)对应不同费率。这些项目叠加后,实际账单往往偏离“输入 2 美元、输出 10 美元”的标价,因此作者强调按任务总成本而非单价选型。
实战验证:三次提示词做出可玩原型
作者在 Gemini Canvas 预览里让 Argon 做一个 3D 气垫船游戏:三车道、能量拾取、障碍扣心、60 秒通关。
第一次提示设定规则,出了首屏;第二次要求霓虹城市和更清晰的视觉效果;第三次聚焦操控和检查逻辑。修订版预览加载花了一些时间,但加载后暂停、恢复、重启都正常——计时器暂停、游戏继续、重启恢复心数并清零分数。作者最终存活 33.4 秒,没完成 60 秒目标。
这里有个诚实的细节:模型报告把浏览器检查标记为未测试。也就是说,原型能跑,但离可分享还有验证工作要做。这恰好呼应了选型逻辑——Argon 适合快速把想法变成可交互的东西,但交付前的检查不能省。
Gemini Canvas 是 Gemini 中面向“边聊边生成”的交互式工作区,可在对话中直接产出并预览可运行的网页、小游戏或交互原型,适合快速验证想法。预览(preview) 意味着模型或功能仍处于早期可用阶段,行为可能不稳定、加载较慢或缺少完整验证。文中“修订版预览加载花了一些时间”正属于此类现象。也正因如此,原型能跑通不等于可交付——浏览器检查、边界条件测试等工程验证仍需人工补上。
选型建议
按视频给出的结论:混合输入和应用实验起步用 Argon;终端工作流选 Opus;困难工程任务上 Astra;对响应速度和预算敏感时考虑 Sonnet 或 Sol。最终判断标准只有一个——在自己的任务上跑一遍,看结果。
相关推荐

强化学习通关《抡大锤》:63%进度背后的分布式训练策略
开发者用深度强化学习挑战《抡大锤》,智能体从底部攀爬至63%进度,卡在铁砧部分。项目开源,采用分治训练和CPU训练策略,寻求社区协作突破瓶颈。

AAAI 2027二审放榜在即:社区热议评审公平与投稿生态
AAAI 2027第二阶段评审结果即将公布,Reddit社区热议评审一致性与流程透明度。本文梳理放榜前的社区情绪、顶会评审的结构性矛盾,以及作者应对二审结果的务实策略。

Sigma FP2发布:全球最小全画幅相机迎来传感器与屏幕升级
Sigma发布FP2全画幅相机,延续全球最小最轻设计,带来改进型传感器、翻转LCD屏和更长续航三大升级,专为便携视频创作者打造,补齐初代fp的体验短板。