Gemini 4 Argon实测:跑分霸榜但实战翻车?

Gemini 4 Argon 跑分登顶,但实测暴露 3D 生成与视频幻觉短板。
B站UP主陈小燕对谷歌 Gemini 4 Argon 进行了五道题的全方位实测,覆盖3D动画、物理模拟、工具开发、视频理解和方案分析。结果显示,模型在结构化任务上表现稳定:抽奖工具功能完整、交互清晰,多文档方案分析准确识别全部关键修改点,UI体验优于 GPT-6 Ostra。但在创意与感知任务上短板明显:3D动画关节错位、画面简陋,且提升思考强度后反而更差;视频理解出现幻觉,对画面中未出现的手部进行了臆测描述,而竞品选择不编造。文章指出,跑分霸榜与真实体验之间仍存在鸿沟,高思考强度失效更让人质疑其思考机制的有效性。
沉默近一年后,谷歌带着 Gemini 4 Argon 重返第一梯队。13项测试登顶、一项并列第一的成绩确实亮眼,但跑分和真实体验之间的落差,才是用户最关心的事。B站UP主陈小燕对 Gemini 4 Argon 进行了一轮涵盖代码生成、物理模拟、工具开发和视频理解的全方位实测,结果有惊喜也有意外。
跑分霸榜之后,实测才是试金石
Gemini 4 Argon 已向付费用户全面开放,用户可以在设置中选择不同的思考强度。不过你可能没注意到,Anti-Gravity 功能仅限 Ultra 订阅用户使用,Pro 用户无法触达,订阅门槛的精准划分引发了不少讨论。原有的 Spark 按钮更名为"任务",支持后台运行,Gemini 4 Argon 也可作为任务模型调用。
这轮测试共设计了五道题,覆盖3D动画生成、物理交互、抽奖工具开发、视频内容理解和活动策划方案分析,基本涵盖了普通用户最常见的AI使用场景。
思考强度(Thinking Budget) 是大模型推理阶段的一个重要可调参数。以 Gemini 系列和 OpenAI 的 o 系列为代表,这类模型在回答前会先产生一段「内部推理链」,消耗额外 token 进行自我检查、拆解步骤和方案比选。思考强度越高,模型可用的推理预算越大,理论上越适合数学、代码和复杂规划任务。但它并非线性增益:当预算过高时,模型可能陷入过度推演、反复自我怀疑,或者在生成类任务中把「谨慎」错用为「保守」,导致画面元素简化、动作僵硬。文章中提到「高思考强度反而输出更差」,正是这一机制在创意生成场景中的典型失效——推理能力的加码,未必能转化为生成质量的提升。
3D动画生成:与竞品差距明显
第一道题要求生成"一只提壶骑自行车"的3D动画。UP主首先使用中等思考强度运行,生成的成品出现了脚部脱离踏板的问题,整体画面也相当简陋。
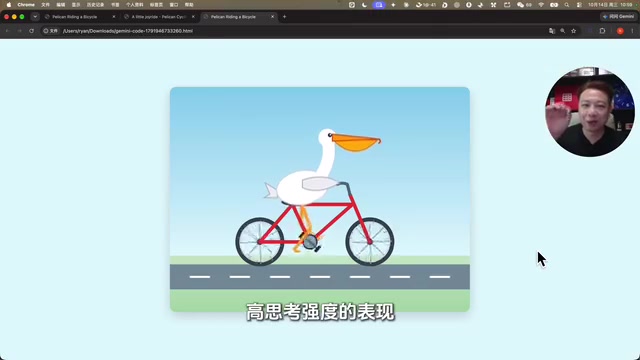
切换到高思考强度后,结果反而更差。对比 GPT-6 Ostra 生成的版本,差距一目了然——Ostra 的版本在细节完整度和视觉丰富度上明显高出一个档次,用UP主的话说,"一个像毛坯房,一个像豪华装修"。
这道题暴露出 Gemini 4 Argon 在3D动画生成上的短板:即便是简单的具象场景,模型在关节连接和动作合理性上仍然存在明显缺陷,且思考强度的提升并未带来质量改善。
物理模拟与工具开发:有来有回
第二道题是旋转六边形内五个小球的物理互动演示。Gemini 4 Argon 生成的版本在球体运动轨迹上基本正常,没有出现悬浮或穿透边界等明显的物理规则违背。但 GPT-6 Ostra 的版本增加了重力方向示意,在高速运动下的不规则性表现更贴近真实物理。两相对比,UP主认为 Ostra 在物理规则的遵循上略胜一筹。
第三道题是抽奖小工具的开发。Gemini 4 Argon 的版本在大红色UI下实现了完整功能:支持名单去重(粘贴两个"小王"后自动识别有效参与者为五人)、限制已中奖者不重复中奖、刷新后保留数据。
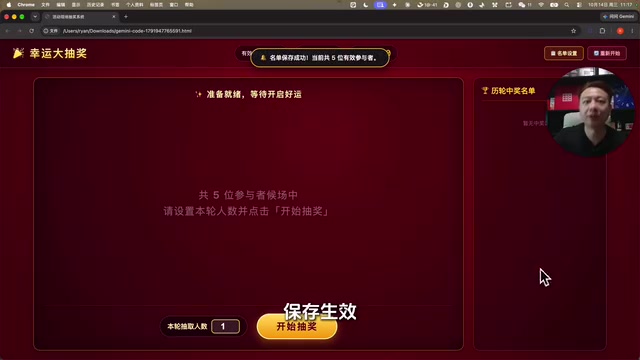
当剩余人数不足时,工具会给出"无法抽奖,本轮设置两人,当前仅剩一人"的明确提示。重新开始功能也有确认弹窗,整体交互逻辑清晰。
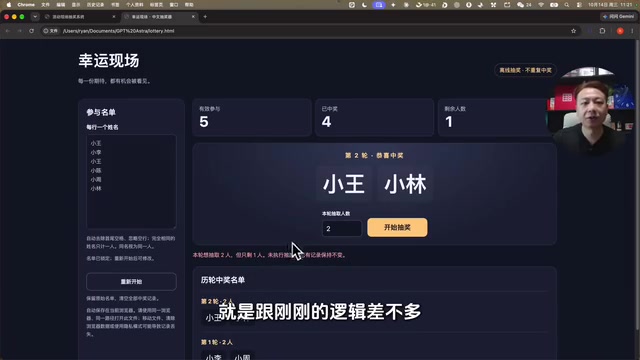
GPT-6 Ostra 的版本功能逻辑基本一致,但在UI美观度和用户提示的温馨程度上不如 Gemini。UP主在这一轮将胜利判给了 Gemini 4 Argon。
视频理解:识别力强但存在幻觉
第四道题测试视频内容理解。UP主上传了一段"笔在纸上、笔移开、杯子放在纸上、杯子离开屏幕"的短视频,要求模型回答杯子和纸的位置关系、操作顺序、杯子装了什么等问题。
Gemini 4 Argon 在位置判断和内容描述上表现不错,对杯中物品的描述相当详细。但在初始画面的解读上出现了幻觉——原文中手尚未进入画面,模型却声称"右手握着准备拿起"。
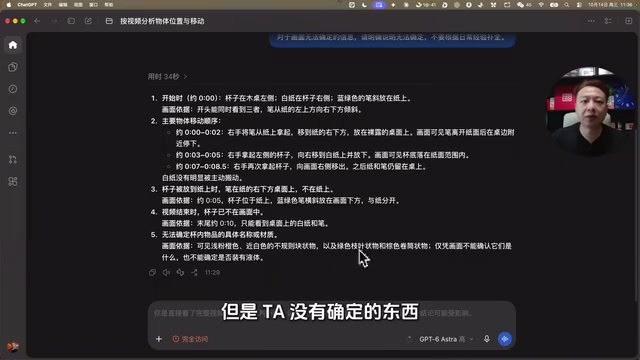
GPT-6 Ostra 没有出现这个错误,且对不确定的内容选择不编造,UP主认为这种"不知道就不说"的底线意识值得肯定。两者在视频理解上整体合格,但 Gemini 的幻觉问题提醒我们:识别能力强和描述详细,并不等于准确。
多模态幻觉(Multimodal Hallucination) 指模型在图像或视频理解中,输出了画面中并不存在的人、物或动作。与纯文本幻觉不同,视频幻觉往往更隐蔽:模型能正确识别主体和场景,却会在时间维度上「脑补」前后帧的动作衔接。常见诱因包括训练数据中对「典型动作序列」的强先验——比如看到笔和纸,模型会倾向补全「手握笔准备书写」这一常见叙事,即便当前帧里手尚未入画。文章里 Gemini 4 Argon 声称「右手握着准备拿起」而画面中并无手部,就是这种先验压过事实的典型表现。相比之下,选择「不确定就不描述」的模型,实质是在幻觉与召回之间做了更保守的权衡。
实际场景应用:方案理解能力过关
最后一道题模拟真实工作场景:给出A方案(旧)、B方案(新)和C方案(执行),要求模型列出必须修改的问题和不合理之处。
Gemini 4 Argon 快速给出了答案:座位从60个调整为80个、餐食和礼品数量相应增加、结束时间从16点延至16点30分且在场地租用时间内、主持人更换等,全部识别正确。费用增加的推算也准确无误。这道题展示出 Gemini 4 Argon 在多文档信息整合和实际业务理解上的可靠表现。
多文档信息整合(Multi-document Reasoning) 是衡量模型能否胜任真实办公场景的关键能力。它要求模型同时读取多份来源不同、格式各异的材料,在其中交叉比对、发现冲突,并给出可执行的修改建议。与单文档问答相比,它的难点不在于「读懂」,而在于「对齐」:同一件事在 A、B、C 三份文档中的表述可能不一致,模型必须判断哪份是最新版本、哪些数字需要联动调整。文章中的座位数从 60 调到 80、餐食礼品随之增加、结束时间延后但仍需落在场地租用时段内,正是一组典型的连锁约束推理。这类任务上表现稳定,说明模型在结构化信息处理上已具备实用价值。
跑分与体验的差距,说明什么
五道题当然无法覆盖一个AI模型的全部能力,但已经能看出 Gemini 4 Argon 的几个特点:在结构化任务(工具开发、方案分析)上表现稳定,在创意生成(3D动画)和感知任务(视频理解)上仍有明显短板。
跑分霸榜证明了模型在标准化测试中的实力,但标准化测试与真实使用场景之间的鸿沟,恰恰是用户日常感受最强烈的地方。高思考强度反而输出更差的情况,也让人对模型思考机制的有效性打上问号。
谷歌在 Gemini 4 Argon 上的进步是真实的,但"回到第一梯队"和"重新成为首选"之间,还隔着无数个真实场景的检验。你用上了吗?感觉如何?
相关推荐

育儿付费从何时成为常态?职场妈妈与托育变迁
育儿付费何时成为常态?本文梳理从70-80年代托育中心兴起、90年代联邦补贴挂钩工作要求,到污名下降与成本上升的演变,并探讨倡导者推动托育与带薪产假追赶其他国家的25年努力。

AI智能体最该接管的任务是什么?Reddit热议
Reddit热议:你最希望AI智能体完全接管哪项任务?跨应用数据迁移、CRM更新、报告生成位列榜首,但可靠性不足和信任鸿沟成为自动化落地的最大障碍。

产品市场匹配的红色警报:顶级VC与Superhuman创始人实战指南
Iconiq、Sapphire Ventures投资人与Superhuman创始人Rahul Vohra分享产品市场匹配(PMF)的红色警报与实战方法,包括40%失望度法则、留存曲线和获客成本等关键指标。