Gemini 4 Argon首发实测:19项跑分赢14项,偏科严重

Gemini 4 Argon发布,长程任务强但偏科,11月30日前API价格减半。
Google 正式发布旗舰模型 Gemini 4 Argon,API 定价输入 2 美元、输出 10 美元,仅为窗口期价格,11 月 30 日后翻倍至 4 美元/20 美元。使用权限分三档:API 付费可直接调用,Pro/Ultra 订阅可在 Gemini App 和搜索 AI Mode 使用,Anti-Gravity 写代码需 Ultra 最高档,免费版无薅羊毛空间。官方 19 项测试中 Argon 赢 14 项,Deep SWE 长程软件工程 77.9% 排名第一,但 Terminal Bench 4.0 输给 Opus 5.5、Frontier SWB 输给 GPT-6 Astra,偏科明显。实际演示中,像素城堡、3D 飞行、恐龙岛、蛛丝摆荡及自行车骑行等长程多步骤任务均一次成型,体现 Deep Walk 能力。结论:Argon 是长程任务利器,日常问答大材小用,窗口期是低成本上车时机。
Google憋了大半年的旗舰模型Gemini 4 Argon终于正式发布。但发布信息中最值得关注的不是模型名字,而是价格、使用权限和实际演示水平。
价格窗口期:现在上车还是等翻倍
目前API定价为输入2美元、输出10美元,与GPT-6.1 Salt同价,是Cloud Opus 5.5的一半。但11月30号之后价格直接翻倍,变成4美元20美元,与Opus持平。
据B站UP主宇泽的实测分析,使用权限分三档:API付费可直接调用;订阅Pro或Ultra的用户可在Gemini App和搜索的AI Mode中使用;想在Anti-Gravity里写代码则必须是Ultra最高档。免费版没有任何薅羊毛空间。
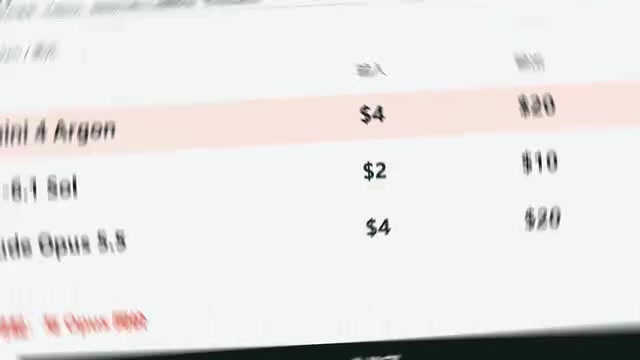
缓存输入另有优惠,具体以官方价目表为准。如果想低成本试用,11月30号之前是明确的窗口期。
Anti-Gravity 是 Google 推出的AI 编程环境/IDE,定位类似 Cursor 或 GitHub Copilot Workspace,允许开发者在编辑器内直接调用 Gemini 模型进行代码生成、重构与调试。文章提到"想在 Anti-Gravity 里写代码则必须是 Ultra 最高档",说明 Google 将最消耗算力的编程 Agent 能力与最高订阅层级绑定,形成分层变现:API 按量付费面向企业集成,Pro/Ultra 订阅覆盖轻量用户,而 Anti-Gravity 这类高价值场景只向 Ultra 开放。这种策略与 OpenAI、Anthropic 对编程工具的权限划分思路一致,也意味着个人开发者若想低成本使用 Argon 写代码,走 API 按量付费在窗口期内反而可能比订阅 Ultra 更划算,但需自行管理 token 消耗与缓存命中率。
跑分成绩:19项赢14项,但存在明显偏科
官方公布的19项测试中,Argon赢了14项。Deep SWE长程软件工程得分77.9%排名第一,Boss Index同样第一。
但偏科问题不容忽视。Terminal Bench 4.0输给了Opus 5.5,Frontier SWB套输给了GPT-6 Astra。这说明Argon并非全面碾压,而是在特定维度上有所取舍。
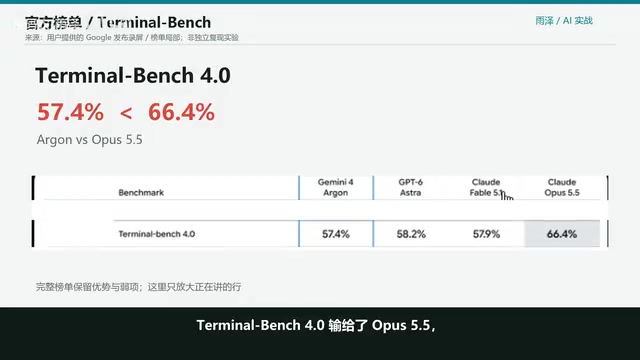
跑分只能提供参考,真正有说服力的是实际演示。
Deep SWE(Deep Software Engineering)是评估大模型在长程软件工程任务中综合能力的基准测试,区别于传统单文件代码补全或算法题,它要求模型在真实代码库中完成多文件、多步骤的修改、调试与重构,考验上下文保持、工具调用与规划能力,因此得分高低更能反映模型能否胜任"AI 程序员"角色。Terminal Bench 则聚焦模型在终端环境下的操作能力,包括命令行工具使用、Shell 脚本编写、系统调试与错误恢复,对模型的推理链稳定性和环境感知要求极高。Frontier SWB(Frontier Software Building)偏向从零构建完整应用的端到端能力,通常涉及前后端联调、UI 生成与部署逻辑,考查模型将模糊需求转化为可运行项目的水平。三者分别对应软件工程中的"改"、"调"、"建",Argon 在改与建上领先,却在调与部分建上失分,说明其优势集中在规划与生成,而在精细工具操作上仍有短板。
实际演示:长程任务才是主场
像素风对比:左边Argon、右边GPT-6 Astra,同题绘制像素城堡夜景。
3D飞行游戏:左边Argon、右边Opus 5.5,醍醐特技飞行同题对比,看谁飞得稳。
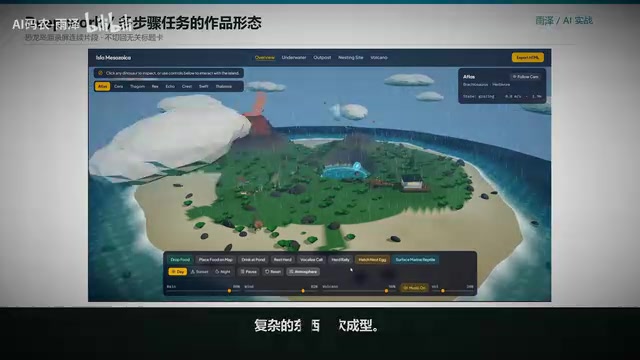
恐龙岛:昼夜循环、降雨、火山喷发、恐龙群行为,一整套3D交互网页一次端出。这正是Google所强调的Deep Walk长程多步骤任务能力——复杂的东西一次成型。
蛛丝摆荡3D游戏:左右同题Argon对Opus 5.5,直接拼Gameplay和计分。
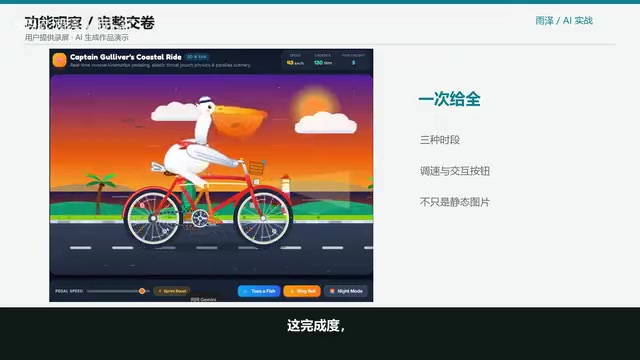
醍醐骑自行车:UP主宇泽的老规矩测试题。上一期Open Code降制实测考的也是这道题。这次同一道题考Argon,项目名为Captain Gulliver's Coastal Ride,支持白天、黄昏、黑夜三种模式,踏板调速,还能丢余按0一次给全。完成度对得起旗舰两个字。
Deep Walk 是 Google 为 Gemini 4 Argon 强调的长程多步骤任务执行能力,其核心在于模型能在单次会话中保持对复杂目标的持续跟踪,自主拆解子任务、调用工具、校验中间结果并动态修正路径,而不是每步都依赖人类重新提示。与传统"一问一答"式交互不同,Deep Walk 更接近智能体(Agent)工作流:模型像项目经理一样规划顺序、分配注意力、在长上下文中记住早期决策,最终一次性交付完整可运行成果。文中演示的 3D 飞行游戏、恐龙岛交互网页、蛛丝摆荡游戏等,都是需要数百行代码、多轮资源生成与逻辑调试的任务,恰好验证了 Deep Walk 在"一次成型"上的价值,也解释了为什么日常问答用它属于大材小用——那类任务根本触发不了长程规划机制。
结论:长程任务的利器,日常问答大材小用
Argon的定位非常清晰——为长程任务准备。写代码、做游戏、搞科研,Deep Walk是它的主场。日常问答用它属于大材小用。
价格方面再提醒一次:2美元10美元直到11月30号,窗口期过后翻倍。你会现在上车还是等12月看它翻倍?
相关推荐

大厂AI工程化面试:前端监控到Agent全链路可观测性
从PerformanceObserver采集性能指标、onerror与unhandledrejection捕获异常,到RAG链路重排优化、上下文压缩控制token成本,再到对标LangSmith与Sentry的全站AI全链路可观测性体系设计,拆解大厂AI工程化面试的三层递进考点。

WorkBuddy保姆级教程:手把手搭建专属AI Agent工作助理
WorkBuddy保姆级教程:从豆包等聊天模型的局限讲起,手把手教你搭建专属AI Agent工作助理,实现本地文件批量处理与自动化操作,非程序员也能轻松上手。

Windows下用LangChain-Chatchat+DeepSeek搭建本地知识库
本文整理B站教程,详解Windows下用LangChain-Chatchat与DeepSeek搭建本地知识库的全流程,包括Anaconda环境配置、Ollama模型管理、镜像源加速及常见报错解决,助你快速实现RAG问答。