Gemini 4 Argon突袭发布:跑分屠榜却遭员工实战吐槽
谷歌Gemini 4 Argon登顶跑分榜却遭遇实战质疑,国产厂商、OpenAI、Anthropic同日密集迭代,AI落地加速。
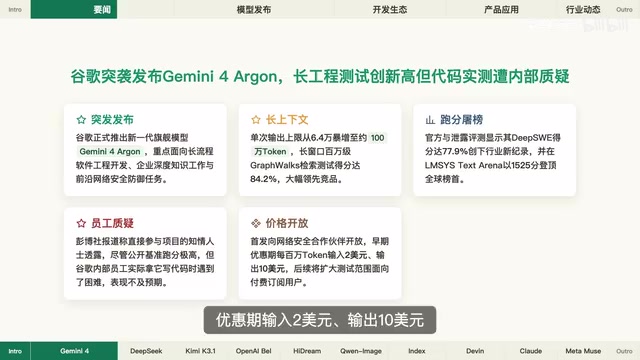
10月1日,谷歌无预警发布Gemini 4 Argon,单次输出上限达100万Token,在软件工程基准Deep7e上以77.9%创下新记录,但随即被曝内部实战表现与跑分存在落差,再次引发业界对基准可信度的质疑。与此同时,DeepSeek Harness V0.2预览版上线、Kimi K3.1灰度验证、B站开源多语言翻译模型,国产厂商在Agent工具链与垂直本地化上集中发力。OpenAI内部实验模型Bell泄露,指标据称超越GPT-6 Astra。生成侧,Vigo Turbo通过去CFG与步数压缩实现最高5倍加速;Cognition的Devon成本最高下降70%;Anthropic浏览器Agent正式向付费用户开放。消费端,AI助手Mios上线22天在美下载破500万,超越当年ChatGPT增速。整个赛道竞争焦点正从参数规模转向真实可用性与落地效率。
谷歌又一次打了业界一个措手不及。10月1日,Gemini 4 Argon无预警上线,凭借亮眼跑分迅速登顶多项榜单,却也在内部引发了实战表现的争议。另一边,DeepSeek、月之暗面、OpenAI、Anthropic等一线玩家动作频频,整个AI赛道在这个时间节点进入新一轮密集迭代。以下是绿鸭AI日报梳理的核心动态。
Gemini 4 Argon:榜单新王还是纸面实力?
谷歌本次推出的旗舰模型Gemini 4 Argon,最大的看点在于单次输出能力的大幅提升——上限约100万Token,这对长流程、大规模代码生成和文档处理场景意义重大。在长流程软件工程测试Deep7e中,Argon创下77.9%的新记录,超越了此前的Claude Opus 5.5,稳居榜首。
不过,光鲜的跑分背后出现了不同声音。据彭博社爆料,谷歌内部员工在真正使用Argon编写代码时遇到了困难,实战表现与基准测试成绩之间存在落差。这种"跑分屠榜、实战翻车"的反差,再次印证了一个老问题:Benchmark分数并不能完全代表模型在真实工程环境中的可用性。
商业策略上,谷歌选择首发向网络安全合作伙伴开放,并给出优惠期定价:输入每百万Token 2美元、输出10美元。相对偏高的输出定价,也暗示谷歌对这款模型的高端定位。
Deep7e(全称 Deep Software Engineering Benchmark 7th Edition)是目前业界认可度较高的长流程软件工程评测集,专门考察模型在真实代码库中完成端到端任务的能力,涵盖需求理解、多文件修改、测试编写和调试等完整开发链路,比早期仅测试单函数补全的HumanEval等基准更贴近实际工程场景。正因如此,它的得分对专业开发者更具参考价值,但也更容易暴露"过拟合基准"的问题——模型可能在特定类型的测试用例上表现优异,却在风格迥异的真实代码库中失效。谷歌内部员工反映的实战落差,本质上正是这一泛化问题的具体体现。
国产力量集中发力:DeepSeek、Kimi与B站开源
国内厂商在这一天同样热闹。DeepSeek广告 Harness桌面端正式发布V0.2预览版,支持多智能体协同管理与本地工作流编排,瞄准的是日益流行的Agent开发需求。配合国庆限时活动,符合条件的用户登录即可领取6元算力体验金,已登录用户退出重登即可入账,有效期7天。
月之暗面的新一代模型Kimi K3.1也被社区发现已在测试子域名上线灰度验证。从截图看,团队正在进行紧锣密鼓的端到端联调,重点预计落在长上下文推理与逻辑思考能力的升级上。
B站Index大模型团队则宣布开源Index Translate多语言翻译模型家族,涵盖20亿、90亿与350亿参数等不同规模,支持多达150种语言翻译。更有意思的是,它针对网络流行用语和弹幕文化做了专项调优——这一本地化细节,可能是其区别于通用翻译模型的差异化竞争力。
OpenAI神秘模型Bell曝光
海外技术博主爆料,OpenAI内部正在秘密测试代号为"Bell"的前沿实验模型。泄露信息称,Bell在多个高阶推理与自适应环境下的能力指标显著超过了当前的GPT-6 Astra,被外界视为下一代架构的关键预研分支。
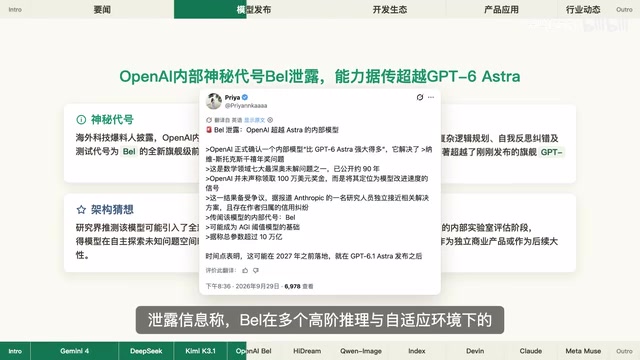
需要说明的是,Bell目前仍属于单一来源的泄露信息,尚无官方确认。但从命名和定位看,OpenAI显然没有停下在基础架构层面的探索,下一代能力竞赛的火药味已经相当浓厚。
视频与图像生成:开源方案持续加速
生成式媒体领域同样有看点。HiDream开源的图生视频模型HiDream O Video 1.0在LMSIS视频竞技场拿下1456分,位列榜单第7名。其亮点在于动作连贯性与物理规律真实感表现优异,同时具备极高的单卡推理能效比——这意味着普通开发者也能以较低成本跑起来。
针对刚发布的Qn Image 2.1,Vigo团队推出并开源了Vigo Turbo加速方案。通过全新的蒸馏技术,生成步数从40步压缩到6步,且不需要额外的CFG引导计算,端到端生成速度提升最高达5倍。
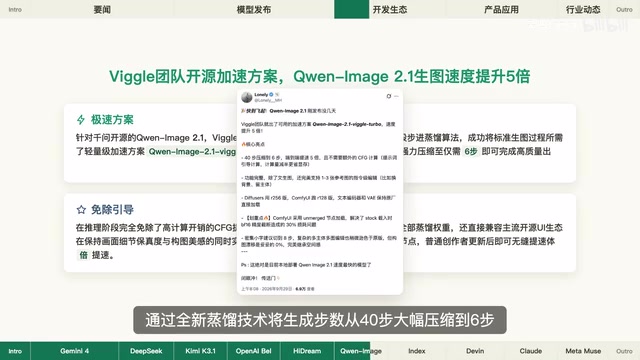
步数压缩加上去CFG,这类优化在实际部署中直接关系到推理成本和响应速度,是把前沿模型推向规模化应用的关键一环。
CFG(Classifier-Free Guidance,无分类器引导)是扩散模型生成高质量图像/视频的常见技术手段:每一步去噪时需同时运行"有条件"和"无条件"两次前向传播,再用两者的差值来增强生成结果与提示词的契合度。这意味着开启CFG后,每步推理的计算量实际上翻倍。Vigo Turbo通过蒸馏让学生模型在单次前向传播中内化CFG的引导效果,从而在去掉额外CFG计算的同时还把步数从40步压缩到6步,两项优化叠加才产生了最高5倍的端到端加速。对于需要大规模批量生成的商业场景,这直接意味着同等算力下吞吐量的数量级提升。
AI工程师与浏览器Agent走向落地
Cognition宣布对其AI软件工程师Devon进行重大底层架构升级。得益于全新的推理调度与代码缓存机制,Devon在Fusion与标准模式下的调用成本下降了30%到40%,在Devon R上的最高降幅甚至达到70%。成本的大幅下降,意味着AI编程助手的商业可行性正在快速提升。
Anthropic则正式宣布,Claude的Chrome浏览器扩展向所有付费订阅用户全员开放。该扩展深度整合浏览器侧边栏,不仅能理解并总结当前浏览内容,还能在网页中自主执行数据采集、表单填写等多任务操作。浏览器Agent从演示走向真实用户手中,是AI从"对话"迈向"行动"的一个标志性节点。
浏览器Agent是指能够在真实网页环境中自主感知页面内容、执行点击、填表、数据抓取等操作的AI代理,区别于仅在对话框内回答问题的传统助手。其技术难点在于网页结构千变万化,模型需要实时解析DOM树或截图,并在多步骤任务中保持状态连贯、避免误操作。Anthropic将Claude的浏览器扩展从演示推向付费用户,标志着该方向进入规模化验证阶段——真实用户的使用数据将极大加速模型在网页操作可靠性上的迭代,也为"人机协作"从信息问答向任务执行的跃迁提供了重要的商业化路径参考。
消费端:Neta的Mios刷新增长纪录
在C端应用层面,Sensor Tower最新数据显示,Neta推出的AI助手Mios上线仅22天,在美国App Store的下载量就突破500万次,增长速度超越了当年的ChatGPT,并已连续12天稳居美国免费下载榜首位。
一款AI助手能在美国市场跑出这样的增长曲线,说明消费级AI入口的争夺远未尘埃落定,后来者依然有机会撬动用户。
总结观察
从这一天的密集动态可以看出几条清晰主线:旗舰模型的"跑分-实战"落差提醒行业回归真实可用性;国产厂商在Agent工具链和垂直本地化上持续补位;开源生态在视频、图像生成的推理效率上狂飙;而AI编程与浏览器Agent的成本下降和落地,正把"AI替人干活"从概念推向日常。竞争的焦点,正从单纯比参数,转向谁能真正解决用户的实际问题。
相关推荐
我让Claude构建可漫步的物理精确O'Neill圆柱:AI生成3D模拟的边界
我让Claude构建可漫步的物理精确O'Neill圆柱:AI生成3D模拟的边界
一位开发者让Claude构建物理精确、可实时漫步的O'Neill圆柱太空栖息地模拟。本文解析其中的科里奥利力、重力梯度等物理挑战,以及AI生成交互式3D模拟的现实意义与局限。

破解数据锁定:用REGISTER与UNREGISTER API实现目录可移植性
湖仓架构下,开放表格式解决了存储可移植性,但目录锁定成为新难题。本文解析REGISTER与UNREGISTER API如何实现元数据松耦合,帮助企业避免厂商绑定、支持多目录协作并安全迁移数据。
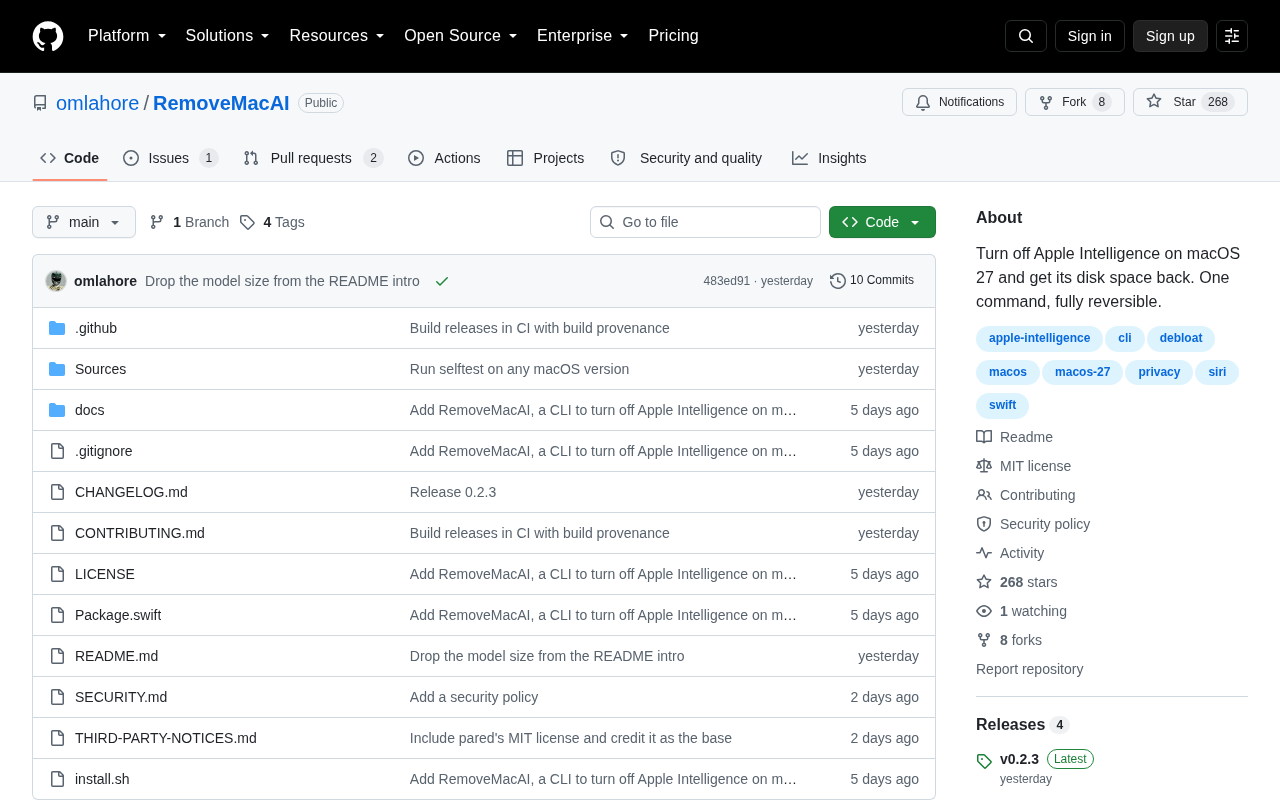
macOS 27 AI模型清理工具:如何移除与禁用Apple本地AI
一款登上Hacker News热榜的开源工具可移除和禁用macOS 27中的Apple本地AI模型,帮助用户释放磁盘空间、节省资源并提升隐私可控性。本文解析其工作原理、风险与背后的用户诉求。