Gemini 4 Carbon登场:大模型竞赛进入百万上下文与万亿开源时代

谷歌、Anthropic、OpenAI与开源阵营同步升级,大模型竞争转向体系化组合比拼。
本文梳理了新一轮大模型发布潮:谷歌推出Gemini 4 Carbon并同步发布多智能体协同工具Swarm,Anthropic以百万上下文的Fable 5.2与Mythos 5.2双模型路线切入,OpenAI则推出最高风险准备度的安全专版GPT-6 Cyber。开源侧,Mistral开源万亿参数Mistral Large-4,月之暗面开源2.8万亿参数的Kimi K3.1 Pro完整权重,Meta推出轻量模型Muse Amber 1.0。文章指出,竞争门槛已从参数规模转向上下文长度、开放策略、定价结构与垂直场景能力的组合比拼,选型复杂度上升但工具面同步扩大。
谷歌的Gemini 4 Carbon、Anthropic的百万上下文双模型、OpenAI的安全专版GPT-6 Cyber,以及Kimi K3.1 Pro的万亿开源权重——这一轮更新几乎把大模型竞争的所有维度同时推高。据B站AI早报的梳理,前沿模型的发布节奏正在从"单点突破"转向"体系化压制"。
前沿闭源模型的三种打法
谷歌:Ultra专享与多智能体协同
Gemini 4 Carbon被谷歌定位为最强前沿模型,率先面向Ultra订阅用户开放,同时给出的付费API优惠是百万输入2美元。更值得关注的是同步推出的多智能体协同工具Swarm,支持组建并行验证的开发团队。这个组合意味着谷歌把模型能力与工程化协作绑定在一起——模型本身不稀奇,如何让多个智能体并行工作、互相验证,才是开发者真正需要的基础设施。
多智能体协同(Multi-Agent Collaboration) 指多个具备独立推理能力的AI智能体分工协作、并行完成任务。与单模型串行推理不同,多智能体系统通常包含规划者、执行者、验证者等不同角色,通过消息传递与结果汇总实现任务分解与交叉校验。谷歌Swarm这类工具的核心价值在于编排层:它负责调度各智能体的并行执行、处理冲突与依赖关系,并把验证结果反馈给主控代理。这一架构在复杂软件开发、漏洞审计、科研假设验证等场景中可显著降低单点错误率,但也带来通信开销与一致性维护的新工程挑战。
Anthropic:双模型路线与超长上下文
Anthropic推出Fable 5.2与Mythos 5.2两款模型,同源共架构,全系原生配备100万Token上下文窗口与12万8千Token最大输出。开放策略上做出了明确切分:Fable 5.2面向企业与开发者全量提供,放宽科研与网安限制的Mythos 5.2则仅限合规认证机构受邀使用。价格层面,Fable 5.2输入输出定价较GPT-6 Astra低约两成,缓存低至两毛美元,生成速度提升三成。这是一个很清晰的信号——在不牺牲上下文长度的前提下,用定价和速度换市场份额。
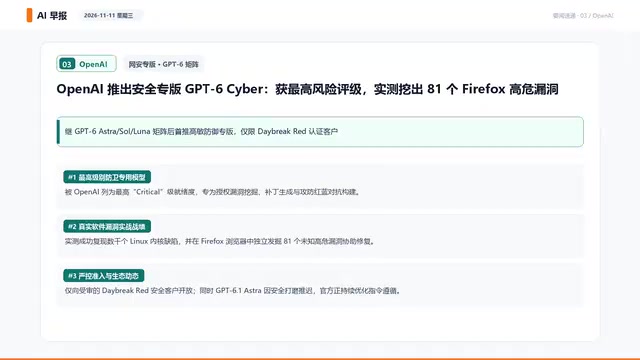
Token上下文窗口是模型单次可处理的最大文本量(输入加输出)。100万Token约相当于70万至80万英文单词,或数本长篇专著、数个中型代码仓库的规模。上下文越长,模型越能一次性完成跨文档比对、长代码库理解等任务,无需依赖检索增强(RAG)切分。但长上下文对显存、注意力计算复杂度与推理成本提出更高要求,业界常以稀疏注意力、分块缓存等技术缓解。Anthropic全系原生配备百万窗口,意味着其架构与推理栈在设计阶段就针对长序列做了优化,而非外挂式扩展。
OpenAI:向安全垂直场景纵深
在GPT-6 Astra、Soul与Luna家族之后,OpenAI推出GPT-6 Cyber,并将其定级为最高风险准备度。这个专版专为授权漏洞挖掘与红蓝对抗打造,实测复现数千个Linux内核缺陷,并在火狐浏览器中独立挖出81个未知高位漏洞协助修复。目前仅限Daybreak Red认证安全客户使用,官方也在加速打磨GPT-6.1。把能力最强、风险也最高的模型交给受认证的安全团队,是OpenAI在能力释放与风险控制之间找到的一条折中路径。
风险准备度(Preparedness)分级是OpenAI用于评估模型在生物、网络安全、化学等高危领域潜在滥用风险的内部分级框架。等级越高,代表模型在相关领域的实际能力越强、被滥用的潜在后果越严重。被定级为最高风险准备度,通常意味着模型在网络攻防、漏洞挖掘等方面已具备接近专家级的实操能力,因此必须配套更严格的访问控制、使用监控与客户资质审核。GPT-6 Cyber仅向认证安全客户开放,正是这一分级体系在发布策略上的直接体现。
开源阵营的双线推进
Mistral与Meta的不同取舍
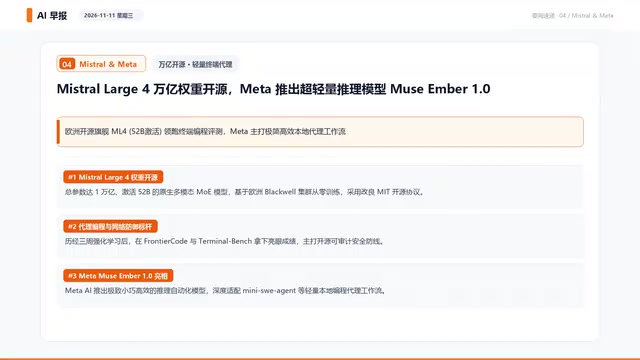
Mistral AI正式开源万亿参数原生多模态模型Mistral Large-4,推理激活520亿参数,在欧洲Blackwell集群训练,采用改良MIT协议开放。强化学习精调后在终端编程评测表现亮眼。Meta则推出超轻量高效推理模型Muse Amber 1.0,体积小巧却专为开发自动化而生,可流畅驱动轻量级本地编程代理。一个追求规模上限,一个压低部署门槛,开源生态的分工正在变得清晰。
月之暗面:Kimi K3.1 Pro完整权重开源
月之暗面在Hugging Face开源旗舰模型Kimi K3.1 Pro完整权重,总参数2.8万亿,激活1040亿,搭载稀疏注意力与百万窗口,首日获VLM支持并接入微软平台。完整权重开放加上百万级窗口,对想做大上下文应用的团队来说,这是目前少有的可直接落地的选择。阿里方面,官方账号发出四字预告"The Becoming Begins",结合竞技场盲测信号,QN4的揭晓已经不远。
总参数与激活参数是混合专家(MoE)架构中的一对关键指标。总参数指模型全部专家权重之和,激活参数指单次前向推理实际参与计算的参数量。Kimi K3.1 Pro总参数2.8万亿而激活仅1040亿,意味着每次推理只调用约3.7%的参数,在保留大模型知识容量的同时大幅降低单次计算量。稀疏注意力则进一步让模型在百万级窗口下只关注部分相关位置,控制长上下文的计算开销。完整权重开源则允许研究者和企业自行部署、微调与审查,与仅开放API形成鲜明对比。
算力生态与实体智能
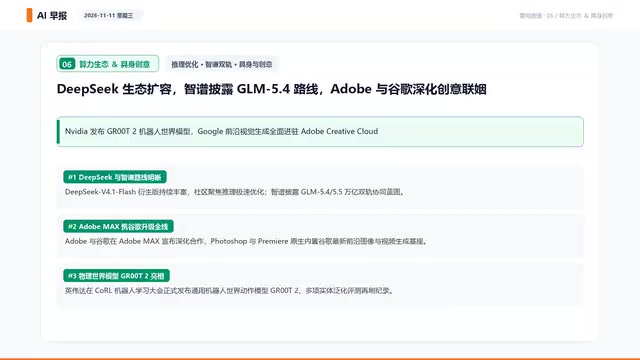
国内方面,DeepSeek广告 V4.1 Flash持续涌现极速推理优化衍生版,智谱正式披露万亿参数GLM 5.4与5.5双轨路线,强化AutoGLM代理能力。海外方面,Adobe与谷歌在Adobe Max宣布深化合作,将前沿视觉生成全面引入PS与相关产品线;英伟达在Core大会发布机器人世界动作模型GRM,加速推进具身智能落地。
从仅限Ultra开放的Gemini 4 Carbon,到百万上下文的Claude双子星,再到万亿开源权重与具身智能的突破,可以看到一个共同趋势:竞赛的门槛不再只是参数规模,而是上下文长度、开放策略、定价结构和垂直场景能力的组合比拼。对开发者和企业而言,选型的复杂度在上升,但可用的工具面也在同步扩大。
相关推荐

Cursor、Devin、TRAE、Copilot价格怎么比?先算额度再比月费
横向对比Cursor、Devin Desktop、TRAE、Copilot四家AI编程工具的个人与团队定价,拆解额度规则、第三方模型是否含在月费、超额计费方式,并给出付费前测消耗、设支出上限和选型的实操方法。

Copilot下架三款模型:Pro用户替代选择只剩一个
GitHub Copilot 自 11 月 16 日起下架 Claude Opus 4.8、Claude Opus 5、GPT-5.6 Tera 三款模型,覆盖 Chat、代码补全与 Agent 模式。Pro 用户三个替代中仅剩 GPT-6 Luna 可用,年付 Legacy 计划拿不到 Opus 5.5,管理员需手动开启替代模型。
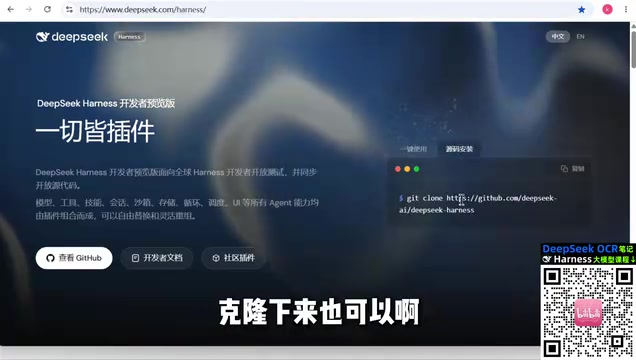
DeepSeek Harness是什么?模型外的一切工程层
DeepSeek Harness是什么?本文从马具隐喻切入,讲清Harness是模型之外的工程系统,涵盖提示词、工具调用、记忆、沙箱、编排等要素,并解析其一切皆插件的开源架构思路与四种运行模式的意义。