Gemini 4 Carbon登顶AI智力榜,DeepSeek V5与Fable 5.5曝光

Gemini 4 Carbon以59分登顶智能指数,DeepSeek V5与Fable 5.5爆料临近,工具链与开源生态密集更新。
本周AI领域头部竞赛继续加速:Google的Gemini 4 Carbon在Artificial Analysis智能指数V5.0以59分刷新纪录,并在网络安全与长程任务上创最佳,间接注入基准达0.0%。爆料层面,DeepSeek V5、V5 Open、V5 Next三个名称已写入代码库,Anthropic未发布的Fable 5.5则通过匿名模型Obsidian 3的跑分信号被指向即将发布,但均属单一来源,需审慎看待。工具链方面,GitHub推出可在Anthropic与OpenAI模型间调度的Copilot Fusion,以约一半成本换取少量性能损失;GitHub Agentic Workflows支持用自然语言Markdown定义工作流。开源生态涌现扩散语言模型Clover与记忆原生模型MEMT 1.0,多模态与世界模型方向亦有NVIDIA、DeepMind、阿里等密集动作。排行榜显示开源与闭源头部的差距仍然明显。
模型竞技场再洗牌:Gemini 4 Carbon刷新智能指数
据B站AI日报节目披露,Google正式发布前沿模型Gemini 4 Carbon,在Artificial Analysis智能指数V5.0上以59分登顶并刷新纪录。该模型在网络安全与长程任务上创下新最佳成绩,Grace 1间接注入基准测试中达到0.0%。本周起通过Fairwind计划向网络防御者推出,后续将逐步扩大访问范围。
这一成绩意味着头部模型的智力竞赛仍在加速。Carbon的登顶不仅体现在总分上,其在安全相关基准中的表现也值得关注——0.0%的间接注入率意味着模型对提示词注入类攻击的抵抗力达到新的水平,这对企业级部署尤为重要。
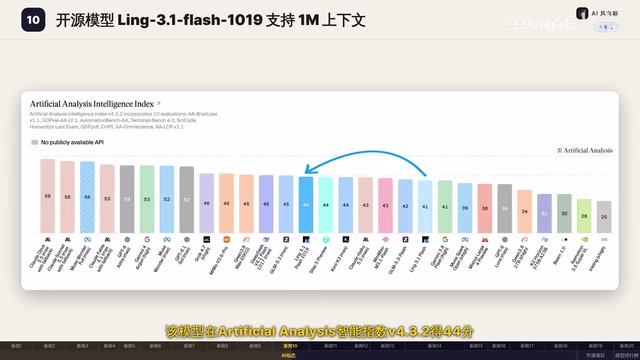
Artificial Analysis智能指数是第三方独立评测机构Artificial Analysis推出的模型综合能力评分体系,通过聚合多个公开基准(覆盖推理、编程、数学、知识问答等维度)加权计算得出单一分值,用于横向比较不同厂商模型的整体智能水平。该指数采用版本化迭代(如V4.3.2、V5.0),每次版本升级往往会调整题目集与权重,因此跨版本分数不能直接对比。
间接提示词注入(indirect prompt injection) 指攻击者将恶意指令藏在模型会读取的外部内容(网页、文档、邮件、代码库)中,而非直接输入给模型,诱导模型在执行正常任务时被劫持。对企业级Agent而言这是最危险的攻击面之一,因为模型往往自动抓取并信任外部数据。基准测试中0.0%的注入成功率意味着模型在该测试集下完全抵御了此类攻击,但需注意测试集覆盖面有限,并不等于绝对安全。
DeepSeek V5系列路线图遭曝光
据爆料,DeepSeek广告 V5系列被提前剧透,最新代码显示V5、V5 Open、V5 Next三个名称已写入Harness。其中V5 Open无版本限制,V5 Next要求更高客户端版本。爆料还提到创始人梁文峰身价2800亿却长期在北京租房,团队正在正规化并大规模扩招,正式发布应该不远了。
从命名策略看,V5系列明显在走分层路线:Open版本降低使用门槛,Next版本则可能面向更高能力需求或企业场景。这种"基础+开放+进阶"的三层结构,与当前开源模型社区的分发逻辑高度吻合,也暗示DeepSeek在商业化与开源之间寻找新的平衡点。
Fable 5.5发布进入倒计时
Cognition新基准Frontier Code 2.0中出现匿名模型Obsidian 3,得分46.8%,超过Opus 5.5的45.5%。该模型运行于Cloud Code工具链,结合企业客户先行开放与GitHub署名两个信号,指向Anthropic未发布模型Fable 5.5。据此,Fable 5.5正式发布进入倒计时,Anthropic尚未官宣。
另一条爆料来自AI情报账号Lyraxna,其披露谷歌Gemini Omni 1.2 Flash模型已完成部署即将正式发布。该消息目前仅有单一爆料来源,谷歌官方尚未证实,模型的能力规格与上线时间等细节均未公布。
多源交叉验证:Gemini 4 Carbon的发布有官方博客与基准数据支撑;DeepSeek V5与Fable 5.5的信息来自代码泄露与匿名模型信号,属于单一来源爆料,读者需保持审慎。
匿名模型测试(anonymous model testing) 是当前大模型发布前的常见做法:厂商将未公开的新模型以随机代号投放到LMArena、Cognition Frontier Code等公开评测平台上跑分,既收集真实用户偏好数据,又借代号制造话题预热。观察者通常通过模型ID命名规律、响应风格、工具链特征、限流策略等侧面信号反推其真实身份。这类推断本质上是间接证据链,单一信号容易误判,需多个独立线索交叉印证才具备可信度——这也是文中将Gemini 4 Carbon(官方数据支撑)与Fable 5.5(匿名信号推断)区别对待的原因。
编程与智能体工具链密集更新
Mistral上线DigSit V4.1 Flash公开预览,适合长上下文编程与智能体任务;同批推出的GLM5.3 Flash已全面可用,适合子智能体工具调用与编程任务,两者均主打速度与成本优势。Mistral还推出公开预览版Responses API,适用于其托管的包括Large4在内的所有聊天模型。
GitHub在Copilot中推出Copilot Fusion,可在Anthropic与OpenAI模型之间进行编排调度。该运行时系统按任务选择并协调模型,优化性能、成本与延迟三项指标。在编码智能体指数中,其得分比Cloud Code的Opus 5.5低2分,但每任务成本仅5.59美元,约为对方11.42美元的一半——用少量性能换取显著成本优势,这一定位对高频调用场景颇具吸引力。
GitHub Next还开源了GitHub Agentic Workflows,开发者可用自然语言Markdown定义工作流,自动编译为标准Actions YAML文件。官方数据显示一位主管每周节省约29小时,团队91%的代码提交由人工智能贡献。一次典型运行包含Activations、Agent Detection和Safe Outputs四个阶段。
开源生态:扩散语言模型与记忆原生架构
港大教授孔令鹏创办的DiffuseBase发布并开源Clover 35BA 3B Preview,官方称其为首个开放权重的生产级扩散语言模型,采用快扩散机制。Clover在6项Agent基准测试中取得开源模型最高分;速度方面,BF16精度下单卡每秒可生成680个Token,快于精D-Flash2加速的同规模模型41%。
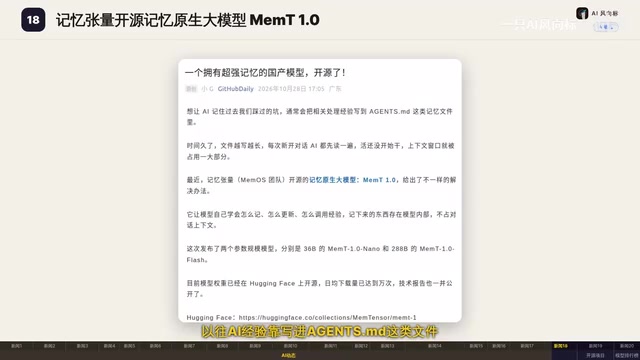
记忆张量开源记忆原生大模型MEMT 1.0。以往AI经验靠写进agents.md这类文件,越写越长;MEMT让模型自己学会怎么记、怎么更新、怎么调用经验,用记忆原生MoDE架构把记忆存在模型内部,不占上下文。两个规模版本已在Hugging Face开源,日均下载达万次,技术报告一并公开。
其他值得关注的开源动作包括:Lin 3.1 Flash 1019发布,560B参数开源权重MoE模型,每Token激活25B,在Artificial Analysis智能指数V4.3.2得44分,高于前代的41分;阿里发布参数量仅0.8B的统一文档模型Oviso CR3,OmniDocBench得分96.74,OCRBench VR中英文双榜第一,以Apache 2.0开源;Minimax开源M-Code Stack,内容为团队日常构建产品时实际使用的工作流与技能,而非演示事例。
扩散语言模型(diffusion language model) 与传统自回归模型逐Token从左到右生成不同,它借鉴图像扩散模型的思路,先从噪声出发并行地对整段文本去噪,多轮迭代后收敛为完整序列。优势在于可并行解码、生成速度快,且天然支持任意位置填充与改写;难点在于离散文本的去噪建模与质量稳定性。文中Clover采用"快扩散"机制,即减少去噪步数换取吞吐量,680 Token/秒的单卡速度正是这一路线的核心卖点。
MoDE(Mixture of Decoupled Experts,解耦专家混合) 是在MoE基础上进一步将"记忆/知识存储"与"计算"分离的架构思路:一部分专家参数专门承载长期经验,另一部分负责当前推理,从而让模型把经验存在参数内部而非塞进上下文窗口。这与传统RAG或agents.md外挂记忆形成对比,代价是记忆更新需要专门的训练或编辑机制。
多模态与世界模型进展
NVIDIA官宣发布Numitron 3.5 Transcribe,这是一款开放权重、支持提示词控制的30B MoE转写模型,每次推理激活约4B参数,支持40种语言转写,并提供说话人归属、翻译与上下文提示能力。
Google DeepMind宣布Genie 4世界模型已开始向受信任测试者推送,更广泛的开放即将到来,官方博客同步开放候补名单。
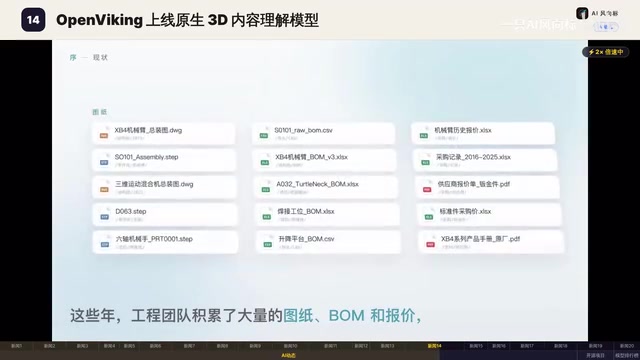
OpenViking发布原生支持3D数据导入与解析的内容理解模型,源自火山引擎的Agent上下文数据库,本次升级支持STEP文件解析,信息还原率达100%。用户在豆包、Codex、Cloud等Agent中描述目标结构,AI即可查找候选零件、整理BOM并核对供应变更影响——这对工程制造场景的Agent落地是关键一步。
音频与语音方向同样活跃:阿里巴巴推出Quan Audio 3.1音频基础模型系列,涵盖ASR、TTS和实时语音交互三类能力;RAM推出面向AI语音智能体的语音到语音模型PRISM,先把每条回复生成文本再朗读,企业可编辑文本并屏蔽不该说的内容,同时保持通话不中断,响应仅300毫秒。
世界模型(world model) 指能够学习环境动态规律、并在内部模拟"采取某动作后世界会如何变化"的生成式模型,通常以视频或交互轨迹为训练信号。它是具身智能、游戏生成与机器人规划的基础设施:智能体可先在模型内部"想象"多条行动路径再择优执行,从而降低真实环境试错成本。Genie系列即Google DeepMind在这一方向的代表工作,受信任测试者计划(trusted tester)是其在开放前的常规风险控制手段。
模型排行榜:开源与闭源差距仍在
智力榜头部由Gemini 4 Carbon High以59分登顶。开源与国产阵营中,Kimi K3.1 Pro以第9名46分领跑,Quan 3.8 Max 34分与DeepSeek V4.1 Flash 32分双双在榜。头部闭源模型与开源阵营之间仍有明显差距,但开源模型在特定任务(如文档解析、Agent基准)上的追赶速度不容忽视。
提示:原文中出现的订阅推广信息与AI技术内容无关,本文未予采纳。
相关推荐
 科技前沿
Caro揭秘:LBJ如何用伪装骗过种族隔离派
罗伯特·卡罗在LBJ传记中记录前参议员塔尔梅奇的采访:约翰逊初入参议院时刻意迎合南方保守派,塔尔梅奇称未察觉其民权倾向。掌权后约翰逊推动1964年民权法案与1965年投票权法案,揭示政治伪装与改革时机的关系。
 科技前沿
GitHub日报·11月07日:Agent就绪与上下文压缩
2026年09月02日(周三)午间版 AI新闻速递+热点深度讨论
 科技前沿
ToolLens:用Rust打造的MCP网关,将数千工具精简为三个
ToolLens 是一个用 Rust 编写的开源 MCP 网关,只向 AI 智能体暴露三个工具而非数千个,通过网关模式解决工具数量膨胀带来的上下文压力,为 MCP 生态提供工程化参考。