Gemini 4 Carbon登顶却仅限网络安全专家使用

Google 发布 Gemini 4 Carbon 登顶多项基准,但因网络安全能力仅限防御组织使用。
Google 在财报电话会议前发布 Gemini 4 Carbon,该模型在 Artificial Analysis 智能指数上以 59 分登顶,领先 Claude Opus 5.5 和 GPT-6 Astra。Carbon 在长上下文(百万 token)、科学推理和代理任务上表现突出,代理任务成本比 Opus 5.5 Max 低 72%。但速度明显变慢,幻觉率从 Argon 的 4% 升至 11%。其网络安全能力(漏洞发现、利用验证、修复编写)创下新纪录,因此 Google 仅向少数防御组织开放,未公布公开日期。定价初期与 Argon 持平,全价后与 Opus 5.5 相同,但 GPT-6 Astra 更便宜。开发者不满于 Google 迟迟不开放访问。
Google 在 AI 竞赛中重新夺回了第一的位置,但几乎没有人被允许使用这款帮助它登顶的模型。它叫 Gemini 4 Carbon,在 Alphabet 季度财报电话会议前大约三小时正式发布,随后迅速登上 Artificial Analysis 智能指数榜首,领先于 Claude Opus 5.5 和 GPT-6 Astra。然而,目前只有一小群网络安全防御组织能够访问它。
性能登顶:多项基准测试领先
在 Artificial Analysis 指数 5.0 版本上,Carbon 得分 59,Claude Opus 5.5 为 58,GPT-6 Astra 为 57,而两周前发布的 Argon 仅为 50。这意味着 Carbon 在两周内提升了 9 分,而该图表上典型模型得分在 42 左右。该指数由九项不同测试构成,Carbon 在艰难推理、科学研究、知识问答和自动化任务四项中获胜。
Google 自己发布的 14 个核心基准测试表中,Carbon 在 12 项中排名第一;在更广泛的 17 项测试中赢得 15 项。在另一个独立排名 Vowels Index 上,它以 70.4% 位居第一。在 Arena 的盲测文本排行榜上,Carbon 达到 1,528 分,位列全球第一。
如此大幅且快速的提升,让递归自我改进(RSI)的讨论重新升温。Google DeepMind 高级副总裁兼首席 AI 架构师在官方公告中写道,研究人员和模型正在“携手加速能力提升”。这句话本身很短,但足以引发外界联想。
Artificial Analysis 智能指数是一个综合性的模型能力排行榜,它通过汇聚多个独立基准测试的结果,为不同大语言模型给出一个统一的可比较分数。该指数的设计目的是减少单一测试带来的偏差,通常涵盖推理、知识、编程、数学等多个维度,并定期更新版本以反映最新的测试方法和模型表现。指数分数越高,代表模型在整体能力上越强。读者在解读 Carbon 的 59 分时,应注意这是该指数 5.0 版本下的结果,不同版本之间的分数不可直接比较。此外,该指数并非官方标准,而是社区广泛参考的第三方评估工具之一。
长上下文与代理能力突出
Carbon 最显著的升级之一是长记忆。它能一次性接收约一百万个 token,相当于约 1,500 页印刷内容,并可读取文本、图像、语音和视频。在一项隐藏跨百万 token 连接并要求模型追踪的测试中,Carbon 得分 96.2%,Argon 为 84.2%,GPT-6 Astra 为 71.8%,Claude Opus 5.5 为 66.8%。
在科学和数学测试 Riemann Bench 上,Carbon 得分 80%,大幅领先。在 HLE Diamond 综合考试中,它以 69% 排名第一,领先 Opus 5.5 一分。在让 AI 在计算机上完成真实科研工作的测试中,它以约 65% 再次领先。
编程一直是 Google 的弱项。在 Terminal Bench 4.0 上,Carbon 从 Argon 的 57.1% 提升到 65.2%,Google 将其列为第一。在 Artificial Analysis 的 Coding Agent 排名中,Carbon 得分 59,仅次于 Opus 5.5 的 62,这是 Google 在该项上最接近的一次。不过 Claude 和 GPT 仍在 Frontier SWE2 和 OS World 等硬核软件工程测试中获胜。
在需要长时间自主运行的任务中,Carbon 优势明显。在模拟经营业务的 Vending Bench 2 中,Carbon 得分是 Claude Opus 5.5 的 1.8 倍。在 Arena 代理排行榜上,它跃升至全球第二,仅次于 Opus 5.5 Max。每个代理任务成本约 1.80 美元,比 Opus 5.5 Max 低 72%。Google 表示,Carbon 曾在内部巨型代码库和底层系统中连续工作数天,遇到死胡同就换方法,直到找到并修复隐蔽 bug。
代理能力(Agentic Capability)是指 AI 模型在无人持续干预的情况下,自主规划、执行多步骤任务并调用工具(如浏览器、代码执行环境、API)的能力。与传统的单轮问答不同,代理任务要求模型具备长期记忆、目标分解、错误恢复和环境交互等技能。例如,在 Vending Bench 2 中,模型需要模拟经营业务,涉及库存管理、定价决策和客户沟通等多轮操作。代理能力的评估通常关注任务完成率、资源消耗和自主性程度,是当前前沿模型竞争的关键领域之一。Carbon 在代理排行榜上的表现和低成本优势,正是这一能力的体现。
速度与幻觉:明显的权衡
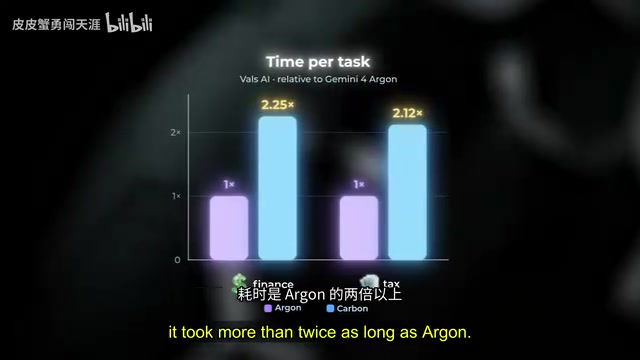
最大的抱怨是速度。测试者表示,根据任务不同,Carbon 比 Argon 慢两到四倍,思考时间也更长。Artificial Analysis 发现它实际上写得更快,约每秒 100 个 token,但话很多:完成测试共产生 2 亿个 token,典型模型仅 6400 万,每个任务平均耗时约 21 分钟。在金融和税务任务上,耗时是 Argon 的两倍多,而金融准确率反而略有下降,从 67.66% 降至 67.16%。在法律研究测试中它获胜,但每个任务平均耗时近 52 分钟,比 Argon 多约 20 分钟。
幻觉问题同样引发争议。在 Artificial Analysis 知识测试中,Carbon 准确率从 48% 升至 58%,但幻觉率从 4% 升至 11%。这意味着在答错的题目中,它编造答案而非承认不知道的比例更高。不过 11% 仍是该图表上最低的,Claude Opus 5.5 和 GPT-6 Astra 都在 50% 左右。在奖励正确答案、惩罚编造答案的综合评分中,Carbon 以 54 比 48 领先 Opus。Google 自己的测试称 Carbon 的无依据声明约为 Argon 的一半,两者测试方式不同,可能同时成立。
安全限制:为何被锁在房间里
Carbon 被限制访问的核心原因是网络安全能力。防御软件需要三项工作:发现漏洞、判断漏洞是否可被利用、编写修复。Carbon 在三项上都创下新纪录:在真实软件中发现漏洞得分 88.2%,证明漏洞可利用性得分 54.8%,编写实际修复得分 71%。Google 表示这些是在没有护栏的情况下测得的原始模型能力。Chrome 团队称 Carbon 编写高质量安全补丁的能力比其他实验室的大型前沿模型强 10 倍以上。
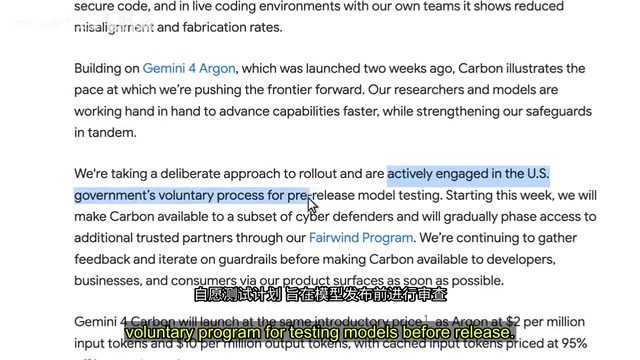
一个既能发现又能利用漏洞的模型,对攻击者同样有用。因此 Google 本周先向一小群网络防御组织开放,然后通过 Fairwind 计划逐步提供给可信合作伙伴,之后再向开发者、企业和普通用户开放,但没有给出具体日期。
Google 在行为方面也做了大量工作。在提示注入测试中,攻击者有 15 次尝试机会,对 Carbon 的成功率为零。Argon 为 0.7%,Opus 5.5 为 1%,GPT-6 Astra 为 8.5%。Google 称 Carbon 为“诚实的模型”:在 Terminal Bench 4.0 上,其成功作弊率降至 0%,尝试率降至 0.4%。与 Google 内部编程团队合作时,严重不当行为警报下降近 80%,越权行为下降 26%,交付不足下降 29%。
提示注入(Prompt Injection)是一种针对 AI 模型的安全攻击方式,攻击者通过精心构造的输入(如隐藏指令或恶意文本),试图诱导模型偏离原始任务,执行未授权的操作或泄露敏感信息。在代理场景中,提示注入的危害更大,因为模型可能调用外部工具或访问系统资源。防御提示注入是模型安全对齐的重要环节,常见方法包括输入过滤、指令层级设计和行为监控。Google 称 Carbon 在 15 次尝试中成功抵御了所有提示注入攻击,这一结果反映了其在安全训练上的投入,但实际部署中仍需持续评估。
定价与市场反应
Carbon 以 Argon 的 introductory 价格发布:每百万输入 token 2 美元,每百万输出 token 10 美元,已缓存内容享受 95% 折扣。促销结束后将升至 4 美元和 20 美元,与 Claude Opus 5.5 定价相同,Google 未说明何时调整。按全价计算,Artificial Analysis 称 Carbon 每任务成本约 7.76 美元,与 Argon 的 7.68 美元基本持平,但得分高 9 分;比 Opus 5.5 的 10.04 美元便宜约 23%;而 GPT-6 Astra 约 6.24 美元,比 Carbon 便宜约 20%。由于输出冗长,Artificial Analysis 仍认为它偏贵,在 51 个模型中成本排名第 45。
Hacker News 上的开发者不满的是,Google 总是急于发布模型却从不给出公开日期,等 Carbon 开放时,OpenAI 和 Anthropic 可能已经推出下一代模型。有人把 Google 比作不断吹嘘女朋友却从不让人见面的家伙。Google 是否真的回来了,可能取决于那扇门什么时候打开。
“Introductory 价格”是云服务和大模型 API 中常见的促销定价策略,指产品在发布初期以较低价格吸引开发者试用,一段时间后恢复为标准价格。这种策略有助于快速积累用户反馈和生态粘性,但也可能导致开发者在价格调整后重新评估成本。对于 Carbon 而言,输入 token 2 美元/百万、输出 token 10 美元/百万的 introductory 价与 Argon 持平,而全价将翻倍至 4 美元和 20 美元,与 Claude Opus 5.5 相同。开发者在规划长期应用时,需考虑促销结束后的成本变化,并结合模型的输出冗长程度(Carbon 产生 token 量远高于典型模型)综合估算实际支出。
相关推荐

AI能直接读懂神经网络权重:模型能力已超出预期?
Reddit开发者实验显示,语言模型能直接阅读神经网络权重并推断其功能。Astra、Opus 5.5和Muse Spark 1.3均通过测试,引发对模型泛化能力与训练来源的讨论。

印度微短剧市场爆发:EloElo获NBCUniversal 8000万美元投资
印度社交娱乐平台EloElo获NBCUniversal 8000万美元投资,加码微短剧平台StoryTV。StoryTV月活超3300万,印度微短剧市场正吸引全球资本关注。

多旋翼无人机声学检测:融合手工特征与预训练嵌入
研究揭示无人机声学检测中随机划分导致数据泄漏,提出源不相交评估协议下融合手工声学特征与YAMNet嵌入的堆叠集成方法,准确率达95.29%,为低成本无人机探测提供可靠基准。