Gemini 4 Carbon登顶智能榜,但编程智能体仍落后Claude Opus 5.5

谷歌两周内再发Gemini 4 Carbon,综合榜登顶但编程智能体仍逊于Claude Opus 5.5。
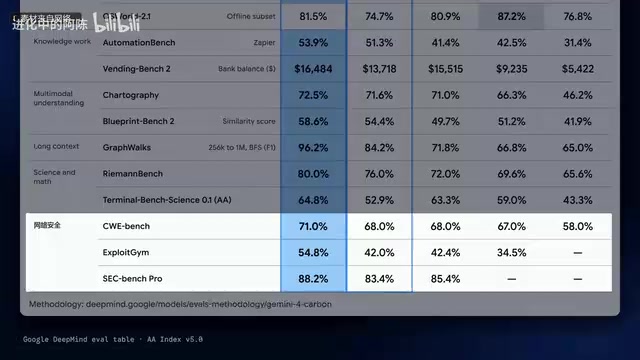
谷歌在Gemini Argon发布仅两周后推出新旗舰Gemini 4 Carbon,以59分登顶第五版综合智能榜,并在高难度推理、科学终端、百科知识和自动化工作流四项单科中拿下第一。安全攻防形成完整闭环,漏洞挖掘、可利用性验证和自动修复得分分别为88.2%、54.8%和71%,间接提示词注入攻击成功率为0。内部17项基准全面超越前代,终端能力从57.1%提升至65.2%。但在编程智能体和电脑操作测试中,Carbon仍落后于Claude Opus 5.5。首发定价输入2美元/百万Token、输出10美元,缓存输入享95%折扣,但折扣截止日期未公布,普通开发者开放时间也未定。
距离上一代旗舰Gemini Argon发布仅两周,谷歌便毫无预警地推出了新模型Gemini 4 Carbon。这种迭代速度让不少圈内人猜测:谷歌是不是已经跑通了“AI训练AI”的自我进化飞轮?
综合榜登顶,但并非全面碾压
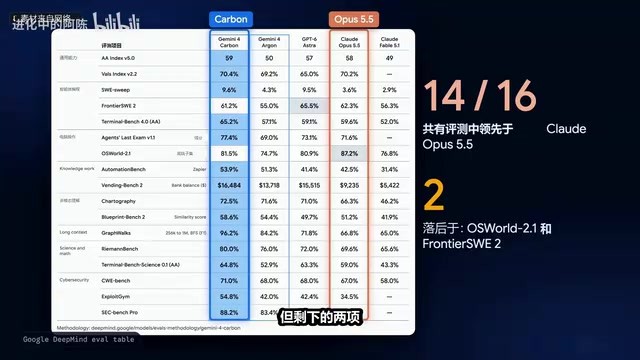
在海外独立机构更新的第五版综合智能榜上,Carbon拿下59分,反超此前排名第一的Claude Opus 5.5,比两周前的Argon高出9分。该榜单包含九项高难度测试,Carbon在四项中拿下单科第一:高难度复杂推理(HLE Diamond)、科学终端评测、全科百科知识库以及自动化工作流基准。
据B站UP主“进化中的阿陈”分析,这四项第一确实展现了Carbon在深度数理逻辑和跨学科推理上的高智商。但总分第一衡量的是综合平均分,并不代表每个单科都稳赢。
HLE Diamond 是“Humanity's Last Exam”(人类最后的考试)基准的高难度子集。HLE 由全球学者共同出题,覆盖数学、物理、历史、法律等数十个学科,题目设计为对当前大模型极具挑战性,旨在测试模型在专家级知识上的推理上限。Diamond 版本进一步筛选出其中最难的题目,并采用更严格的评分标准,因此单科登顶通常被视为模型在深度数理逻辑与跨学科推理能力上的重要信号。
安全攻防是最大亮点,承诺长时间自主运行
谷歌这次最引以为傲的是网络安全攻防的完整闭环。官方公布的数据显示:第一步漏洞挖掘得分88.2%,第二步验证漏洞可利用性得分54.8%,第三步自动打补丁修复得分71%。从发现风险、验证威胁到动手修复,整个安全链条基本跑通。
在间接提示词注入评测中,面对每项攻击15次尝试的严格测试,针对Carbon的攻击成功率显示为0。官方内部团队还透露,Carbon能在后台连续运行数天,专注处理极其复杂的长期工程任务。这种“铜墙铁壁”加“持久作战”的能力,是谷歌此次重点发力的方向。
间接提示词注入(Indirect Prompt Injection)是指攻击者将恶意指令隐藏在模型可能读取的外部内容中(如网页、文档、邮件或工具返回结果),而非直接输入给模型。当模型处理这些内容时,可能被诱导执行非预期操作,例如泄露敏感信息或调用危险工具。该评测要求模型在每项攻击的多次尝试中均不中招,因此“成功率为0”意味着模型对这类隐蔽攻击具备较强的鲁棒性。
内部基准全面超越前代,终端能力提升明显
在官方公布的内部对比表中,Carbon在全部17项基准测试中均超过两周前的Argon。终端能力测试从57.1%提升到65.2%,涨幅超过8个百分点;软件工程清理测试从4.3%翻倍多至9.6%。短短14天能有这样的提升幅度,说明谷歌在模型推理能力上确实下了功夫。
编程智能体赛道:Claude Opus 5.5仍是更稳的选择
不过,把细分科目拉出来看,情况就没那么乐观了。在谷歌官方列出的16项对抗测试中,Carbon拿下14项,但输掉的两项恰恰是当前大模型最核心的生产力阵地。
模拟人类操作电脑的系统测试中,Claude Opus 5.5拿到87.2%,Carbon只有81.5%;更前沿的代码测试Frontier SWE-2上,Opus 5.5同样稍胜一筹。在专门评测编程工具结合模型的榜单上,搭配专用代码工具的Opus 5.5以62分位列第一,Carbon搭配自家代码工具拿到59分,屈居第二——尽管这相比前代的53分已有长足进步。
日常办公和长链路业务分析的知识类任务上,Carbon同样没有占到便宜。在复杂商业与知识工作基准榜单中,Carbon拿到1609分,比Argon的1483分涨了120多点,但依然没有登顶,排在它前面的有国产模型Kimi和马斯克的Grok等。
结论很清晰:如果日常工作高度依赖深度编程智能体和长链路代码工程,现阶段Claude Opus 5.5仍是更让人放心的主力。Carbon真正甩开对手的地方,是宏观复杂长程推理、跨学科理科难题和综合通识能力。
Frontier SWE-2 是面向软件工程的前沿基准,通常模拟真实代码仓库中的多步骤任务,要求模型理解代码库、定位缺陷、修改代码并通过测试。与传统的单函数代码生成不同,它更强调长链路工程能力、工具调用和自主调试,因此常被用来衡量编程智能体在接近生产环境中的实际表现。
定价策略:首发折扣诱人,但窗口期不明
Carbon的首发价相当有吸引力:输入每百万Token 2美元,输出10美元,缓存输入额外享受95%折扣。处理100万常规输入并生成100万输出,首发状态下总费用12美元;若输入全部命中缓存,缓存费用降至0.1美元,加上输出总共10.1美元。相比优惠结束后的标准单价(输入4美元、输出20美元),首发价格直接打了对折。
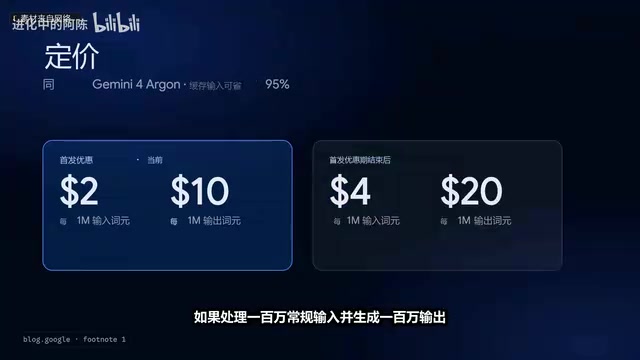
但官方公告的小字显示,这个折扣有有效期,优惠期过后总价会涨到24美元,而截止日期官方并未明确。
缓存输入折扣 是当前大模型 API 常见的计费优化:当请求中的前缀内容(如系统提示词、长文档或对话历史)与之前请求重复时,服务商可复用已缓存的计算结果,从而对这部分输入 token 收取更低费用。Carbon 的 95% 折扣意味着缓存命中的输入成本仅为原价的 5%,对需要反复携带长上下文的应用影响显著。
普通人什么时候能用上?
目前Carbon仅向受信任的网络安全人员开放,下一批将通过合作计划发放给部分企业合作伙伴。普通开发者和个人用户只能得到官方一句“尽快”的回复。公告提到正在接受美国政府的发布前安全测试,这是大厂自愿参加的安全评估流程,并非被监管卡脖子。海外有分析推测可能要等到11月中下旬,但属于民间预测,官方并未定档。
暗流涌动:神秘模型Obsidian-3与未公开的大招
就在Carbon引发讨论的同时,谷歌一位核心工程师在网上意味深长地暗示“未公开的神秘大招还没放出来”。而在评测机构Cognition的后台中,有人发现了一个代号为Obsidian-3的隐藏模型:特定任务开启高算力时得分46.8%,单次任务平均成本8.62美元;作为对照,Opus 5.5满血状态得分45.5%,任务成本12.82美元。有意思的是,当Obsidian-3推到最高满血模式时,得分不升反降到45.5%,单次任务成本却飙到47美元——说明在复杂代码任务中,更高的思考投入未必换来更好成绩。
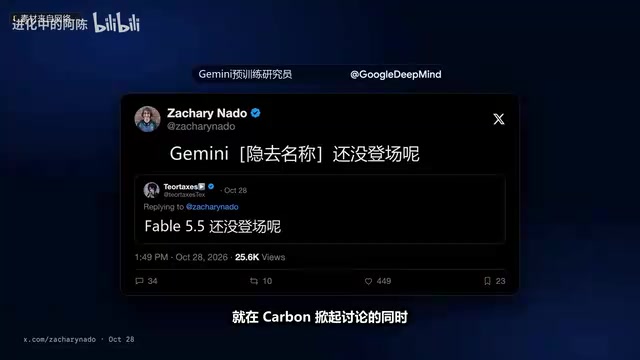
尽管有人猜测Obsidian-3可能是Claude Fable 5.5,但官方并未确认其归属。这波传闻足以说明,各大厂商都在暗地里加紧准备下一波动作。
谷歌用两周时间再次拿出一颗登顶的新旗舰,证明了自身在超长复杂工程和安全攻防上的硬实力。但跑分再漂亮,也得等它真正全面开放到每个人手里,才能知道在真实开发中顺不顺手。面对这场节奏越来越凶残的军备竞赛,你更看好谷歌的高频刷新,还是更习惯用Claude干活?
相关推荐

Cognition SWE-2 实战:一个提示词搞定产品发布全流程
解析 YouTube 创作者用 Cognition SWE-2 发布产品的完整提示词:落地页、七封邮件序列与未购买用户跟进工具三段式结构,以及"测试并汇报"这一约束如何改变 AI 的交付质量。
AWS AgentCore Gateway:用MCP打通AI Agent与企…
AWS AgentCore Gateway:用MCP打通AI Agent与企业后端
AWS AgentCore Gateway如何作为主MCP服务器聚合REST API、Lambda与已有MCP服务?解析其AST实时映射、零冷启动、语义搜索治工具过载、会话隔离与密钥注入安全设计,以及企业AI Agent解耦后端的架构思路。

一个链接给Figma AI装上新技能:MCP连接器实战
通过粘贴一个MCP服务器链接,Figma中的AI Agent就能获得新工具能力。本文拆解配置流程、超过20个一键接入应用、读写权限与执行策略设置,以及公开HTTPS链接这一关键限制。