Gemini 4 Carbon登陆Perplexity:性能对标Claude,成本仅四成
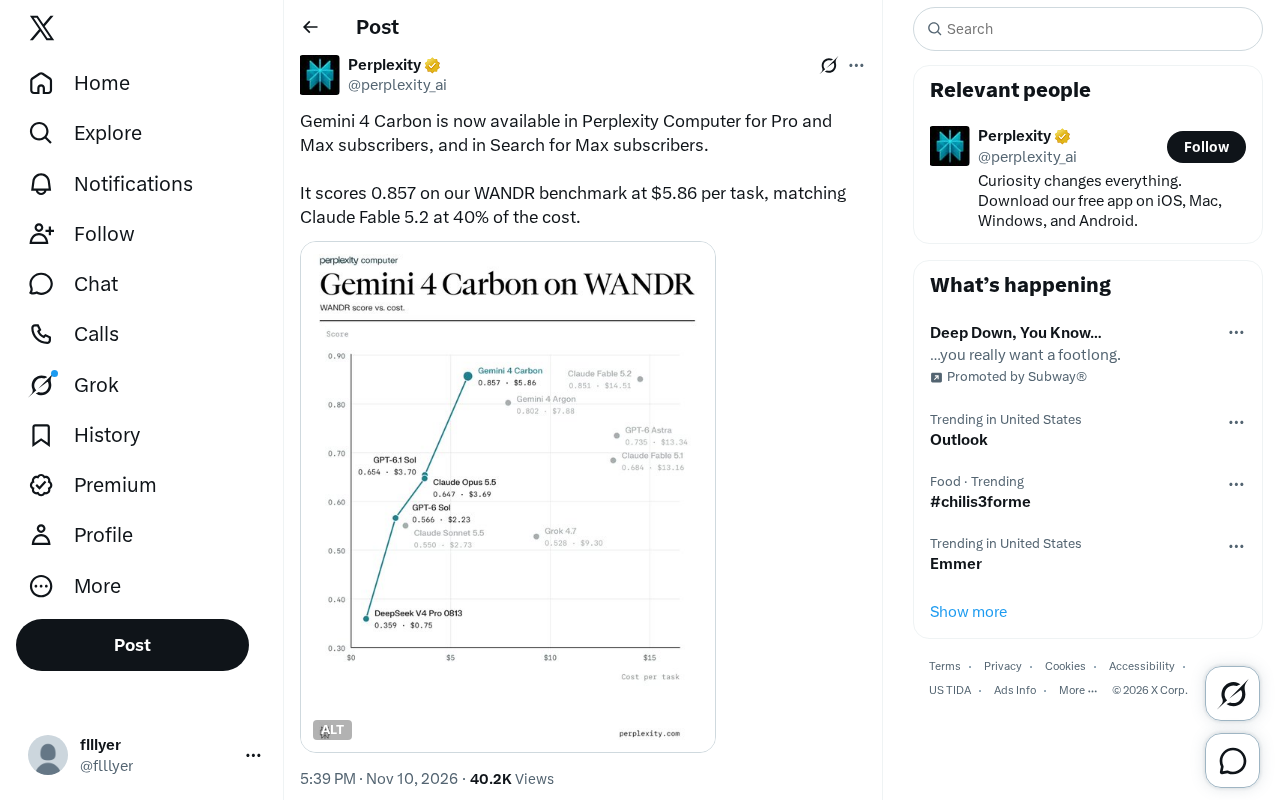
Gemini 4 Carbon上线Perplexity,以成本效率和订阅分层重塑模型竞争力。
Perplexity宣布Gemini 4 Carbon上线其Computer功能(面向Pro和Max用户),Search集成仅限Max用户。官方跑分显示,该模型在自研WANDR基准上得分0.857,单任务成本5.86美元,约为Claude Fable 5.2成本的四成。文章认为,这释放了两个信号:前沿模型进入第三方生产环境加快,订阅层级成为模型能力差异化的调节阀。WANDR作为平台自研基准,结果更宜理解为在Perplexity业务场景下的表现,而非绝对排名。订阅分层则把模型选择权本身商品化,用高频搜索场景拉开Pro与Max的体验差距。对用户和开发者而言,成本效率正成为比跑分更实际的决策变量,但单一来源数据仍需谨慎看待。
从一条推文看模型分发的新节奏
Perplexity 官方账号在 Twitter 上宣布,Gemini 4 Carbon 已正式上线 Perplexity 的 Computer 功能,面向 Pro 和 Max 订阅用户开放;同时 Search 功能中的集成仅限 Max 订阅用户。这条消息本身信息量不大,但它释放了两个值得关注的信号:一是前沿模型进入第三方生产环境的节奏正在加快,二是订阅层级开始成为模型能力差异化的调节阀。
与模型发布本身相比,Perplexity 同时抛出的跑分数据更值得琢磨。
WANDR跑分:0.857背后的成本叙事
Perplexity 给出的对比非常直白:Gemini 4 Carbon 在其自研 WANDR 基准上拿到 0.857 分,单任务成本为 5.86 美元。作为参照,Claude Fable 5.2 在同等测试下分数相当,但成本要高出约 1.5 倍——换句话说,Gemini 4 Carbon 用大约四成的费用达成了持平的分数表现。
这个对比的巧妙之处在于,它没有把讨论停留在"谁更聪明"上,而是把成本效率摆到了台面。对于每天要处理大量查询的 Perplexity 来说,单任务成本直接决定了产品能否在订阅价格不变的前提下扩大用量。这也是第三方平台愿意主动为模型背书的核心动机:跑分好看是一方面,单位经济模型能跑通才是长期合作的基础。
需要留意的是,WANDR 是 Perplexity 自家的评测体系,并非行业通用基准。它的设计很可能偏向 Perplexity 实际业务场景——多步检索、信息整合、答案生成。因此 0.857 这个数字更适合理解为"在该平台关心的任务上表现良好",而不是一个可以横向对比所有模型的绝对排名。
基准测试(Benchmark) 是评估AI模型能力的标准化测试集,通常由一系列任务、评分规则和数据集构成。行业常见基准如MMLU(多任务语言理解)、GSM8K(数学推理)、HumanEval(代码生成)等,其价值在于提供跨模型的可比性。然而,基准测试存在明显局限:任务设计往往反映创建者的业务偏好,模型可能针对特定基准过拟合,且真实场景的复杂性难以被静态测试完全覆盖。因此,自研基准(如Perplexity的WANDR)虽能精准反映平台自身需求,但其结果不宜直接等同于通用能力排名,横向对比时需关注测试任务构成与评分口径是否一致。
订阅分层:Pro与Max的能力边界
这次上线最容易被忽略的细节,是功能的订阅门槛设计。Computer 功能对 Pro 和 Max 同时开放,而 Search 中的 Gemini 4 Carbon 只给 Max 用户。
这种安排说明 Perplexity 正在把"模型选择权"本身当作订阅权益来运营。搜索是 Perplexity 最高频的入口,把更强的模型限制在最高档订阅里,既能拉开 Pro 与 Max 的体验差距,也为 Max 的定价提供支撑。对普通用户而言,这意味着同一个产品里,不同付费层级的答案质量可能出现可感知的差异;对开发者生态而言,则提示第三方模型接入往往会先在高价值场景试水,再逐步下沉。
订阅分层(Tiered Subscription) 是SaaS产品常用的定价策略,通过将功能、用量或服务质量划分为不同档位,满足不同付费意愿用户的需求。在AI产品中,分层维度正从传统的“调用次数”“存储空间”延伸至“模型选择权”“推理深度”等能力参数。这种做法的经济学逻辑是价格歧视:对价格敏感的用户提供基础档,对高价值场景有强需求的用户提供溢价档,从而最大化收入。但风险在于,若低档用户体验明显落后,可能损害品牌口碑;若高档位溢价缺乏可感知的差异,则难以说服用户升级。Perplexity将最强模型限制在Max档,本质上是在测试用户对“答案质量”的支付意愿。
对用户和开发者的实际影响
对 Pro 用户来说,最直接的变化是在 Computer 里可以调用 Gemini 4 Carbon 完成更复杂的多步任务,而不必切换到其他工具。对 Max 用户,Search 结果的生成质量可能因模型切换而出现变化,尤其是在需要综合多个来源做判断的查询上。
对关注模型选型的开发者,这条消息的参考价值在于成本对比的呈现方式。当模型能力差距逐渐收窄,"每任务成本"会成为比跑分更实际的决策变量。Perplexity 用 40% 成本这个表述,实际上是在替用户做一道算术题:在效果接近的前提下,选谁更划算。
当然,单一来源的跑分和成本数据仍需谨慎看待。WANDR 的具体任务构成、Claude Fable 5.2 的测试配置、5.86 美元单价的统计口径,官方都没有展开。在更多独立评测出现之前,这组数字更适合作为方向性参考,而非采购决策的唯一依据。
小结
Gemini 4 Carbon 进入 Perplexity,表面是一次模型上新,实质是平台用成本效率重新定义模型竞争力的一次公开表态。订阅分层让模型能力变成可定价的商品,而 WANDR 跑分则把竞争焦点从"谁更强"引向"谁更划算"。这两条线索,可能比模型本身更值得持续跟踪。
相关推荐
为什么不该在个人电脑上运行Hermes智能体
为什么不应该在个人电脑上运行Hermes等自主AI智能体?本文从安全风险、资源占用、凭证泄露和自主性需求四个角度,分析为何应将智能体部署到独立VPS而非主力设备,并给出隔离部署的实践逻辑。

Ignite 主题演讲:构建前沿生态,让 AI 落地
微软 CEO 纳德拉在 Ignite 开幕演讲中提出构建前沿生态,将 AI 进步转化为现实世界影响。本文解读这一战略背后的生态分层逻辑与落地信号。

微软Ignite大会今日开幕,AI与云成焦点
微软Ignite技术大会今日太平洋时间上午10点开幕,线上直播向全球开发者开放。本文介绍大会看点、AI与云主线以及跟进方式。