Gemini 4 Carbon发布:AI前沿模型剑指网络安全

Google两周内再发Gemini 4 Carbon,综合智能登顶并主打网络安全能力。
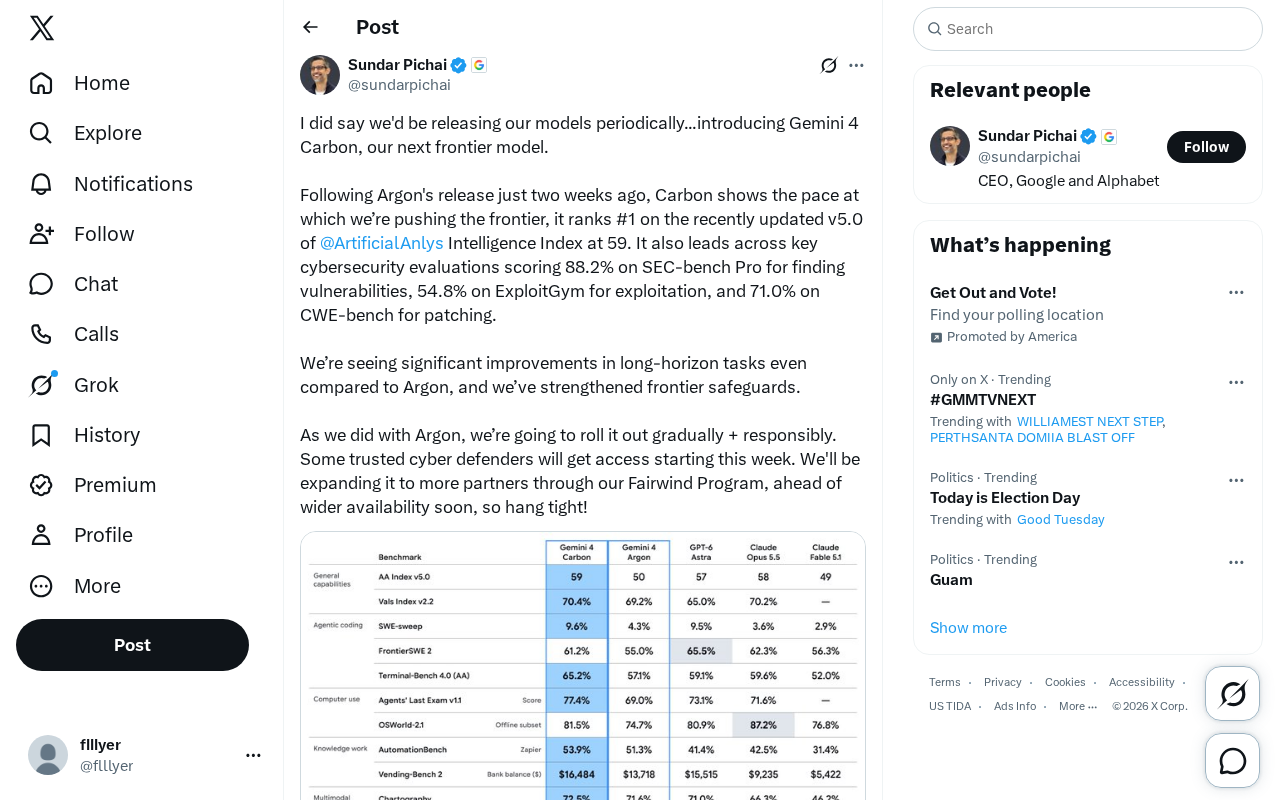
Google在距离上一代模型Argon仅两周后发布Gemini 4 Carbon,官方称其为“下一个前沿模型”,并宣布发布节奏将趋于定期化。Carbon在Artificial Analysis v5.0 Intelligence Index上以59分排名第一,长周期任务能力较Argon显著提升。其差异化优势在网络安全:SEC-bench Pro漏洞发现88.2%、ExploitGym漏洞利用54.8%、CWE-bench漏洞修补71.0%。发布采取渐进策略,先向经过筛选的可信网络防御者开放,再通过Fairwind Program扩大至合作伙伴,最终面向更广泛用户。文章认为这反映AI迭代已从以年、季度为单位压缩至以周为单位,行业需重新审视发布、安全评估与生态建设的节奏。
双子星再进化:Gemini 4 Carbon登场
距离上一代模型Argon发布仅两周,Google再次扔出重磅炸弹——Gemini 4 Carbon。官方在Twitter上高调宣布,这是其“下一个前沿模型”,并强调发布节奏将趋于定期化。从命名到发布速度,都透露出一种紧迫感:AI竞赛的节奏正在以“周”为单位加速。
性能登顶:v5.0 Intelligence Index第一
Carbon最直接的战绩,是在Artificial Analysis最近更新的v5.0 Intelligence Index上拿下第一,得分59。这个指数是业界衡量模型综合智能水平的重要参考,登顶意味着Carbon在推理、知识、编码等通用能力上达到了当前顶尖水准。官方特别提到,即使与两周前的Argon相比,Carbon在长周期任务(long-horizon tasks)上也有显著提升。长周期任务考验的是模型在多步骤、复杂流程中的稳定性和规划能力,这类能力的提升对实际应用落地至关重要。
Artificial Analysis Intelligence Index 是由独立评测机构 Artificial Analysis 维护的模型综合能力排行榜,它并非单一基准,而是把推理、知识问答、数学、编码等多套公开评测的结果按一定权重聚合为一个百分制左右的综合分数。由于不同厂商常引用不同单项 benchmark 制造“第一”的宣传,这类聚合指数提供了横向对比的统一标尺,也因此成为业界引用频率较高的参考之一。所谓 v5.0 版本,通常意味着评测集或权重方法经过了一次较大更新,新旧版本分数不宜直接跨版本比较。
长周期任务(long-horizon tasks) 指需要模型在数十乃至上百个步骤中持续规划、调用工具、记住中间状态并纠正错误的复杂任务,例如跨文件重构代码、多轮调研并撰写报告。它与单轮问答的关键差别在于误差会累积:任何一步的偏差都可能导致后续全盘偏离,因此更考验模型的上下文管理、自我检查和任务分解能力,也是衡量模型能否真正落地为“智能体”的核心指标。
网络安全:Carbon的差异化王牌
如果说综合智能是基础,那么网络安全就是Carbon此次主打的尖刀能力。官方公布了三项关键评测成绩:
- SEC-bench Pro:漏洞发现任务得分88.2%
- ExploitGym:漏洞利用任务得分54.8%
- CWE-bench:漏洞修补任务得分71.0%
这些数字背后,是模型在攻防两端的能力展现。漏洞发现接近九成的准确率,意味着Carbon可以高效辅助安全团队进行代码审计和漏洞挖掘;而漏洞利用得分超过五成,则暗示其在模拟攻击路径、评估风险方面具备实用价值。漏洞修补得分71%则直接指向自动化修复的潜力。
安全防御者的新工具
Google明确表示,Carbon将优先提供给“值得信赖的网络防御者”。从本周开始,部分经过筛选的安全团队将获得访问权限,随后通过Fairwind Program扩大至更多合作伙伴,最终面向更广泛用户开放。这种渐进式发布策略,与Argon如出一辙,反映出Google对前沿模型安全风险的谨慎态度。
文中的三项评测分别对应漏洞生命周期的不同阶段。SEC-bench Pro 属于漏洞发现类基准,要求模型在给定代码库中定位潜在缺陷,得分接近九成说明其静态审计能力已具备实用价值。CWE-bench 以 MITRE 的 CWE(Common Weakness Enumeration,通用缺陷枚举)分类体系为框架,评估模型按缺陷类型给出正确修补方案的能力,是衡量自动化修复水平的常用基准。ExploitGym 则偏向攻击侧,考察模型能否在受控环境中构造可用的利用链,这类基准因涉及双用途能力,通常对访问权限和输出内容有更严格的限制。
需要说明的是,漏洞利用类评测的分数往往被误读为“模型能直接发动攻击”。实际上此类基准多在隔离的沙箱与合成靶场中进行,且厂商通常会对相关能力设置拒答策略或仅向经过审核的安全研究者开放。因此 54.8% 的得分更应理解为风险建模与攻击路径推演能力的量化参考,而非可直接武器化的指标。
Fairwind Program 是 Google 针对前沿模型设立的受控访问计划,性质上类似“可信测试者”机制:通过资质审核的机构可在正式公开发布前获得模型权重或 API 权限,并受使用条款约束。这类计划的设计目标有三:一是在低风险环境中观察模型在敏感能力上的实际表现,二是收集真实工作负载下的反馈用于后续调优,三是建立可追溯的滥用监测通道。对安全团队而言,参与此类计划的收益是提前数月接触新能力并据此调整检测规则与防御工具;代价则是需接受更严格的使用审计。类似的信任圈层式发布,已成为多家前沿实验室在网络安全、生物等敏感领域通行的做法。
渐进式发布:责任与节奏的平衡
“我们会像对待Argon一样,逐步且负责任地推出。”官方声明中的这句话,点明了Carbon的发布逻辑。在模型能力尤其是网络安全相关能力大幅提升的背景下,防止滥用成为首要考量。通过限制初期访问权限,Google可以在受控环境中观察模型表现,收集反馈,同时降低恶意使用的风险。
Fairwind Program作为合作伙伴拓展渠道,此前可能已在Argon的发布中发挥作用。这种“信任圈层”式的扩散方式,既保证了安全,又为后续大规模开放铺平道路。对于开发者和企业用户而言,需要密切关注Fairwind Program的申请窗口,以便尽早接入。
模型迭代加速,AI竞争进入新阶段
Carbon的发布距离Argon仅两周,这个间隔短得令人惊讶。官方直言不讳:“Carbon展示了我们推进前沿的速度。”这背后是AI模型开发范式的转变——从过去以年、季度为单位的迭代,压缩到以周为单位。这种速度对竞争对手构成巨大压力,也迫使整个行业重新思考模型发布、安全评估和生态建设的节奏。
对于用户来说,更快的迭代意味着能更早用上更强的能力,但也带来选择困难和迁移成本。对于安全社区,Carbon的出现既是利器也是警示:当攻击者也可能利用类似能力时,防御方必须跑得更快。
展望:Carbon之后是什么?
Google没有透露下一个模型的名字,但“定期发布”的承诺已经给出明确信号:Carbon只是系列中的一环。随着Fairwind Program的推进和更广泛可用性的到来,Carbon的真实表现将接受市场检验。其在长周期任务和网络安全上的优势能否转化为实际生产力,将是接下来值得关注的焦点。
对于开发者和安全从业者,现在可以做的,是关注访问权限的开放节奏,并提前思考如何将Carbon的网络安全能力融入现有工作流。毕竟,在AI加速进化的时代,早一步行动,就多一分主动。
相关推荐

科幻小说对AI的预测有多准?
科幻小说对AI的预测有多准?本文结合Hacker News讨论,分析科幻作品在AI发展中的远见与盲区,探讨其真正价值在于启发思考而非精准预测。

SwarmEvolve:潜空间智能体集群加速进化搜索
SwarmEvolve框架让数百个低成本智能体在潜空间中集群推理,通过KV缓存共享信息,在数学发现和科学计算问题上实现快速进化搜索,中位数仅3-8分钟达到其他框架60分钟的最佳分数。

trainlint:静态检查揪出不会崩溃的 ML 训练 Bug
trainlint 是一个静态检查工具,能找出不会报错的机器学习训练 bug,包括数据泄漏、eval 模式残留、softmax 与 CrossEntropyLoss 冲突等十四类问题。本文介绍其原理、验证结果与局限。