Gemini 4 Carbon曝光:AI编程竞赛与推理革命

AI竞赛焦点从模型规模转向实用智能,自主代理与深度推理重塑开发范式。
文章拆解了当前AI领域的多则传闻与现实。Google内部测试的Gemini 4 Carbon仅是检查点,编程能力据称匹敌Claude Opus 5.5,但需独立验证;Claude Fable 6与GPT-7仍是未经证实的代号。真正的代际跃升需满足五项标准:多步推理、工具集成、可靠性、上下文记忆与低成本规模化。递归自我改进尚未实现,取而代之的是以牺牲响应速度换取规划与验证的深度推理模式。与此同时,自主AI代理正在改变开发者角色,使其从编码者转向协调多个专业代理的管理者。全球竞争也扩展到本地与云端路线、开源生态、隐私方案与开发者关系的全方位较量。
AI领域的竞争正以前所未有的速度推进。据近期多份未经验证的泄露报告,Google可能在内部测试一款代号为"Carbon"的Gemini 4系列模型,而OpenAI和Anthropic也在各自的赛道上加速奔跑。这些传闻究竟意味着什么?哪些是已确认的工程突破,哪些又只是猜测?本文将逐一拆解。
Gemini 4 Carbon泄露:编程能力成核心战场
根据泄露信息,Carbon在编程任务上表现出色,内部反馈称其水平可匹配Claude Opus 5.5——后者被广泛认为是当前最强的编程系统之一。编程之所以成为AI竞赛的关键领域,是因为它同时考验逻辑推理、语法理解和复杂问题求解能力,是衡量自主AI能力的终极试炼场。
但有一个关键点需要厘清:Carbon是一个内部检查点(checkpoint),而非面向公众的成品。所谓检查点,是模型开发阶段保存的迭代版本。AI公司通常会测试数十个检查点,评估它们在编程、速度、推理等维度的表现,再决定后续方向。泄露信息虽然令人兴奋,但在独立验证出现之前,不宜将其称为新的绝对冠军。
检查点(Checkpoint)在模型开发中的意义
在大型语言模型的开发流程中,检查点指的是训练过程中某个时间点保存的模型权重快照。训练一个前沿模型往往需要数千甚至数万块GPU连续运行数周至数月,工程师不可能等到训练全部结束才评估效果,因此在训练途中会周期性保存检查点,用于回滚、对比和评估。一个模型从初始训练到最终发布,内部可能产生几十个甚至上百个检查点,它们之间的差异可能体现在数据配比、训练阶段(如预训练、监督微调、RLHF)以及超参数上。因此,泄露的检查点性能优异,并不代表最终发布版本会保持同样的水平,也不代表它会以相同形态面向公众。评估检查点通常使用内部基准集,这些基准集与公开的排行榜(如HumanEval、SWE-bench)可能存在分布差异,这也是"泄露分数"需要谨慎对待的原因之一。
Claude、GPT与未来模型:传闻与现实的边界
互联网上充斥着关于Claude Fable 6和GPT-7的传闻,但这些目前仅是未经证实的代号。另一边,Anthropic已确认Claude Opus 5.5正式发布,不仅在性能上表现优异,在运营经济性上也更具优势。
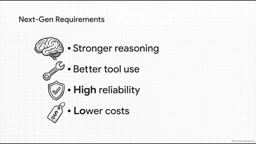
这个对比揭示了一个重要规律:泄露的代号不等于基准测试成绩,更不等于你可以立即使用的产品。一个真正的代际跃升——比如名副其实的GPT-7——需要持续满足五个条件:更强的多步推理能力以拆解复杂问题核心、无缝的工具与浏览器集成、在反复尝试中保持稳定可靠性、长任务中的完美上下文记忆,以及足够低廉的大规模使用成本。
据B站UP主和YouTube频道的交叉分析,这五项标准正逐渐成为业界衡量下一代模型是否合格的共识框架。
AI推理革命:从即时回复到深度思考
关于Google新模型接近递归自我改进(RSI)的说法近期引发热议。RSI被视为AI领域的圣杯——AI能自主构建更聪明的自身版本,从而加速进步。但现实是,当前AI仍在辅助人类研究员,例如编写代码片段、分析论文,尚未能完全自主地重新设计自身架构。
取代真正RSI的,是当前正在普及的深度推理模式。Google传闻中的Ultra模式以及行业内类似的强化思考模式,都要求用户做出一个明确的权衡:放弃毫秒级的即时响应,换取AI用数分钟甚至数小时的计算时间来规划、测试和验证工作,以修复高复杂度漏洞。
递归自我改进(RSI)为何被视为圣杯
递归自我改进(Recursive Self-Improvement,RSI)源自I.J. Good在1965年提出的"智能爆炸"假说:如果一台机器能够设计出比自己更聪明的下一代机器,那么每一代都会加速下一代的诞生,形成指数级的技术跃迁。在当代AI语境下,RSI通常指模型能够自主修改自身的训练流程、架构或数据管道,从而在无需人类介入的情况下持续提升能力。目前业界对此保持谨慎,原因有三:其一,模型缺乏对自身完整训练管线的可见性;其二,架构层面的创新仍依赖人类研究员的直觉与实验;其三,安全与对齐问题在自主改进循环中会被放大。因此,现实中更常见的是"AI辅助AI研究",即模型帮助人类加速实验迭代,而非完全脱离人类闭环。
自主AI代理的崛起:开发者角色转型
在Devin和Codex等专业编程环境中,一种全新的工作流正在形成。真正的AI代理运行在自主循环中:读取问题追踪器、检查代码库、提出迁移方案、直接编辑文件、运行测试,遇到错误时还能读取错误信息并自行修正。
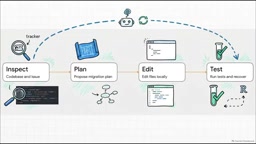
这一变化深刻影响了技术工作的定义。未来的开发者不会消失,而是更像管理者——协调一组专业代理,一个写测试、一个迁移数据库、另一个做安全审查,人类则负责监督架构并审批最终的合并请求。这是一种根本性的范式转变。
全球AI生态系统:本地与云端的路线之争
运行强大的本地模型需要认真的技术对齐:巨大的内存容量、NVIDIA RTX GPU与Apple macOS架构之间的适配,以及通过模型量化压缩模型体积。
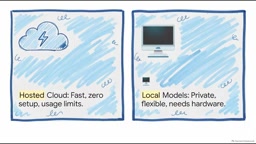
这造成了行业的分化。一端是便捷的托管云工具,例如传闻中的Quen Image 2.1 Turbo,零配置但伴随使用限制和月费。另一端是本地开源权重模型,提供完全隐私和零API费用,但需要昂贵的高性能硬件。
这场全球竞赛远不止于原始智能的比拼,还涉及中国高效的开源权重生态、能记住整个软件架构的长期工作空间工具、各家提供的免费云GPU额度争夺开发者、严格的网络安全审查,甚至包括实验性AI NPC对游戏交互方式的改变。
模型量化:本地部署的关键使能技术
模型量化是指将模型权重从高精度浮点格式(如FP16或BF16)转换为低精度格式(如INT8、INT4甚至更低)的过程,目的是减少内存占用、提升推理速度并降低能耗。对于一个700亿参数的模型,FP16精度下约需140GB显存,而经过4比特量化后可压缩至约35GB,使得单张高端消费级GPU甚至统一内存架构的Apple Silicon设备也能运行。量化的代价是精度损失,可能表现为推理质量下降、长上下文稳定性变差或对边缘案例的处理能力减弱。业界常用的量化方法包括GPTQ、AWQ和GGUF等格式,不同方法在压缩率与质量保持之间各有取舍。这也解释了为何本地部署路线对硬件选型如此敏感:NVIDIA RTX系列凭借CUDA生态和显存带宽占据优势,而Apple的Metal与统一内存架构则在能效比和便携性上形成差异化竞争。
赢得下一个AI时代
最终的胜出者,不会是拥有最聪明的假设性检查点的一方,而是那些立即开始测试这些工具、用代理自动化重复工作流、降低成本并规模化个人产出的人。未来不在于更大的模型,而在于更有用的智能。对话式聊天框的时代已经过去,自主执行者的时代已经开始。
随着这些系统从聊天窗口走入实际开发环境并执行真实操作,谁将构建开发者和企业最信任的生态系统?Google的Gemini 4、Anthropic的Claude,还是OpenAI?这场竞赛仍在继续。
相关推荐

房产经纪人用AI提效的5个实操方法(2026版)
房产经纪人如何用AI提效?结合YouTube实操演示,拆解ChatGPT写房源描述、Canva做营销物料、表单管理开放日线索、Zapier自动跟进、卖家面谈准备5个方法,并提示公平住房法规、照片真实性与定价核实等风险边界。

Grok Bot vs ChatGPT Agent:两大AI代理谁更强?
Grok Bot 与 ChatGPT Agent 有何区别?本文对比两者的工作方式:Grok Bot 拥有云端计算机、可常驻工具内自动执行多步任务;ChatGPT Agent 在浏览器中操作网页,通用任务更成熟。附选型建议。

Walmart Agent Gateway:AI帮你自动购物,亚马逊为何反其道而行?
沃尔玛推出Agent Gateway,允许ChatGPT、Gemini等AI助手直接接入商品库替用户搜索比价加购,并设消费限额与逐笔审批三道安全阀。亚马逊则封堵外部AI代理,两大零售巨头走向相反路线。功能目前仅限美国,印度市场或随后跟进。