Gemini 4 Hydrogen 发布:谷歌新模型性能实测与解析

谷歌发布 Gemini 4 Hydrogen,主打速度、编程与 Agent 执行,并与 Carbon、Argon 分工协作。
谷歌正式发布 Gemini 4 系列,包括 Carbon、Argon 与 Hydrogen 三款模型,其中 Hydrogen 定位为更快、更高效的执行型模型,面向编程、自动化与 AI Agent 场景。在 Artificial Analysis 推理指数上,Hydrogen 略高于 Argon,最高思考档位 Castra High 可进一步提升得分但消耗更多 token;与 CloudSonic 5.5、GPT 6.1 的横向对比中成绩有竞争力,但并非全面领先。谷歌同时公布 Orchestrator 机制,由 Carbon 负责规划、Hydrogen 负责执行,在接近 Carbon 效果的同时降低配额消耗并加快速度。实测中 Hydrogen 可从单个提示词生成 3D 场景、多页演示文稿、电商落地页与记账仪表盘。目前该模型仅向付费用户开放,token 效率优于 Argon。
谷歌近日正式发布新一代模型 Gemini 4 Hydrogen,主打速度、编程与 AI Agent 任务执行。与之一同亮相的还有 Gemini 4 Carbon 和 Gemini 4 Argon,三者定位各有侧重。本文基于公开演示与实测信息,梳理 Hydrogen 的性能表现、谷歌的模型编排思路,以及它在实际任务中的落地效果。
谷歌新模型矩阵:Carbon、Argon 与 Hydrogen 的分工
据 YouTube 频道 AI in Action 的介绍,谷歌此次对 Gemini 4 系列做了明确区分:Carbon 与 Argon 聚焦需要深度推理和长程规划的复杂任务,而 Hydrogen 则被设计为更快、更高效的执行型模型,尤其面向编程、自动化与 AI Agent 场景。
这种分工意味着谷歌不再追求单一模型通吃所有任务,而是按任务类型提供差异化选择。对开发者而言,理解三者的边界比单纯比较跑分更有实际意义。
跑分表现:接近头部模型,但并非全面领先
在 Artificial Analysis Intelligence Index 的推理维度上,Hydrogen 得分略高于 Argon。将 Thinking Level 调至最高档位 Castra High 后,得分进一步提升。需要留意的是,更高思考档位会带来更强的能力,同时也消耗更多 token。
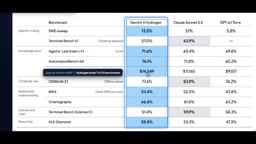
在横向对比中,谷歌将 Hydrogen 与 CloudSonic 5.5、GPT 6.1 放在同一组基准测试里。在软件工程、自动化、Agent 任务、多模态文件理解以及复杂知识推理等测试中,Hydrogen 取得了有竞争力的成绩,部分项目领先于对比模型。
不过 UP 主也指出,Hydrogen 并非每项测试都第一。在部分测试中它落后于对手,但双方差距并不悬殊。这说明 Hydrogen 的定位是强劲竞争者,而非全面碾压。
Artificial Analysis Intelligence Index 是由独立评测机构 Artificial Analysis 维护的模型能力综合榜单,它把多个公开基准(如推理、编程、数学、知识问答等)的得分归一化后加权汇总成一个指数,便于跨模型横向比较。该指数并不等同于真实任务表现,尤其对 Agent 类长程任务覆盖有限,因此行业通常将其作为参考而非结论。文中提到的 "Thinking Level" 指模型可配置的推理深度档位:档位越高,模型在给出答案前进行的内部推理步骤越多,相应消耗的 token 也越多。这类机制让同一模型能在"快而省"与"慢而准"之间切换,是当前推理模型常见的产品化设计。
Orchestrator:谷歌的多模型协作思路
谷歌同步公布了名为 Orchestrator 的机制,运行于 Anti-Gravity 环境内。其核心思路是:面对长任务时不再由单一模型独自完成,而是由一个"管理者"根据任务类型调度下层模型或 Subagent。例如让 Carbon 负责规划、Hydrogen 负责执行。
据谷歌说法,这种编排方式在取得接近 Carbon 效果的同时,显著降低了配额消耗,并加快了执行速度。对团队用户来说,这意味着可以在成本与质量之间取得更好的平衡。
Subagent(子代理) 指在主流程中被动态创建、承担特定子任务的独立模型实例。与简单的函数调用不同,子代理拥有自己的上下文与工具权限,可以独立完成一段工作后把结果交回主代理。Orchestrator(编排器) 则是负责拆解任务、选择模型、分配子任务并汇总结果的上层"管理者"。这种架构的价值在于:规划类任务交给推理强的模型,执行类任务交给快而便宜的模型,从而在整体上同时优化成本与延迟。Anti-Gravity 是谷歌面向开发者提供的 Agent 构建与运行环境,Orchestrator 在其中以平台能力的形式提供,而非需要开发者自行搭建的框架。
实测体验:从 3D 模型到完整网页
UP 主在 Gemini 网页端的 Task 模式中进行了多组实测。第一组是生成农场 3D 场景,要求按动物种类分区并呈现白天效果。Hydrogen 在数分钟内给出了可交互的 3D 模型,动物分区符合要求,细节虽简单但可继续修改。
第二组是制作一份关于"AI 在日常生活"的演示文稿,仅给出主题与大致要求,由模型自行设计版式与配色。结果生成了包含中英双语、图表与配音的多页幻灯片,风格逐页变化。UP 主评价,同样的工作若手工完成耗时会长得多。
第三组是生成时尚电商落地页,要求适配移动端并包含指定配色。Hydrogen 在几分钟内产出了包含商品展示、促销区块、评价与页脚的完整页面,从单个提示词出发的完成度令 UP 主感到满意。
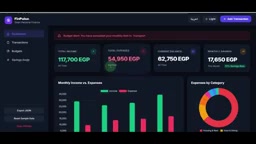
第四组是个人记账仪表盘,要求支持数据录入、收支统计与分类预算。模型自动生成了中英双语界面、深浅色模式、分类图表与交易记录功能,并支持新增交易后实时更新汇总数据。
价格与可用性
Hydrogen 按 token 计费,输入与输出分别定价。目前该模型仅向付费用户开放,使用免费额度或免费方案的用户在 Anti-Gravity 中可能看不到该模型。UP 主本人因只有 Pro 版本,未能测试 Anti-Gravity 内的完整 Orchestrator 体验。
从实测的用量来看,完成上述多组任务后,5 小时窗口内的额度消耗仍处于较低水平,UP 主认为其 token 效率优于 Argon。
按 token 计费 是当前大模型 API 的主流定价方式:输入 token(提示词与上下文)与输出 token(模型生成内容)分别定价,通常输出单价更高。一次 Agent 任务往往包含多轮调用与大量上下文,因此实际成本对 token 效率非常敏感——这也是文中强调 Hydrogen "token 效率优于 Argon" 的实际意义所在。5 小时窗口额度 是订阅制产品常见的限流方式,即在滑动时间窗内限制可用的调用量或 token 总量,超出后需等待窗口滚动或升级套餐。这类限额设计让用户在固定订阅费下获得可预期的使用量,但也意味着长任务的实际可用性取决于单次任务的 token 消耗。
小结
Gemini 4 Hydrogen 的定位清晰:不追求在所有基准上登顶,而是在速度、编程与 Agent 执行上建立优势,并通过 Orchestrator 与 Carbon 等模型形成协作体系。对日常需要快速产出原型、网页或数据看板的用户来说,它是一个值得关注的新选项。
相关推荐

Claude上线协作表格与白板,Anthropic硬刚微软谷歌
Anthropic向付费用户推送Claude Sheets和Claude Whiteboards测试版,支持一句话生成带公式的表格、将口头计划整理成带时间线的协作白板。文章分析其能力边界、编辑可见设计,以及与微软谷歌的正面竞争。

一句话生成表格?Claude Sheets深度体验与避坑指南
Claude Sheets 测试版上手解析:一句话生成带公式和下拉菜单的协作表格,但 100,000 单元格上限与套餐用量限制可能比你想的更早成为瓶颈。附三个业务场景、合规限制与五步避坑清单。

AI Agent编排框架实测评级:谁被高估,谁堪称传奇
一场直白的AI Agent编排框架分级评测:CrewAI与LangGraph为何被封为传奇,OpenAI Agents SDK与Agno为何只算良好,LlamaIndex、Cloudflare Agents为何被指高估,以及TypeScript开发者该选Mastra的理由。