Gemini 4 Hydrogen xhigh实测:一次生成可玩动画,仍逊于Opus

Gemini 4 Hydrogen 默认 high 推理生成游戏功能残缺,切到 xhigh 后可一次成型,但仍不及 Opus 与 Fable。
一位 YouTube 创作者对 Gemini 4 的 Hydrogen 模型做了推理强度对比实测,规则是每个结果只给一次提示词、不做二次修 bug。默认 high 档位下生成的游戏界面可点击、技能能触发,但交互链路断裂、部分能力会莫名消失,被直评为「基本不能用」。切换到 xhigh 后结果截然不同:游戏具备类似 Nexus 的框架,W、E 键对应位移/传送,大招与平滑动画均正常运作,被认为是其测试过的 Gemini 系列最佳结果。不过角色建模依旧奇怪,与 Opus、Fable 差距明显。结论是推理强度提升解决的是功能正确性问题,审美与创意表现并未同步跃升;同时 benchmark 分数可作探索参考,但仍需亲手实测验证。
一个提示词生成的游戏,到底能不能跑?
YouTube 上一位创作者对 Gemini 4 的 Hydrogen 模型做了推理强度对比实测。测试方式很严苛:每个结果只给一次提示词,不做第二轮修复 bug,要求模型「一把过」生成可运行的游戏或交互页面。
结论有戏剧性。同一模型在默认高推理设置下,产出的东西「基本不能用」——界面能点、技能能放,但部分能力会莫名消失,整体极其 buggy。而当推理强度切到 xhigh 后,结果完全变了一个样。
默认 high 推理:能跑,但离能用很远
创作者对 high 推理版本的评价相当直接:straight up doesn't work。它并非完全死掉——鼠标可以点击,角色技能也能触发——但交互链路是断的,用着用着某些能力就消失了。
这个细节值得注意:失败不是「完全没生成」,而是生成了一个表面完整、内里漏洞百出的半成品。对 vibe coding 场景来说,这种失败模式比彻底报错更麻烦,因为它需要人去定位到底哪一环断了。
推理强度(reasoning effort) 是当前大模型 API 中常见的一个可调参数,代表模型在给出最终回答前允许消耗的"思考预算"。它通常体现为内部推理链的长度、采样候选的数量或思考 token 的上限。较低的档位响应更快、成本更低,适合简单问答;较高档位会让模型在生成代码前进行更多自我检查与规划,从而降低逻辑错误率。不同厂商的档位命名并不统一,常见有 low / medium / high,以及在此基础上进一步拉长的 xhigh(extra high)。需要注意的是,推理强度并不改变模型参数本身,它调节的是「想多久」,因此对需要多步状态维护的任务(如游戏循环、技能冷却、碰撞判定)收益最大,而对审美风格类输出影响有限。
xhigh 推理:一次生成,动画丝滑
创作者原本打算放弃,但因为基准测试显示 xhigh 表现优于 Argin,于是给了第二次机会。这次 Hydrogen on xhigh 的结果被评价为「甚至比 Carbon 给出的还好」。
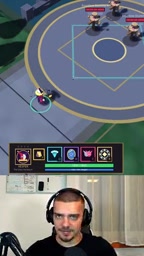
具体表现上,游戏有了类似 Nexus 的框架,技能系统可用,W、E 键分别对应某种位移/传送能力,还有一个大招。创作者特别提到动画「非常平滑」,对整体观感表示喜欢。
vibe coding 指以自然语言描述意图、由模型直接产出可运行代码的开发方式,开发者更多扮演"验收者"而非逐行编写者。它的典型工作流是:一句话或一段描述 → 模型生成完整文件 → 在浏览器或本地直接运行 → 发现问题再追加提示词修补。由于跳过了传统的手写与单元测试环节,一次成型的正确率成为关键指标。也正因如此,"只给一次提示词、不做第二轮修复"是一种有意义的压力测试方法:它能暴露出模型在无人工纠错条件下的真实交付能力,而这类能力直接决定了原型阶段的时间成本。
横向对比:赢了自家兄弟,输给 Opus 和 Fable
把几个结果放在一起看,xhigh 版 Hydrogen 是创作者测过的 Gemini 系列里最好的一个。但它仍有两个明显短板:
- 角色建模依然奇怪,美术表现没有达到可用水准;
- 与竞品差距明显,创作者直言「离 Opus 和 Fable 的结果差得远」。
这说明推理强度提升解决的是逻辑与功能正确性问题,让代码跑通、交互闭环;但审美、角色设计这类偏创意与表现力的部分,并没有随推理强度同步跃升。
文中出现的 Hydrogen、Carbon、Argin 以及 Opus、Fable 均为不同模型或模型版本的代号。在横向评测中,同一家的不同版本往往共享架构与训练数据分布,差异主要体现在规模、后训练策略与推理预算上,因此"自家兄弟"之间的胜负更多反映调优取向;而跨厂商对比则更容易暴露在美术资产、角色建模、动画曲线等偏表现力维度上的系统性差距。这也是为什么同一份提示词下,功能逻辑可以通过提高推理强度补齐,角色设计却仍然明显落后——后者依赖训练数据中的设计先验与多模态生成能力,而非单纯的计算预算。
这次实测透露了什么
第一,推理强度对 Gemini 4 的输出质量影响是数量级的。同一个模型、同一个提示词,high 和 xhigh 之间横跨了「不可用」到「系列最佳」两个档位。开发者如果只试默认档位就下结论,很可能低估了模型的真实上限。
第二,单次提示词生成完整可交互内容仍是有损的。创作者坚持不做第二轮调试,正是为了测出模型的一次成型能力。从结果看,xhigh 已经能交付一个能玩的原型,但离「拿来即用」还有距离。
第三,基准测试排名和主观体验之间存在张力。创作者是在基准分数引导下才回头重试的,而实际体验确实印证了 xhigh > Argin 的说法。这提醒我们,benchmark 分数可以作为探索方向的参考,但最终仍需自己动手跑一遍。
相关推荐
美国空管系统崩溃频发,加拿大模式能否破局?
一次铜缆升级失误导致全美数千航班停飞。Vox分析指出,美国空管系统设备老化、空管员超负荷、FAA年年向国会要钱的经费模式是根源,并以加拿大1996年空管非营利化改革为参照,探讨如何让空管系统摆脱政治博弈、实现长期现代化。

20个博士的AI为何在企业里寸步难行?
OpenAI联合创始人Greg Brockman用“20个博士却无数据访问权”的比喻,揭示企业AI的核心瓶颈:业务上下文与权限护栏缺一不可。本文解读他与Databricks CEO的对话要点及Genie产品的落地思路。

AI数据保留真相:零留存不覆盖整个厂商,两种API设计拆解
零数据留存并非覆盖整个AI厂商,而是针对特定端点。本文拆解两种标准API留存设计,说明各自由谁负责删除数据,并整理开发者应做的六项核查,帮助避免敏感数据误入有留存接口。