Gemini 4 Hydrogen编程实测:更小更强还更便宜
Gemini 4 最小模型 Hydrogen 以低额度和低价反超自家旗舰 Argon。
文章基于一位模型横评创作者用 33 条高难度提示词的实测,评估 Google Gemini 4 家族新成员 Hydrogen。Hydrogen 是三款模型中体量最小、门槛最低的一个,5 美元 Plus 计划即可使用,却在该榜单的 High 档位冲进前十,多项信息显示其表现超过刚发布的 Argon。更引人注目的是订阅额度消耗:跑完 33 条提示词仅用掉 15% 周额度,而 Argon 八条提示词就耗尽整周额度。文章同时指出,API 路线下成本依然可观,Google 的真正策略是用订阅补贴换生态留存;X High 档位未超过 High 档且耗时翻倍,暂不推荐。
Google 在 Gemini 4 家族里又添了一名新成员——Hydrogen。继 Carbon 和 Argon 之后,这个名字听起来像化学元素的模型,却成了不少评测者眼中"改变市场格局"的那一个。一位长期在 YouTube 做模型横评的创作者,用自己惯用的 33 条高难度提示词对它做了完整测试,结论是:Hydrogen 不仅在该榜单上冲进前十,而且在订阅额度消耗上出奇地克制。
Hydrogen 在 Gemini 4 家族中的位置
要理解 Hydrogen 的意义,得先看清 Google 对三款模型的定位。Carbon 只对高价企业计划开放,普通开发者基本碰不到;Argon 发布时声量极大,但在该创作者的排行榜上只排到中游;更早的 Gemini 3.8 Flash 已经不再是讨论焦点。
Hydrogen 是三款中体量最小的,价格门槛也最低——不仅包含在他所用的 Pro 计划里,连每月 5 美元的 Plus 计划也能用。按常理,它本该是 3.8 Flash 的继任者,但 Google 在官方基准里直接把它拿去和 Sonnet、Terra 对比,野心明显更大。更关键的是,据 Artificial Intelligence Index 的数据,Hydrogen 的得分甚至超过了刚发布不久的 Argon。
Artificial Intelligence Index 通常指业界用于横向对比大模型能力的综合评测榜单或指数体系(类似 LMArena、Artificial Analysis 等聚合型排行)。这类指数把多个公开基准(推理、代码、数学、指令遵循等)的得分加权汇总,再结合人工盲测偏好排序,给出一个可跨厂商比较的综合名次。它的价值在于绕开厂商自报数据的偏差,但也存在局限:不同基准权重设置会影响排名,且榜单更新往往滞后于模型实际发布节奏。因此文中“Hydrogen 得分超过 Argon”这一说法,应理解为在特定评测口径下的综合表现,而非绝对能力定论。
Antigravity 计划 是 Google 面向开发者的 AI 订阅/开发环境体系,按周度和五小时两个窗口滚动计算用量额度。周额度指一整周内可消耗的总配额,五小时限额则是短期节流机制,用完后需等待窗口重置。Gemini 系列模型在该体系中共享同一个额度池,而 Carbon、Argon 等独立计费模型则单独扣减,这正是 Hydrogen 消耗显得“克制”的制度原因。
订阅额度:Argon 八条提示词就见底,Hydrogen 只掉 15%
这位创作者特别强调自己"不吹模型",只看数字。而 Hydrogen 让他意外的第一点,不是分数,而是用量。
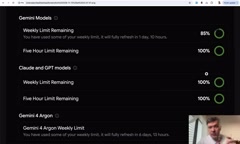
他在每月 20 美元的 Antigravity 计划上测过 Argon:仅 8 条高强度提示词就把整周额度耗尽。而 Hydrogen 被归入 Gemini 模型额度池,消耗极慢。测试开始时他的周额度为 85%,跑完 33 条提示词并放置一夜后,五小时限额已重置,周额度仍剩 70%——也就是说,整个测试只吃掉了 15% 的周额度。
Hydrogen 还是 Gemini 4 系列中第一个支持最新项目模板和 X High 推理档位的模型。测试过程中五小时限额仍在正常刷新,额度始终没有归零。用他的话说,这是 Google 很久以来第一个"在经济上真正划算"的模型。
榜单成绩:High 档位冲进前十
刷新排行榜后,Hydrogen 的 High 档位进入前十,耗时表现也接近前沿模型水平。创作者坦言看到结果时反复核对了日志,怀疑存在少量统计误差,但整体结论站得住。
把档位从 High 降到 Medium,速度大约快一倍,但所有项目的分数都明显下滑。Medium 档的 Hydrogen 大致与 Argon 的 High 档持平,而价格要低得多。这就构成了一个颇尴尬的局面:Google 刚发布的新旗舰,被自家更小、更便宜的模型追平甚至反超。
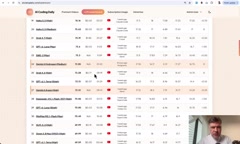
这一点并非孤例。Google 官方承认 Hydrogen 在默认思考级别上超过 Argon;有开发者晒出 Cursor bench 上 Hydrogen High 击败 Argon High 的结果;一位 Google DeepMind 研究员也公开表示"很高兴 Hydrogen 能超越 Argon"。多方信源交叉印证了同一个判断:Google 内部在过去几周里似乎取得了某种突破。
另一个佐证来自 Antigravity 新推出的 Orchestrator 功能——它允许用户切换模型,而官方文档只提到两个名字:Carbon 负责制定架构方案,再交接给 Hydrogen。Argon 在这个组合里已经不再出现。
推理档位(High / Medium / X High) 是大模型提供的“思考预算”开关,本质是控制模型在生成答案前进行内部推理的 token 上限与迭代轮数。档位越高,模型越倾向于展开多步推理、自我检查与回溯,因而在高难度数学、代码和长链逻辑题上得分更高,但延迟和成本也随之上升。Medium 档通常把推理预算压缩一半左右,速度接近翻倍,代价是复杂任务中途放弃或跳步的概率增加。X High 则是把预算推到极致,收益却常因“过度思考”而递减——这与文中 X High 未超过 High、耗时近翻倍的观察一致。
Cursor bench 是围绕 Cursor 编辑器使用场景构建的评测集,侧重代码补全、多文件修改和工具调用等真实开发任务,与通用基准相比更贴近工程实践。它常被开发者用来交叉验证厂商公布的跑分,因此“Hydrogen High 击败 Argon High”的说法具有独立的参考价值。
API 价格才是真正的分水岭
如果不在 Antigravity 里用、也没有 Google AI 订阅,走 API 就是另一套账。Hydrogen 在 Cursor、OpenCode 等工具中都能调用,但官方 API 定价并没有比 Carbon 和 Argon 低太多——Carbon 和 Argon 同价,且属于"介绍期价格",之后会上调。到那时 Hydrogen 的相对优势会扩大,但仍谈不上数量级的便宜。
创作者的实测更能说明问题:在 OpenCode Zen 充值 10 美元后,只跑了榜单上最复杂的三条提示词,前后约 40 分钟,账单就只剩很少余额。换句话说,API 路线下每条高难度提示词的成本相当可观。
这背后的逻辑并不新鲜:Google 正在把用户往自家生态里引。订阅 Antigravity 后,从强到弱的模型一应俱全,用户可能不再需要别家的模型。Grok 在 Cursor 里比 API 便宜,Anthropic 和 OpenAI 的模型在 Cursor 里额度消耗飞快——各家都在用订阅补贴换生态留存。
这位创作者还顺带做了个对照实验:同一个提示词,分别通过 Heapsy 和 OpenCode Go 调用同一个开源模型,Heapsy 版本已经跑完代码生成、测试和迁移,OpenCode Go 还在思考中;换另一个模型对比 OpenRouter,Heapsy 用时更短、消耗 token 也更少,自动化测试结果则完全一致——两家都挂了同样的两个测试。这说明模型托管方对开发体验的影响,有时不亚于模型本身。
Orchestrator(编排器) 是多模型协作机制:由一个“规划模型”负责拆解任务、制定架构与技术方案,再把具体实现步骤交接给“执行模型”完成。这种分工的依据是不同模型在长程规划与代码落地上的能力差异——规划需要更强的全局推理,执行更看重速度与成本。官方文档只列出 Carbon 负责架构、Hydrogen 负责执行,等于用产品设计默认承认了两者的能力互补关系,也间接说明 Argon 在该组合中已无位置。
OpenCode Zen / Heapsy / OpenRouter 属于第三方模型托管与路由服务。它们在同一模型之上叠加不同的推理调度、上下文管理和缓存策略,因此即便底层权重相同,实际速度、token 消耗与任务完成度也可能出现明显差异。文中同一模型在 Heapsy 与 OpenCode Go 上表现分化、自动化测试结果却一致的现象,正说明托管层的工程优化会影响开发体验,但不改变模型本身的能力上限。
X High 档位:暂时不值得等
视频结尾他才提到 X High,因为这一档跑完整套 33 条提示词要花好几个小时。已有数据显示,X High 并没有超过 High 档,部分项目分数甚至更低,耗时却接近翻倍,订阅额度消耗也更大。在数字补齐之前,他的建议很明确:Hydrogen 用 High 档就够了。
小结
Hydrogen 的出现让 Google 在"3.1 Pro 之后拿不出好模型"的调侃中扳回一城。它更小、更便宜、额度更耐用,成绩却压过了自家更大的 Argon。对开发者而言,最现实的问题变成:要不要为了这个模型,花 5 美元或 20 美元进一次 Google 的订阅生态。
相关推荐

OpenAI 11月30日关停Agent Builder等三项服务,开发者需紧急迁移
OpenAI 将于 11 月 30 日关停 Agent Builder、evals 仪表盘和可复用提示三项开发者功能,evals 已转为只读。本文梳理受影响范围、OpenAI 官方给出的迁移路径(Agent SDK、PromptFu、自有代码)以及开发者本周应完成的导出与重建动作。

RankSpot:按次付费的SEO与AI搜索执行层,让Agent替你写文、发布、换外链
RankSpot 是面向 AI Agent 的 SEO 与 AI 搜索执行层,通过 MCP 接入 Claude 或 ChatGPT,让 Agent 完成写文、发布和外链获取。按次付费,每篇文章 3 美元,读数据免费,支持 100 多种语言。

Appxiom:给AI编程助手装上生产环境上下文
Appxiom为AI编程Agent提供生产环境上下文,覆盖崩溃、卡顿、内存泄漏与失败的网络调用,支持Android、iOS、Flutter、KMP和Web,并通过Goal Friction Impact按业务目标排序Bug。