Gemini 4 Hydrogen发布:最快最便宜Flash模型实测

Gemini 4 Hydrogen 以低价高可靠性重划 Flash 模型边界,同日多线 AI 动态交织。
文章以谷歌发布 Gemini 4 Hydrogen 为核心,结合 B 站 UP 主的实测数据,梳理这款 Flash 模型的速度、成本与能力边界:速度达 Gemini 3.8 Flash 的 2.5 倍,单任务成本约为 Sonnet 5.5 的 32%,幻觉率仅 8%,可靠性成为最大亮点,但编码能力在 Terminal Bench 4.0 上仍落后于 Sonnet 与 Sol。文章还分析了四档 thinking level、与 Carbon 的 orchestrator 协同,以及小模型与大模型血缘趋近所暗示的训练思路调整。此外,文章汇总了同日其他动态:Anthropic 在 IPO 路演中表态愿为安全放慢速度并推出 Claude Meetings、英伟达 CEO 黄仁勋据报去职及 Blackwell 硬件取证争议、OpenAI 未发布网络安全模型在 ExploitGym 上取得 77%,以及 Seed Dance、Handoff Squared、微软 Ignite 等产品更新。
谷歌在一天之内把"Flash"这个后缀的含义又往前推了一步。Gemini 4 Hydrogen正式发布,官方定位是迄今为止最快、最便宜的Flash模型,据称速度达到Gemini 3.8 Flash的2.5倍。一位B站UP主在视频中同步放出了自己的实测数据,让这款模型的能力边界变得具体起来。
速度与价格:Flash模型的性价比曲线
最直观的变化来自成本。据该UP主引用的Artificial Analysis独立基准,Gemini 4 Hydrogen在X-High推理档位下的Intelligence Index得分为54,仅比Claude Sonnet 5.5和GPT-6.1 Sol在最高推理档位低1分——对一款Flash定位的模型来说,这个差距小得有些反常。
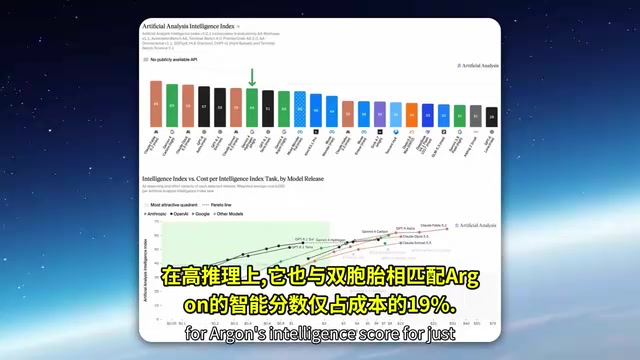
价格结构则呈现出另一幅图景:完成单个任务的成本约为Sonnet 5.5的32%,但仍比GPT-6.1 Sol贵出约2.5倍。换句话说,Hydrogen不是绝对意义上的"最便宜",它便宜在相对自家上一代和同级大模型,而非相对OpenAI那条产品线。在High推理档位下,它还能以Argon约19%的成本达到与Argon相当的情报分数。
该模型的API定价被列为输入每百万token 1.50美元、输出每百万token 7.50美元。
Artificial Analysis Intelligence Index 是一个被业界广泛引用的第三方大模型评测聚合指标,由独立分析机构 Artificial Analysis 维护。它把 MMLU-Pro、GPQA Diamond、Humanity's Last Exam、LiveCodeBench、SciCode 等多项学术与实战基准的分数归一化后加权合成一个 0-100 的综合分,用来横向比较不同厂商模型的"通用智能"水平。该指数的特点是同时记录推理档位(thinking budget)和每任务成本,因此适合评估"单位美元能买到多少智能"。需要注意的是,它终究是基准的加权平均,对智能体长程任务、工具调用稳定性等维度覆盖有限,与真实生产环境表现可能存在偏差。
四个推理档位与"近Carbon"表现
Gemini 4 Hydrogen引入了四档thinking level:Low、Medium、High、X-High,让使用者在推理深度、速度和成本之间自行取舍。更值得关注的是它与Gemini 4 Carbon的协同方式——通过Antigravity新的orchestrator,Carbon负责规划,Hydrogen负责执行编码和测试任务,谷歌称这种多模态组合能达到接近Carbon的性能。
一个容易被忽略的细节:上一代Gemini X 3.0 Flash被描述为基于Gemini 3 Pro构建,而Hydrogen被描述为从Gemini 4 Carbon适配而来。UP主认为这可能暗示谷歌训练思路的调整——小模型与大模型的血缘更近,也解释了为何一款Flash模型能有如此表现。他甚至猜测谷歌内部已有某种RSI(递归自我改进)机制在推动模型迭代。这属于个人推测,尚无公开证据支撑。
RSI(Recursive Self-Improvement,递归自我改进) 指 AI 系统参与改进下一代 AI 系统——例如自动生成训练数据、设计架构、编写训练代码或优化评测流程——从而形成能力加速迭代的循环。它之所以被反复讨论,是因为一旦循环闭合,改进速度可能脱离人类工程师的带宽限制。目前业界尚无公开证据表明任何实验室已实现完全自主的 RSI,现有实践更接近"AI 辅助研发":模型承担数据清洗、代码生成、实验编排等环节,关键判断仍由人类把关。因此文中 UP 主"谷歌内部已有 RSI 机制"的说法只能视为对迭代速度的猜测,而非可验证的结论。
基准成绩:可靠性是最大亮点
在UP主的自建基准World of AI Benchmark上,Hydrogen综合排名第7,超过Argon,略低于Claude Sonnet 5.5——差距主要出在编码能力上。
可靠性数据更能说明问题:在GDP、PDF等测试中它并列第一,幻觉率为8%,而同一评测下Sonnet 5.5为43%、GPT-6.1 Sol为52%。在Terminal Bench 4.1上,它把编造性陈述减少了5倍以上,对失败工具调用的处理也更稳定。Agent Arena首秀即排到第5位,在智能体工作任务上超过Fable 5.1。
短板同样清晰:Terminal Bench 4.0上Hydrogen得分为54%,落后于Sonnet的64%和Sol的56%。X-High档位虽然提升智能水平,但输出token消耗几乎翻倍。
Terminal Bench 是评估 AI 智能体在真实命令行环境中完成工程任务能力的基准,任务涵盖文件操作、依赖安装、脚本调试、Git 操作等,要求模型在容器内多轮执行命令并根据输出自我纠错。它的评分通常以任务成功率计,因此能同时反映模型的编码能力、长程规划能力和对失败工具调用的恢复能力。Terminal Bench 4.0 与 4.1 版本任务集和难度不同,分数不可直接横向比较;文中 Hydrogen 在 4.0 上为 54%、在 4.1 上"编造性陈述减少 5 倍",是两个不同维度的结果,比较时应留意版本差异。
实测:Minecraft克隆与前端落地页
UP主让Hydrogen生成一个Minecraft克隆,运行8分钟后得到了带火把、昼夜循环、方块破坏和合成系统的完整结果——由一款Flash模型产出这种复杂度,在他看来"有点疯狂"。
前端开发是另一个惊喜。在生成Xbox手柄SVG的对比测试中,Hydrogen耗时约4分钟、花费约42美分,而Gemini 4 Argon耗时约6分钟、花费约83美分,且Hydrogen的产出质量更好。他让模型生成多个带滚动触发和不同字体的落地页,模型不仅完成了布局,还注入了自己的设计判断。
使用体验上,Hydrogen在Antigravity环境中配合Swarm功能表现最佳。一个名为Crimson Moth的项目借助Swarm跑了约45分钟,视觉效果接近Anthropic系模型的水准。
该模型的可用渠道包括Gemini App、Google Search和Google AI Studio;AI Pro与Ultra订阅用户还可通过Antigravity、Chrome中的Gemini以及Google Sheets访问。
Anthropic路演:愿意为安全放慢速度
据同一视频的报道,Anthropic在IPO路演中抛出了一个相当少见的表态:公司愿意为了安全放慢AI开发速度,即便这意味着落后于OpenAI等竞争对手。创始人信中明确写道,愿意"比我们本可以做到的更慢地推进",哪怕这会让竞争方占据优势。
配套承诺包括:Claude保持无广告;七位创始人承诺捐出80%的Anthropic股份;公司拿出5%的股权注入此前讨论过的公共利益基金。
UP主对此持保留态度——上一次Dario谈及需要放慢开发时,Anthropic随后发布了Claude 5.5系列,成为当时最强的模型之一。他认为这更像IPO前的公关叙事。财务层面,公司季度营收被报道为十亿美元级、同比增长超过12倍,有超过11,900家客户年支出至少10万美元;同时录得233亿美元净亏损,其中219亿美元来自估值相关的会计调整而非运营支出。股票预计以INT为代码在纳斯达克交易。
同一时期Anthropic还推出了Claude Meetings:Claude作为可见参与者加入团队视频会议,可实时回答问题、在会议进行中创建文档和白板,自动记录笔记并生成行动项。该功能先从Google Meet起步,以beta形式向团队和企业订阅用户开放。

路演中另一个被提及的案例是:Claude帮助Anthropic的一款模型在几乎没有人工干预的情况下,三天内跑上了AMD芯片——公司称这类工作过去需要数十名工程师做上数月。
英伟达人事震荡与Blackwell疑云
视频中报道的最具冲击力的消息是英伟达CEO黄仁勋的去职。据报道,此事与涉及个人关系及潜在利益冲突的指控有关,董事会承受了巨大压力,现任CFO出任临时CEO。
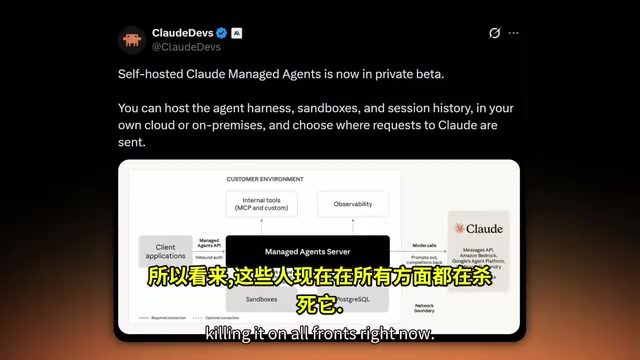
另一边,一份新发布的取证分析声称,四家中国AI开发商——DeepSeek广告、Moonshot AI、MiniMax和蚂蚁集团——在开发最新模型时使用了英伟达Blackwell硬件。研究者的方法值得一提:他们没有依赖泄露文件,而是分析公开的模型权重,寻找可作为"硬件指纹"的数值模式。据称有六个模型呈现出与Blackwell一致的特征,且部分特征已在真实Blackwell GPU上复现。
需要强调的是,这只是研究者的发现,并非独立证实的违规证据。即便硬件识别准确,也无法说明芯片由谁供应、在哪里运行、是否违反出口管制。目前也没有证据表明该报告与黄仁勋的离任存在关联。但在AI需求最旺盛的时点,英伟达同时面对领导层真空和供应链审查压力,其对整个AI生态的传导效应值得持续观察。
模型权重取证(weight forensics) 是一类不依赖内部文件或供应链记录的硬件溯源方法:研究者分析公开可得的模型权重,寻找训练过程中留下的系统性数值痕迹,例如特定层的激活分布、量化误差模式、注意力头的异常离群值等,并将其与在已知硬件上训练的小模型所呈现的特征做比对。这类方法的优势是证据来自公开产物、可被第三方复核;局限在于特征可能被训练后处理(微调、量化、蒸馏)抹去或混淆,也无法证明芯片的供应路径、部署地点或是否违反出口管制。因此它只能作为线索,不能单独构成违规证据。
OpenAI网络安全模型:77%的ExploitGym成绩
在Cyber at the Frontier展示中,OpenAI公开了一款未发布的内部模型,在ExploitGym基准上得分77%——该基准测试AI智能体能否把已知软件漏洞转化为可用攻击代码。作为对照,Gemini 4 Carbon为54.8%,GPT-6 Cyber为52.6%,GPT-6 Astra为42.4%,Claude Mythos 5.2为39%。相比8天前发布的GPT-6 Cyber,提升达24.4个百分点。PatchBench上该模型得分79.1%,GPT-6 Cyber为73.5%。
这类专用模型的迭代速度值得警惕:同一套能力既能让防守方更快发现弱点,也可能被攻击方利用。目前该模型没有公开的发布日期和详细系统卡,UP主希望OpenAI最终通过Daybreak Blue和Red向经过验证的研究人员开放这些能力。
其他值得关注的动态
- Seed Dance 2.5 Flash:字节跳动推出的更快更便宜的文生视频模型,画质接近Seed Dance 2.5,生成速度约为其两倍。720p文生视频与图生视频定价约为每秒15美分,比旗舰模型便宜约三分之一。API计划于11月15日通过BytePlus的ModelArk平台上线。
- Handoff Squared:新公司Hark推出的第二代计算机使用模型,声称速度为前代两倍,在高推理档位下比Opus 5.5更快。据称其在浏览器任务上端到端提升约10%,购咖啡速度快1.7倍、订机票快3.8倍、购物快2.5倍;上线一个月处理了超过560万次浏览器会话和超过2000万美元交易。
- 微软Ignite:大会将于11月17日开幕,MAI团队将带来新模型、演示和由模型构建者主讲的场次。
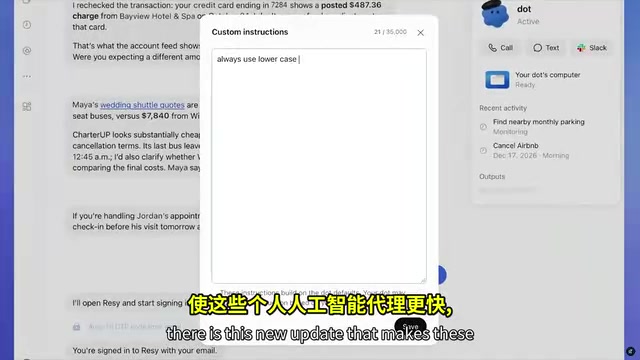
- ChatGPT DOTS更新:个人AI智能体变得更会话化、更擅长遵循指令,新增自定义指令功能,可设定诸如"发送邮件前必须先给我看草稿"的审批规则。
- Gemini上车:Gemini应用已直接集成到Apple CarPlay,iOS用户可在车内与Gemini Live自由对话。
把这一天的消息放在一起看,谷歌用一款Flash模型把"便宜快速"和"够用可靠"之间的界限又挪了一段距离,而Anthropic的IPO叙事、英伟达的领导层变数、OpenAI的网络安全专用模型,则分别指向商业、供应链和安全三条不同的紧张线。
相关推荐

Claude上线协作表格与白板,Anthropic硬刚微软谷歌
Anthropic向付费用户推送Claude Sheets和Claude Whiteboards测试版,支持一句话生成带公式的表格、将口头计划整理成带时间线的协作白板。文章分析其能力边界、编辑可见设计,以及与微软谷歌的正面竞争。

一句话生成表格?Claude Sheets深度体验与避坑指南
Claude Sheets 测试版上手解析:一句话生成带公式和下拉菜单的协作表格,但 100,000 单元格上限与套餐用量限制可能比你想的更早成为瓶颈。附三个业务场景、合规限制与五步避坑清单。

AI Agent编排框架实测评级:谁被高估,谁堪称传奇
一场直白的AI Agent编排框架分级评测:CrewAI与LangGraph为何被封为传奇,OpenAI Agents SDK与Agno为何只算良好,LlamaIndex、Cloudflare Agents为何被指高估,以及TypeScript开发者该选Mastra的理由。