Gemini 4 Hydrogen评测:Orchestrator模式下的编程新范式
Gemini 4 Hydrogen 以更快更便宜为卖点,主推 Orchestrator 多模型编排新范式。
文章评测了 Google DeepMind 发布的 Gemini 4 Hydrogen。该模型定位更快更便宜,在 Artificial Analysis 指数上 high 设置得 51 分、xhigh 得 54 分,略高于 Argon 的 50 分,价格与速度优势明显。Google 同步推出 Orchestrator 模式,让 Argon 或 Carbon 负责规划决策、Hydrogen 执行大量子任务,以避免全量调用旗舰模型造成的延迟与配额浪费。作者实测用纯 Hydrogen 生成清洁服务网站效果不佳,印证其适合重复性工作而非设计决策;在 Google 搜索中则表现出更好的思考深度与结果呈现。横向对比显示其单点性价比并非最优,价值在于组合编排。
Gemini 4 Hydrogen评测:Orchestrator模式下的编程新范式
Google DeepMind 近日发布了一款代号为「Hydrogen」的 Gemini 4 系列新模型。与以往追求「最强」的旗舰不同,Hydrogen 的定位是更快、更便宜,并在特定基准上反超更大模型。更关键的是,Google 同步推出了 Orchestrator 模式,试图重新定义我们使用大模型的方式:不再让一个模型包打天下,而是让快模型干杂活、强模型做决策。
Hydrogen 到底是什么:快模型的反超
根据 Google DeepMind 的博客,Hydrogen 在 Artificial Analysis 智能指数上以「high」思考等级取得 51 分,略高于 Argon 的 50 分;在「xhigh」设置下可达到 54 分。价格方面为每百万输入 token 1.50 美元、每百万输出 token 0.75 美元,明显低于旗舰模型。
速度是其核心卖点:相比 3.8 Flash,Hydrogen 快约 2.8 倍,同时 token 消耗降低 12% 到 23%。这意味着在长会话、多轮调试的场景下,成本与延迟都会有可感知的下降。
但视频作者强调了一个前提——这个模型不该被单独使用。Google 官方给出的方式是把它和 Argon 或 Carbon 组合起来,这也引出了本文的重点。
Artificial Analysis 智能指数是一个被广泛引用的第三方基准,它不只看模型答对多少题,而是综合推理、知识、编程、数学等多类任务,并把推理成本(每任务美元数)与延迟一并纳入考量。由于它同时披露分数和价格,常被用来比较「单位成本下的智能」。需要留意的是,指数分数对「思考等级」(如 high、xhigh)非常敏感,同一模型在不同设置下可能相差数分,因此跨模型对比时必须对齐设置。文章中提到 Hydrogen 在 high 下 51 分、xhigh 下 54 分,正是这一机制的体现;而竞品「max 设置下每任务 3.16 美元、指数 54 分」的比较,也需理解为在同等或更高思考预算下的对照。
Orchestrator 模式:让对的模型做对的事
在 Google Anti-Gravity 应用中,新增了 Orchestrator 选项。逻辑很简单:处理大型项目时,主模型可以选择 Carbon 或 Argon 负责规划与关键决策,而 Gemini 4 Hydrogen 则被派去执行大量子任务。
Google 的解释是:如果在每个功能、每次调试、每个常规任务的每一步都调用前沿推理模型,会拖慢循环速度并消耗大量前沿配额。Hydrogen 的出现正是为了解决这种「杀鸡用牛刀」的浪费。作者提到,此前推出的 Gemini 4 Carbon 配合 /swarm 用于追踪大规模多工作流工程任务,几天内 Anti-Gravity 上就启动了数以万计的此类任务。
这背后的思路值得注意:模型能力不再是唯一变量,模型编排本身正在成为一种工程能力。
Orchestrator(编排器)模式是相对于「单模型端到端」的一种架构选择:由一个规划模型充当调度者,把大任务拆成子任务,分派给不同专长的执行模型,再汇总结果。它与常见的「多智能体」思路相近,但更强调成本分层——用前沿模型做少量高价值决策,用廉价快模型承担大量重复执行。工程上的关键挑战在于任务拆分的粒度、子任务之间的上下文传递,以及失败重试与结果校验。文章提到的 /swarm 可理解为面向大规模并行工作流的编排入口,适合批量追踪与分派成百上千个工程任务;而 Orchestrator 更偏向单个项目内的分层协作。
实测:纯 Hydrogen 建站表现平平
作者做了一次直接测试:用 Anti-Gravity 加 Hydrogen 的 high 模式,提示词是「创建一个家庭清洁服务网站,需要服务区域验证、地址录入、周期预订和套餐选择」。
结果并不理想。生成的网站文字堆砌严重、视觉设计差,作者直言「非常糟糕,我不喜欢这个网站」。但这恰好印证了官方定位——Hydrogen 擅长快速完成大量计算与结构化工作,却未必能做出最好的设计决策。
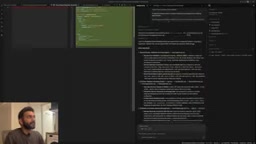
对比 Google 官方展示的案例则亮眼得多:用 Hydrogen 生成的「Gemini's Land」游戏、一个电商网站,以及把 Google Sheets 变成动画像素画布的实验。作者认为这些官方示例更能体现模型在快速构建上的潜力。
搜索场景:思考质量与呈现的提升
Hydrogen 也已接入 Google 搜索。作者对比了新旧结果:询问「小户型工作室如何用 200 美元以内打造分区感」,旧结果较为平淡,新结果在思考深度和排版上更好;询问「搬到波士顿市中心工作,想要有社交氛围但周末不吵闹的街区」,新版不仅给出更清晰的推荐理由,还内嵌了可展开的地图。
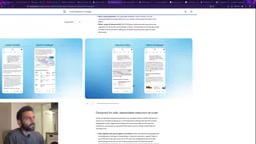
这部分变化相对直观——搜索不再只是罗列链接,而是给出结构化的建议。作者判断其在搜索中的表现优于 Gemini 3.5 Flash。
**AI 搜索中的「思考质量」**通常指模型在给出答案前进行多步推理、权衡约束条件的能力,与单纯检索摘要不同。以文章中「200 美元以内打造分区感」为例,好的回答需要拆解预算、空间限制与可用商品,再组织成可执行方案;而「搬到波士顿市中心」这类问题涉及主观偏好(社交氛围、噪音容忍度),模型需要显式列出推荐理由而非只给结论。结果呈现层面的改进——结构化排版、可展开地图等富媒体组件——则依赖搜索前端与模型的协同,把答案从「链接列表」变为「可直接消费的建议卡片」。这也是判断搜索型模型升级是否「可感知」的重要维度。
横向对比:便宜不等于最优解
作者抛出了一个值得讨论的问题。在 Artificial Analysis 基准中,某款竞品模型在 max 设置下每任务成本 3.16 美元、指数 54 分;另一款在 max 设置下每任务成本仅 1.27 美元,指数甚至高于 Hydrogen 在 xhigh 下的表现。也就是说,单看性价比,Hydrogen 并非无懈可击。
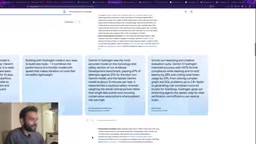
对此作者的态度是理解的:Hydrogen 的价值不在单点最强,而在于组合。对于已有项目、需要持续修 bug 和日常编码的开发者,让 Hydrogen 承担重复性工作、把旗舰模型留给架构决策,整体效率会更好。
谁适合用 Hydrogen
- 已有成熟项目的开发者:Argon 或 Carbon 搭骨架,Hydrogen 做日常迭代和缺陷修复。
- 成本敏感的长会话用户:更低的 token 消耗和更快的响应,适合高频交互。
- 想要尝鲜编排模式的团队:Orchestrator 提供了一种可复用的多模型协作范式。
如果你期待一个「单模型解决一切」的答案,Hydrogen 可能会让你失望;但如果你接受「模型分工」的思路,它提供的是一个更务实的工程选项。目前 Hydrogen 已可在 Gemini 应用、Google Anti-Gravity 和 AI Studio 中使用。
相关推荐

OpenAI 11月30日关停Agent Builder等三项服务,开发者需紧急迁移
OpenAI 将于 11 月 30 日关停 Agent Builder、evals 仪表盘和可复用提示三项开发者功能,evals 已转为只读。本文梳理受影响范围、OpenAI 官方给出的迁移路径(Agent SDK、PromptFu、自有代码)以及开发者本周应完成的导出与重建动作。

RankSpot:按次付费的SEO与AI搜索执行层,让Agent替你写文、发布、换外链
RankSpot 是面向 AI Agent 的 SEO 与 AI 搜索执行层,通过 MCP 接入 Claude 或 ChatGPT,让 Agent 完成写文、发布和外链获取。按次付费,每篇文章 3 美元,读数据免费,支持 100 多种语言。

Appxiom:给AI编程助手装上生产环境上下文
Appxiom为AI编程Agent提供生产环境上下文,覆盖崩溃、卡顿、内存泄漏与失败的网络调用,支持Android、iOS、Flutter、KMP和Web,并通过Goal Friction Impact按业务目标排序Bug。