Gemini 4 Hydrogen评测:越级平替Argon的性价比之选
Gemini 4 Hydrogen 以轻量定位实现越级表现,但额度与稳定性仍是短板。
Google 三天内连发三款模型,压轴的 Gemini 4 Hydrogen 虽定位轻量级,却被认为可平替 3.8 Flash 甚至 Gemini 4 Argon。其定价约为 3.8 Flash 的两倍,与 Carbon 接近,额度按价格乘二计算,用户普遍反映吃紧。实测体验快、稳、说人话,适合日常任务,但深度推理和全局视野受 Flash 基因限制,且继承零缓存、算力紧张导致 TPS 波动等遗留问题。配套的 Orchestrator 模式让 Carbon 与 Hydrogen 自动分工,官方称可省 24% 额度;Swim 模式适合可并行任务。Carbon+Hydrogen 组合使 Gemini 家族占据模型世界第二,但额度与稳定性仍是待解难题。
Google 在连续三天内发布了三款模型,而 Gemini 4 Hydrogen 作为压轴登场的第三款,被官方定位为轻量级选手。但据 YouTube 频道 DPGem9 的上线解析视频来看,这款模型的实际表现远超“轻量”二字——它不仅接替了 3.8 Flash 的位置,甚至让不少用户萌生了替换自家老大哥 Gemini 4 Argon 的念头。
定价与额度:中间路线,但额度依然紧张
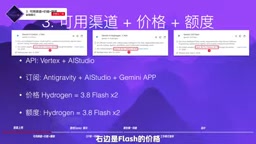
Hydrogen 上线时没有延续 Flash 的半价活动,直接以原价登场。从 DPGem9 整理的价格对比柱状图来看,Hydrogen 的定价大约是 3.8 Flash 的两倍,同时又与 Carbon 的价格差距不大,整体处在中间档位。
额度方面同样按价格乘二计算,这让不少用户感到吃紧。频道在视频中直言“额度确实有点不太够用”,并猜测 Google 对这款模型的性能足够自信,才没有用首发半价来做推广。至于后续是否会有补偿性活动,目前只能保持观望。
“额度” 在此指 API 或订阅服务中按 token 或请求次数计算的用量配额。不同模型因推理成本不同,通常按价格比例换算额度:价格越高,同等金额可用的 token 越少。文章说“额度按价格乘二计算”,意味着 Hydrogen 的单位用量成本约为 3.8 Flash 的两倍,因此同样预算下可用量减半。首发半价 是厂商常用的推广策略,通过临时降价吸引用户体验新模型;Hydrogen 未采用该策略,说明 Google 可能认为其性能足以支撑原价,或有意控制初期负载。额度紧张会直接影响开发者和重度用户的日常使用,也是社区反馈中最集中的痛点之一。
第一印象:快、稳、说人话
DPGem9 对 Hydrogen 的初评是“日常工作好帮手”,并建议日常使用时优先选择 hi 或 xhi 的思考强度,特点是快、稳、能处理常规任务,而且“说人话”。测试中首字延迟和 TPS 表现正常,缓存指标出现异常是因为测试时间较长,并非模型本身的问题。
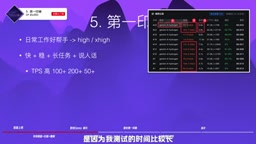
不过同一账号在相同时段内,TPS 从 100 多掉到了 50 多,频道推测是算力紧张所致。这也印证了 Hydrogen 完美继承了 Gemini 4 家族的“带病前进”特征——零缓存等问题依旧存在,稳定性仍需优化。
TPS(Tokens Per Second) 是衡量大模型输出速度的核心指标,指模型每秒生成的 token 数量(token 是模型处理文本的基本单位,约等于一个词或一个汉字)。TPS 越高,用户等待完整回复的时间越短。首字延迟(Time to First Token,TTFT)则衡量从发出请求到收到第一个 token 的时间,直接影响交互的“响应感”。两者共同决定使用体验:TTFT 低让人感觉“秒回”,TPS 高让长回复更快完成。文章中提到 TPS 从 100 多掉到 50 多,意味着输出速度减半,在长文本生成任务中感知明显。TPS 波动通常与后端算力负载、并发请求量有关,而非模型本身能力变化。
能力边界:能平替 Argon,但别指望深度推理
据频道观众群友的反馈汇总,Hydrogen 的优点集中在体验层面:速度非常快,首字和延迟表现优秀,输出速度也令人满意。很多人认为它可以作为主力模型尝试,平替 Sonnet、Terra 乃至 Argon,对比 3.8 Flash 是有质的飞跃,干活不敷衍、听话且愿意理解任务。
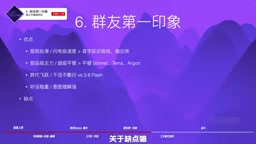
缺点同样明确。作为一款定位在 Flash 级别的模型,它在深度推理和全局视野上受限,3D 和图形方面有所弱化,文本细节上也会出现幻觉。这些都在预期之内,毕竟它的基因是 Flash,而不是 Pro 或 Ultra。
工作模式:Orchestrator 才是省额度的关键
Google 为 Hydrogen 配套推出了 Orchestrator 工作模式,让 Carbon 和 Hydrogen 在同一次对话中自动切换:Carbon 负责思考、清除和兜底检查,Hydrogen 作为便宜劳动力快速干活。按照官方说法,这种模式可以节省 24% 的额度。
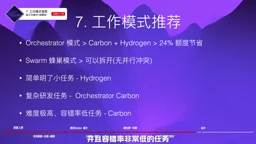
另外还有 Swim 分槽模式,适合可以拆开、没有并行冲突的任务,像小蜜蜂一样协同干活。频道给出的使用建议很清晰:日常小任务用 Hydrogen 配合 hi/xhi;复杂研发任务走 Orchestrator 的 Carbon 模式(注意不是 Argon 模式,两者性能差距太大);容错率极低的超难任务则用 Carbon 全程跑。
Orchestrator 模式 是一种多模型协作架构:由调度层根据任务阶段自动将请求路由给不同模型。通常由能力更强、成本更高的模型(如 Carbon)负责规划、推理和结果校验,而轻量模型(如 Hydrogen)执行具体生成或简单操作。这种“大脑+手脚”的分工能在保证质量的同时降低总体成本,因为大量 token 消耗发生在便宜模型上。官方称可节省 24% 额度,本质是用任务分解和模型分级替代单一模型全程运行。Swim 分槽模式 则是另一种并行策略:将可独立拆分的子任务分配到不同“泳道”同时执行,适合无依赖关系的任务,能缩短总耗时,但不适用于需要严格顺序或共享状态的场景。
总结:Gemini 4 时代是否正式降临?
Hydrogen 的意义在于它同时替换掉了 3.8 Flash 和 Gemini 4 Argon 两个位置,而 Carbon + Hydrogen 的组合让 Google 的 Gemini 家族拿到了模型世界第二的位置。频道甚至抛出了一个更大的判断:Gemini 4 时代正式降临了。
遗留问题也不少:额度不够、算力紧张、稳定性存疑,不换存、意外停止等灵活性问题在 Carbon 上表现得尤为突出。视频末尾还做了一处纠错——Google One Ultra 并没有月付选项,但如果以后出现年付,也建议谨慎对待。至于 OpenAI 的新模型在哪里,频道主没有给出答案,而是把问题留给了观众。
相关推荐

OpenAI 11月30日关停Agent Builder等三项服务,开发者需紧急迁移
OpenAI 将于 11 月 30 日关停 Agent Builder、evals 仪表盘和可复用提示三项开发者功能,evals 已转为只读。本文梳理受影响范围、OpenAI 官方给出的迁移路径(Agent SDK、PromptFu、自有代码)以及开发者本周应完成的导出与重建动作。

RankSpot:按次付费的SEO与AI搜索执行层,让Agent替你写文、发布、换外链
RankSpot 是面向 AI Agent 的 SEO 与 AI 搜索执行层,通过 MCP 接入 Claude 或 ChatGPT,让 Agent 完成写文、发布和外链获取。按次付费,每篇文章 3 美元,读数据免费,支持 100 多种语言。

Appxiom:给AI编程助手装上生产环境上下文
Appxiom为AI编程Agent提供生产环境上下文,覆盖崩溃、卡顿、内存泄漏与失败的网络调用,支持Android、iOS、Flutter、KMP和Web,并通过Goal Friction Impact按业务目标排序Bug。