Gemini 4 Hydrogen实测:谷歌编程能力翻身了吗?

Gemini 4 Hydrogen实测:后端可用、性价比突出,前端审美与极限推理仍逊旗舰。
B站UP主阿江对谷歌新模型Gemini 4 Hydrogen进行了多维度实测。该模型在自建题库约得80分、排名第11,紧咬第9名的Claude Sonnet 5.5,相比Gemini 3.8 Flash提升明显。后端单项83分,足以覆盖大部分后端编码需求;前端3D场景能完成交互,但视觉审美不及Claude Sonnet 5.5及Opus 5.5、GPT-6.2 Azure等旗舰。推理方面,魔法还原12题全部通过,推箱子6题仅得43分。大型ERP代码任务因API成本过高跑至欠费、耗时约四小时,最终改用订阅环境得77.9分,参考价值有限。额度可共用Gemini Flash,实测一天仅消耗周额度20%多,性价比成为最大亮点。
谷歌新模型Gemini 4 Hydrogen(以氢元素命名)发布后,B站UP主阿江第一时间做了实测。这款模型在第三方评测榜单上跑出约80分,排名第11位,紧咬第9名的Claude Sonnet 5.5,相比上一代Gemini 3.8 Flash有明显提升。那么问题来了:谷歌的编程能力,这次真的能打了吗?
榜单成绩:进步明显,但仍有差距
在UP主自建的题库上,Gemini 4 Hydrogen综合得分约80分,位列第11名,而Claude Sonnet 5.5排在第9名。对比上一代Gemini 3.8 Flash,提升幅度相当可观——UP主回忆,3.8 Flash当时给人的感受是"出得快,但coding能力不出众"。
从细分维度看,新模型在后端、前端、知识推理和"世界审美"上均有明显进步。后端单项得分83分,排在榜单第11名左右。UP主的判断是,这个后端水平"能写大部分的后端代码"。
值得一提的是额度策略的变化。此前Gemini Argon的额度消耗极快,性价比不高;而Hydrogen可以共用Gemini Flash的原有额度,UP主用20美元订阅实测一天后,周额度只掉了20%多,整体性价比明显改善。
第三方评测榜单与自建题库的区别
文中提到的"第三方评测榜单"通常指 LMArena、Artificial Analysis、Aider Polyglot 等公开基准,它们用统一的题目和打分规则横向比较各家模型,优点是可比性强,缺点是题目公开后容易被厂商针对性优化。UP主自建的题库则相反:题目不公开、贴近自己的真实工作流(3D 前端、ERP 后端、推箱子推理等),能反映模型在实际使用中的手感,但样本量小、评分带主观成分,不同期视频之间的分数不完全可比。因此文中"80 分排第 11"应当理解为该 UP 主测评体系内的相对位置,而不是行业通用排名。
"Flash"与"Argon""Hydrogen"的命名逻辑
谷歌 Gemini 系列长期用速度/成本档位命名:Flash 主打低延迟低成本,Pro 主打均衡,Ultra 主打最强能力。文中出现的 Argon、Hydrogen 等元素名更像是在原有档位之外新增的代号,可能对应不同的训练配方或发布批次。读者需要留意的是:同一个"Gemini 4"之下可能存在多个变体,它们的额度规则、上下文长度和定价并不一致,选型时不能只看大版本号。
前端实测:能完成,但审美没以前惊艳
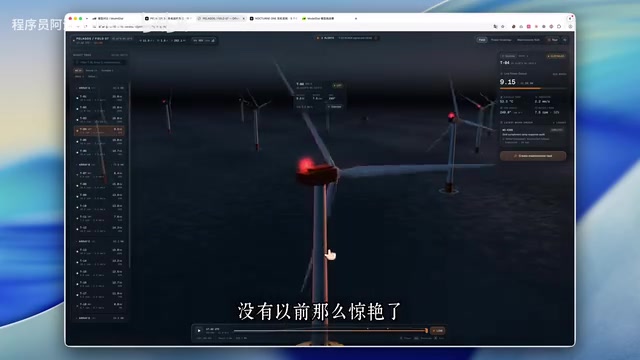
按照频道惯例,UP主用3D风力发电巡检系统来测试前端能力。Hydrogen能够完成入场画面和故障风机定位等交互,但视觉效果只能说"还行"——在UP主看来,它跟Gemini Argon差不太多,没有最初Gemini模型那种"前端视觉非常好"的惊艳感。
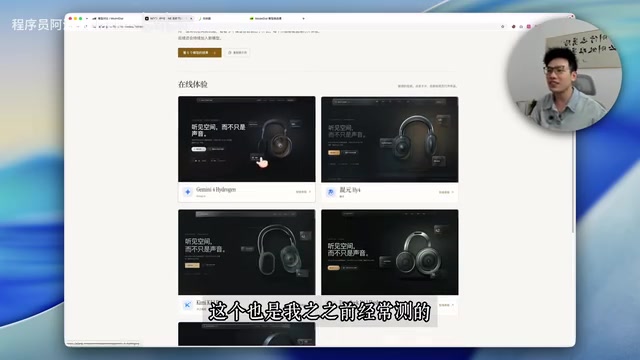
横向对比更能说明问题。Claude Sonnet 5.5在同样的3D场景里,旋转、放大后的细节表现和前端的整体审美都更好一些;DeepSeek广告的3D能力"相对来说也还行",性价比高;而天花板依然是Claude Opus 5.5和GPT-6.2 Azure这类旗舰模型——UP主用它们跑出来的风机画面"很真实",维修通道、放大细节都能明显看出差距。
在耳机产品页测试中,Hydrogen能完成预约视听弹窗、50秒故事、腔体坐标展示等交互,效果与DeepSeek差不多——"没有那么惊艳,但也能做到很好的效果"。而Claude Sonnet 5.5完成的三层结构展示,整体效果明显更好。UP主的个人习惯是:前端用Claude和Opus 5.5更放心,后端则GPT更好。
智商与推理:世界知识不错,推箱子翻车
除了常规编程,UP主还有一套基于Python的"智商挑战赛",只给模型暴露一个工具,不能写代码,全靠模型自己思考。
在"魔法还原"这类12道题的测试中,Gemini 4 Hydrogen全部搞定,表现优于部分国产模型,说明其世界知识和推理能力确实在线。
但到了推箱子环节,难度陡增:六道题涵盖入门到进阶,每关有三条命,Hydrogen完成得"一般",最终得分43分。作为参照,DeepSeek只完成两道题,Kimi K3只完成一道题(该题有时间限制)。UP主指出,推箱子目前只有Claude Opus 5.5、GPT-6.2 Azure这类旗舰模型效果才比较好。
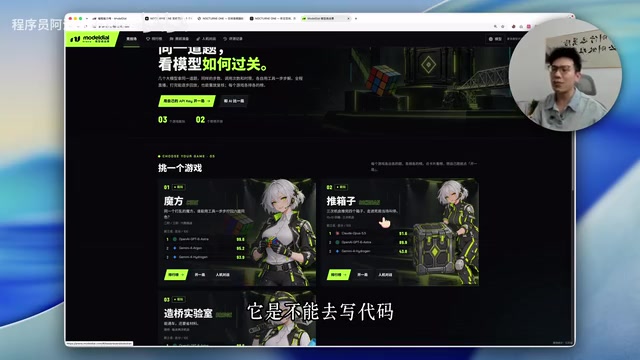
造桥实验方面,Hydrogen排在第7名左右,但有三道题因API返回问题暂未完成,UP主表示后续会再测。
推箱子为什么是检验推理能力的硬指标
推箱子(Sokoban)是经典的 PSPACE-完全问题,状态空间随关卡规模指数级膨胀,且存在大量"看似可行实则把箱子推入死角"的陷阱,非常考验模型的长期规划与回溯能力。更关键的是,文中设定"只暴露一个工具、不能写代码",模型必须纯靠语言推理在脑内模拟每一步的棋盘状态变化,无法借助搜索算法或暴力枚举来兜底。这恰好剥离了大模型最擅长的"写脚本解决问题"路径,直接测量其内在的空间推理与世界模型质量。因此推箱子得分低,往往比写代码失分更能说明模型在需要多步前瞻的任务上仍依赖外部工具。
大型代码任务:跑得动,但太贵太慢
"死三代码"测试包含三道用Python写的ERP题(涉及query、VR等),单文件可能超过一万行,对模型的工程能力是硬考验。
国产模型方面,UP主抽测了混元、DeepSeek和MiniMax,第一轮基本都完不成,需要提示。DeepSeek在T2题目上三轮提示仍未完成。GPT-6.2凭借最高的后端分数,三道题一轮全部通过。
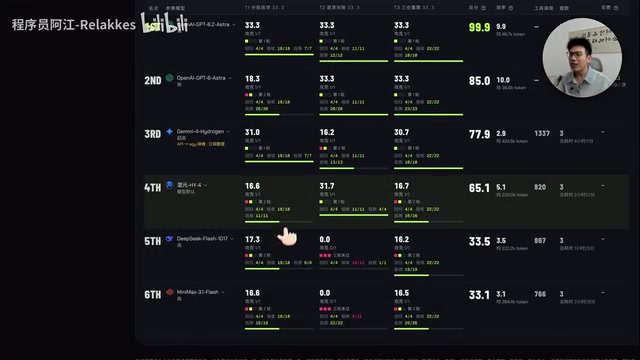
Hydrogen在这个环节遇到了现实问题:UP主先用官方API跑,结果"跑了一百多块钱跑欠费了",任务需要四小时左右(国产模型此前约两小时)。最终只能用anti-gravity订阅环境跑完,得分77.9。UP主也坦承这个分数"不是特别公平",因为agent和API环境不完全一致,仅供读者参考。
Agent 环境与裸 API 调用的差异
文中"用官方 API 跑欠费、改用 anti-gravity 订阅环境跑完"涉及一个重要区别:裸 API 调用需要自己实现文件读写、命令执行、错误重试等循环,每一轮上下文都要重新计费,长任务下 token 消耗会成倍放大;而 anti-gravity 这类 agent 订阅产品内置了工具调用框架、上下文压缩和缓存策略,同样的任务消耗的额度少得多,但内部做了哪些裁剪并不透明。两者跑出的分数因此不能直接横比——agent 环境可能因为更好的上下文管理而提分,也可能因为工具限制而降分,这正是 UP 主称 77.9 分"不是特别公平"的原因。
结论:能用了,性价比是最大亮点
综合实测,Gemini 4 Hydrogen相比Gemini 3.8 Flash"可以说是好很多了"——从不好用变成能用,后端水平足以覆盖大部分日常需求,额度策略也让它具备不错的性价比。短板在于前端审美仍不及Claude系的头部模型,极限推理任务(如推箱子)与旗舰差距明显,大型代码任务的时间与成本开销偏高。
对于想用谷歌模型写代码的开发者来说,这一代值得重新放进工具链试一试;但如果追求前端视觉和复杂推理的上限,Claude和GPT的旗舰仍是绕不开的选择。
额度(quota)策略对实际使用成本的影响
订阅制 AI 编程工具的成本往往不体现在标价上,而体现在额度消耗速度与重置周期。文中"共用 Gemini Flash 原有额度、一天只掉 20% 多周额度"意味着该模型被划入了较低计费档,对高频使用者而言,等效可用量可能比上一代高出数倍。评估一个模型是否值得纳入工具链时,除了榜单分数,还应关注三点:额度是否与低档模型共享、是否存在单次请求的上下文长度惩罚、以及长任务失败后是否会重复计费。这三项共同决定了"跑得动"能否转化为"用得起"。
相关推荐

Claude上线协作表格与白板,Anthropic硬刚微软谷歌
Anthropic向付费用户推送Claude Sheets和Claude Whiteboards测试版,支持一句话生成带公式的表格、将口头计划整理成带时间线的协作白板。文章分析其能力边界、编辑可见设计,以及与微软谷歌的正面竞争。

一句话生成表格?Claude Sheets深度体验与避坑指南
Claude Sheets 测试版上手解析:一句话生成带公式和下拉菜单的协作表格,但 100,000 单元格上限与套餐用量限制可能比你想的更早成为瓶颈。附三个业务场景、合规限制与五步避坑清单。

AI Agent编排框架实测评级:谁被高估,谁堪称传奇
一场直白的AI Agent编排框架分级评测:CrewAI与LangGraph为何被封为传奇,OpenAI Agents SDK与Agno为何只算良好,LlamaIndex、Cloudflare Agents为何被指高估,以及TypeScript开发者该选Mastra的理由。