Gemini 4 Hydrogen与Claude 5.2同周发布,Anthropic封号揽收23亿美元
谷歌、Anthropic同周密集发布模型矩阵与新版本,智能体客户化成新主线
本周AI领域迎来密集发布:谷歌一次性推出Gemini for Carbon、Gemini 4 Hydrogen与按输入计费的Decisions API,形成覆盖旗舰推理、快速响应与调度场景的模型矩阵,成本优势突出;Anthropic发布Claude Fable 5.2与Mythos 5.2,在Frontier Code 2.0登顶并启动IPO路演,第三季度营收70亿美元。机器人方向上,谷歌Gemini Robotics 2.5、英伟达Groot 2与蚂蚁LinBot Touch分别代表精细操作、世界模型与触觉感知路线。OpenAI推出商家智能体功能,催生Business to Agent概念,Shopify与Neon的数据显示智能体正成为真实的交易与开发主体。国产模型方面,阿里、字节、MiniMax在图像与视频生成上持续迭代。
Gemini 4 Hydrogen与Claude 5.2同周发布,Anthropic封号揽收23亿美元
本周AI大模型领域迎来密集发布期:谷歌一次性放出Gemini 4 Hydrogen、Gemini for Carbon等多款模型,Anthropic推出Claude Fable 5.2与Mythos 5.2并启动IPO路演,阿里、字节、英伟达、蚂蚁等也各有新动作。以下按主题梳理这轮更新的关键信号。
谷歌:一个模型矩阵,而非单点突破
谷歌这轮发布最有意思的地方不是某个模型拿了第一,而是它把模型拆成了一个覆盖不同场景的矩阵。
旗舰推理模型Gemini for Carbon面向开发者、企业和Google AI Ultra用户开放,擅长需要多轮排查和验证的工程任务。首次公布时它以59分位列Artificial Analysis Intelligence Index v5.0第一名,本次又在CursorBench 4.0、Wonder和AlimationBench 3.0测评中排名第一。在谷歌与Artificial Analysis联合推出的多模态知识工作基准MKA上(包含200项行业专家设计的任务),Carbon的交付质量排名第二,平均成本约为第一名Fable 5.2的七分之一——成本优势相当明显。
面向日常编程和智能体任务的快速模型Gemini 4 Hydrogen则走另一条路线:在默认高推力档位以51分超过Argon的50分,最高档位在Artificial Analysis Intelligence Index上达到54分,并已进入谷歌搜索等产品。
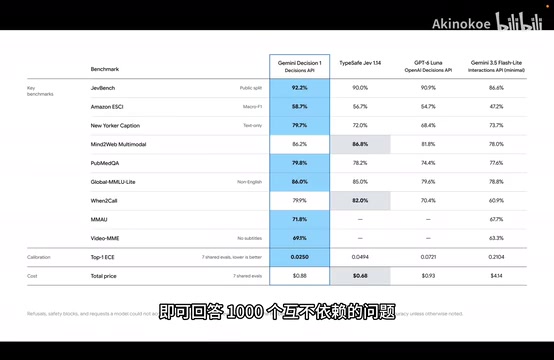
配套的Gemini Decisions API值得单独关注:它让应用在给定选项中快速选择工具、分配模型或检查内容是否符合规则,底层模型Gemini Decision 1支持同一份材料只上传一次即可回答1000个互不依赖的问题。接口按输入计费、不收输出Token费用,输入约每百万Token 0.1美元。这种定价结构明显是为了高频、低延迟的调度型调用设计的。

此外,谷歌还发布了DNA序列模型Alpha Genome 2,可预测同一遗传变异在不同细胞类型或状态下的基因表达影响,识别出的会改变细胞基因表达的变异数量接近上一代的两倍;以及面向医疗场景的Gemini for Health Care预览版,能跨电子病例、理赔和行政系统整理资料,在申请保险授权时对照承保政策提取病例证据、指出缺失材料并附上出处。
Artificial Analysis Intelligence Index 是第三方评测机构 Artificial Analysis 维护的综合能力榜单,它把多个公开基准(推理、编程、知识问答等)的结果聚合成单一分数,用于横向比较不同厂商的模型。该指数会随版本迭代调整题目和权重,因此不同版本之间的分数不可直接对比。文章中的 59 分、54 分等数字均指该指数某一版本下的结果,只反映模型在特定评测集上的表现,并不等同于真实业务场景中的效果。
CursorBench 4.0 则是围绕代码编辑器 Cursor 使用场景设计的编程评测,侧重考察模型在多文件改动、代码库理解与工具调用上的能力,与传统的算法题式编程基准形成互补。这类基准更贴近开发者日常使用智能体编程的方式。
Anthropic:编程能力登顶,同时走向资本市场
Anthropic发布Claude Fable 5.2和Mythos 5.2,两者共用底层模型。Fable 5.2以49.1%的成绩位列本轮Frontier Code 2.0编程测评第一名。更引人注目的是两项能力演示:1000个Fable智能体用30小时将费马大定理的证明转写为计算机可逐步核验的形式,而早期研究模型在人工指导下用时约11天;在与Diot Computers的测试中,模型仅凭一段需求说明,就为USB会场扬声器、语音助手装置和掌上电子宠物设计了电路板、外壳和固件,并自行检查元件布局与制造限制,人类工程师按设计制造出三台可工作的原型,均无需修改电路。
资本市场方面,Anthropic启动IPO路演,拟以每股70-78美元发售8.25亿股A类普通股(其中约8.01亿股为公司新股,其余由现有股东出售),申请以ANT为代码在纳斯达克上市。招股书显示公司第三季度营收为70亿美元。视频中还提到,Anthropic靠封号在9个月内获得23亿美元收入——这一说法属于创作者的个人解读,作为单一来源呈现,读者可自行判断其统计口径。
Frontier Code 2.0 是面向智能体编程的前沿评测之一,任务通常要求在真实代码仓库中完成多步修改,并按测试是否通过、改动是否正确来计分。49.1% 这样的绝对分数看似不高,是因为题目难度被刻意设置得较高,主要看相对排名而非是否接近满分。
IPO 路演指公司在正式挂牌前向机构投资者介绍业务、财务与发行方案的过程,用于确定最终发行价与认购需求。招股书中披露的季度营收属于公司按会计准则确认的收入,与"封号收入"这类未经审计、口径不明的说法不在同一层级,前者可作为事实引用,后者更适合视为待验证的讨论素材。
机器人:从「会动」到「会想下一步」
机器人领域本周的信息量不亚于大模型本身。
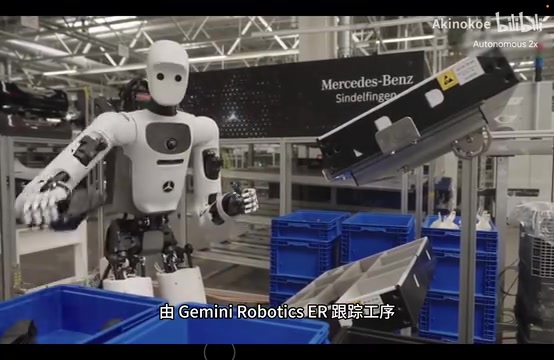
谷歌DeepMind发布Gemini Robotics 2.5,可控制双指夹爪和五指灵巧手完成打蝴蝶结等精细操作。在奔驰德国和匈牙利工厂的产线验证中,Aptronic的Apollo 2人型机器人由Gemini Robotics ER跟踪工序、由2.5控制手臂,从料箱取出汽车零件并按装配顺序放入托盘,成功率达96%。
英伟达第二团队发布机器人世界动作模型Groot 2,同时预测机器人的下一步动作以及动作发生后的画面,让机器人能从人类示范中学习并把技能迁移到不同硬件;团队还开放了10万小时第一人称视频数据、模型权重和跨硬件适配方案,计划12月发布。蚂蚁Robbie Ant开源触觉技术模型LinBot Touch,用近5000小时真实记录训练,将压阻、磁信号和视觉触觉信号转换为统一表示,真机演示中灵巧手能凭接触反馈判断钥匙是否插到位、控制挤压牙膏的力度。
智能体正在成为「客户」
OpenAI面向Businesses in ChatGPT推出测试版,商家可在Business Hub认领企业资料、更新商品价格和库存并查看品牌被提及和网站被点击的汇总数据;符合条件的美国电商和在线服务商还可创建Business Agent,用户在ChatGPT回答中看到商家后可直接追问商品差异或服务细节。
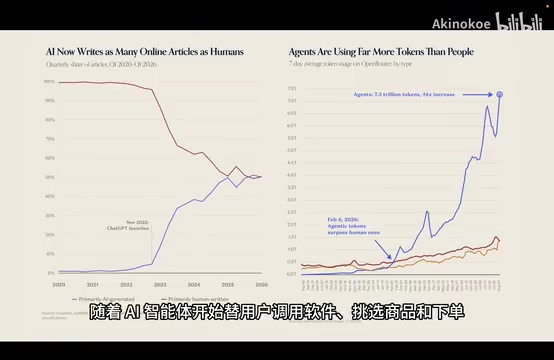
对此,有观点提出:随着AI智能体开始替用户调用软件、挑选商品和下单,企业需要把智能体也当作客户,而不只是人。这种商业模式被称为Business to Agent。Shopify数据显示,2026年第一季度来自AI搜索的订单接近上年同期的13倍。软件开发领域也出现类似变化,Neon约80%的新增数据库由AI智能体创建。
本地化工具方面,General Translation完成种子轮和A轮共计2700万美元融资,分别由Offer Adventures和Anderson Horowitz领投。其AI工具能在产品更新时同步翻译软件界面、文档和视频,让同一项功能在不同材料中使用一致的译法,并按语言调整界面布局,有客户已用这套工具将产品翻译成60多种语言。
Business to Agent(B2A) 是相对于 B2B、B2C 提出的概念:当 AI 智能体代替人类浏览商品、比较参数、调用接口并完成下单时,企业需要针对智能体优化商品数据结构、接口可读性和授权机制,而不是只面向人类设计页面与营销话术。这一模式对商家意味着新的流量入口和新的竞争维度,也对身份验证、支付授权与责任归属提出新问题。
Shopify 的订单倍数与 Neon 的数据库创建比例属于平台侧观察数据,能说明趋势方向,但受统计范围和基数影响,不宜直接外推为全行业比例。
国产模型与生成工具密集迭代
阿里巴巴开放多模态旗舰模型Quantum Max Preview,可理解图像和视频、调用工具,面向复杂编程、前端设计和办公任务,用户可通过阿里云广告Token Plan、QuantWork、Coder和千问App等入口试用。百度智能云发布大模型服务交易平台词源索,上线一个月入驻的模型服务资源超过100个,日均Token调用量超过7000亿。
生成工具方面,字节Seed团队推出图像生成与编辑模型Seedream 5.5,重点改进连续修改同一张图时的稳定性,据称支持百轮编辑,能在调整指定区域的同时按像素保留其余画面;同时推出视频生成模型Seedance 2.5 Flash,生成质量接近旗舰版Seedance 2.5,速度接近其两倍,可生成最长30秒视频,720P文生视频和图生视频价格为每秒0.152美元,约为旗舰版的34%。
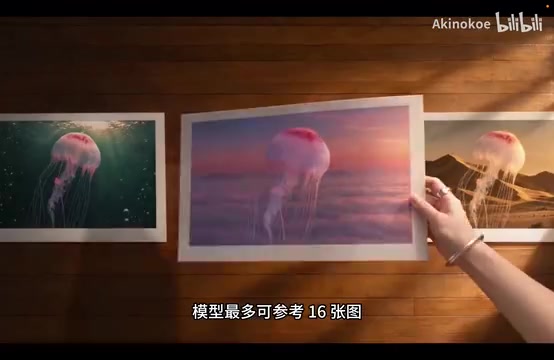
MiniMax开放图像生成与编辑模型H3 Damage权重,模型最多可参考16张图,通过6步采样直接生成约1600万像素的图像。
语音与评测方面,11 Labs推出录音转写模型Scratch V3和实时转写模型Scratch V3 Live,覆盖102种语言,词错误率大幅下降,实时版支持标注谁说了哪句话并结合上下文判断说话人是否讲完。杨志林、姚七志等研究者推出理论计算机科学评测基准TCSXM,用100道专家审核的任务考察智能体证明定理、编写求解器、构造数学对象和研究开放猜想的能力,结果由Lin内核或可执行程序验证;GPT-6 Astra以71.9分位列完整版第一,但没有模型完整解决测试中的30个开放猜想。
词错误率(WER) 是语音转写评测的常用指标,计算方式是错误词数(替换、插入、删除)除以参考文本总词数,数值越低越好。跨 102 种语言的模型通常在各语种上表现差异较大,厂商公布的平均值需结合具体语种和测试集来看。
开源权重与开源代码不同:开放权重意味着可以下载模型参数自行部署和微调,但训练数据、训练代码未必公开,许可证也可能对商用设限。MiniMax 开放 H3 Damage 权重即属于这一类,使用前需要核对具体许可条款。
本周观察
这一轮发布揭示了两条主线:其一是模型分层——旗舰推理、快速响应、专用调度各司其职,成本结构成为竞争焦点;其二是智能体的「客户化」,当AI代替人调用软件、下单、创建数据库时,商业基础设施的假设正在被改写。至于封号带来的收入数字,在缺乏公开口径的情况下,更适合作为一种市场讨论而非定论。
相关推荐

OpenAI 11月30日关停Agent Builder等三项服务,开发者需紧急迁移
OpenAI 将于 11 月 30 日关停 Agent Builder、evals 仪表盘和可复用提示三项开发者功能,evals 已转为只读。本文梳理受影响范围、OpenAI 官方给出的迁移路径(Agent SDK、PromptFu、自有代码)以及开发者本周应完成的导出与重建动作。

RankSpot:按次付费的SEO与AI搜索执行层,让Agent替你写文、发布、换外链
RankSpot 是面向 AI Agent 的 SEO 与 AI 搜索执行层,通过 MCP 接入 Claude 或 ChatGPT,让 Agent 完成写文、发布和外链获取。按次付费,每篇文章 3 美元,读数据免费,支持 100 多种语言。

Appxiom:给AI编程助手装上生产环境上下文
Appxiom为AI编程Agent提供生产环境上下文,覆盖崩溃、卡顿、内存泄漏与失败的网络调用,支持Android、iOS、Flutter、KMP和Web,并通过Goal Friction Impact按业务目标排序Bug。