Gemini 4 Neon 实测翻盘:美国豆包如何两周五连发

谷歌两周连发五模型,Gemini 4 Neon 实测反超 Opus 5.5,成本砍半但仍有短板。
文章复盘了谷歌两周内连发 OMNI 1.2、Flash、Carbon、Hydra、Nil 五个模型及世界模型吉尼4的表现。B站UP主实测显示,Nil 在官方19项对比中赢16项,独立综合榜以61分冲至全球第三,编程智能体榜第一,单任务成本比 Opus 5.5 砍半,4K图像直出与3D更新亦有亮点;但硬核代码测试 Opus 仍险胜,Nil 还存在 token 消耗偏高约15%的问题。文章将翻身归因于三层真相:监管审核豁免、稀疏 MoE 按需切型号、第7代 TPU 自研降本,并给出 Carbon 促销期夜间长任务、白天用 Nil、订阅 Pro 即可的选型建议,以及 AntiGravity 写死 Hydra 派发、限制切模型次数的成本控制规则。
谷歌两周内连发五个模型,从被嘲讽的“美国豆包”到性能榜全球第三,Gemini 4 Neon 的翻身仗打得漂亮。B站UP主实测后直言“不是无脑吹”,但数据确实让 Opus 5.5 压力山大。
两周五连发,谷歌终于不挤牙膏了
过去两周,谷歌顶着 GTA6 的热搜,一口气甩出 OMNI 1.2、Flash、Carbon、Hydra、Nil 五个模型,外加世界模型吉尼4。前天刚上的 Nil 更是被 UP 主形容为“直接把 Cloud Opus 5.5 按在地上摩擦”。
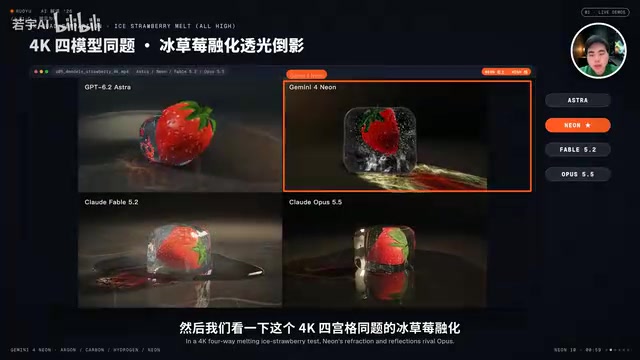
UP 主用 Nil 跑同一条提示词,纯代码直出 4K 四宫格冰草冰融化画面。透光和倒影的表现“一点都不输 Opus,也不输任何 3D 素材”。官方也秀了肌肉:10200 号代码纯素材手搓果朗风滑雪、50 万条表格公式,同一天还开放了 3D 重大更新。
实测数据:Nil 赢了 16 项,但 Opus 没输光
UP 主跑了官方 19 项对比,Nil 赢 16 项,Opus 赢 2 项,Sore 赢 1 项。独立综合榜冲到 61 分全球第三,token 速度比 Carbon 快一倍。编程智能体榜 59 分第一,单任务成本比 Opus 5.5 直接砍半。版本上下轮测试 Nil 达到 95.2%,Opus 只有 66.8%。
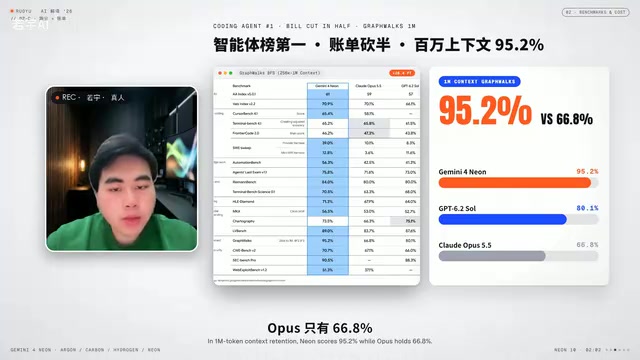
不过 UP 主也承认,屏幕这几项硬核代码测试 Opus 还是险胜。而且 Nil 有点“画牢”,同样的话比 Carbon 多图 15% 的 token。
翻身的三层真相:监管、架构与芯片
第一层真相有点黑色幽默。6 月份 Aesthetic 的 Fable 和 Metals 太猛,把美国政府招来了,商务部临时出口管制,白宫拉上安全评估机构,发布前最长审核 30 天。据海外媒体说,当年只有 Gimna3 的谷歌主动问过要不要一起审,答案是不用。谷歌 5 月也签了评估机制,但 Nil 的模型卡在第 9 页写明没有跨重大变更域值,免重跑全套审核。
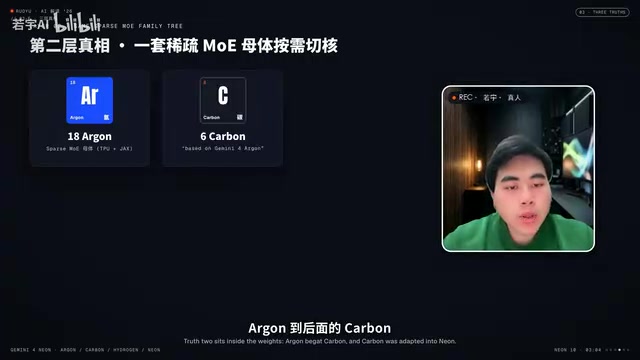
第二层真相写在模型里。从 Argon 到 Carbon,再到适配的 Metals、Nil,一套稀疏 MoE 模型按需切型号。哈萨比斯叫它“炼金术”,不宁说已经踏上了 RSI 跑步机。
第三层是芯片自研。第 7 代 TPU 不交英伟达税,有分析说推理性价比最高领先 5 成,连 Aesthetic 都在买谷歌的 CPU。再套上自家 AntiGravity,同一个 Nil 代码修复实测从 12.8% 拉到 39%,翻了三倍。安全也补上了,间接提示词注入攻击精密 4 全家 0% 被攻破。
稀疏 MoE(Mixture of Experts) 是一种混合专家架构:模型内部包含多个并行的“专家”子网络,每次推理时只激活其中一小部分(例如 Top-2 路由),而非像稠密模型那样调用全部参数。这样可以在总参数量极大的情况下,把单次计算量控制在较低水平,从而同时兼顾能力与推理成本。谷歌从 Argon 到 Carbon、Metals、Nil 的演进,正是同一套稀疏 MoE 底座按不同专家容量与路由策略切出不同型号,因此能在相近的训练体系下快速迭代出定位各异的产品。
RSI(Recursive Self-Improvement,递归自我改进) 指 AI 系统参与改进下一代自身(如生成训练数据、编写训练代码、优化架构与评测),形成代际加速的循环。哈萨比斯用“炼金术”形容模型迭代,而“踏上 RSI 跑步机”意味着迭代节奏越来越依赖模型自身产出,而非纯粹人力调参。这也是谷歌能在两周内连发五个模型的组织与技术前提,但同时也带来安全评估与审核节奏跟不上的隐忧。
间接提示词注入攻击(Indirect Prompt Injection) 指攻击者把恶意指令藏在模型会读取的外部内容里(网页、文档、邮件、代码注释、工具返回结果等),而非直接写在用户输入中。模型在执行任务时若把这些内容当作指令执行,就可能泄露数据或调用工具做危险操作。文章提到“精密 4 全家 0% 被攻破”,指的是在某一代精密测试集(4 类场景)上,Nil 对这些注入向量实现了零突破,说明其在工具调用与内容隔离层面做了针对性加固。对使用 AntiGravity 做智能体开发的用户而言,这一指标比单纯的代码通过率更关乎生产环境安全。
怎么选:Carbon 促销价是彩蛋,但别硬上 Ultra
官方价格表里藏着 11 月 30 号到期的彩蛋:Carbon 原价 4 刀/20 刀,月底前促销 2 刀/10 刀,比 Nil 的 3 刀/15 刀还便宜。所以这 10 天半夜长活交给 Carbon,早上验收;白天切 Nil 跑腿,转订阅别冲动。19.9 美元的 Pro 就有 Nil 和 5T 云盘,不必硬上 Ultra。
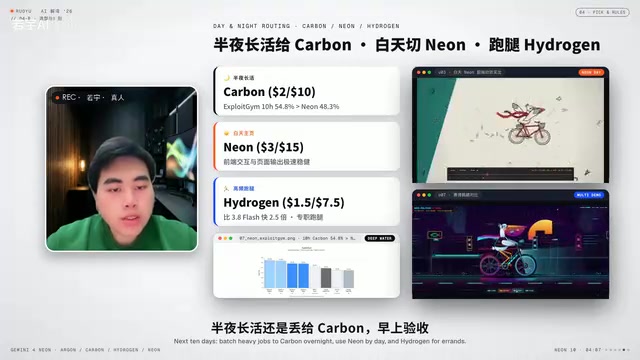
但丑话说在前面,AntiGravity 不调调确实是个额度黑洞。UP 主给了两条规则:Swarm 默认继承当前大模型,还会偷偷降回旧版模型,所以写死只派 Hydra 转,每个人独立目录,派完查日志用 AUX 特雷特开头只绘画一次;执行期别插画,切模型不要超过三次,因为每切一次缓存就清零,命中率从 92% 掉到 81%,成本高快四五倍。
UP 主最后把模型做成了一张能点的元素天梯,价格速度一眼看清,两条规则和广告贴纸都在置顶评论区。你还在准备选 AUX 5.5 还是今晚就切 NEO?评论区见。
KV 缓存(KV Cache)与缓存命中率 是大模型推理成本的核心变量。模型生成时会把已处理的上下文键值对缓存下来,后续请求若命中相同前缀,就无需重复计算,从而大幅降低延迟与费用。一旦切换模型或改动上下文前缀,缓存即失效、需重新计算,命中率骤降。文中“切一次模型命中率从 92% 掉到 81%、成本高四五倍”正源于此。因此实践中应尽量固定模型、稳定系统提示词与目录结构,把切换次数压到最低,这与“写死只派 Hydra、每人独立目录”的规则是同一套成本逻辑。
相关推荐
比格犬缉毒队:从水果到GHB的国境防线
比格犬缉毒队如何守护美国边境?本文基于《To Catch A Smuggler》实录,展现农业检测犬查获水果肉类,以及执法部门追踪GHB、可卡因走私的全过程,揭示从东南亚到圣路易斯的毒品供应链与多部门协作。
番茄高产秘诀:稳定供水如何让盆栽番茄远超地栽
一段来自YouTube的种植记录显示,容器中的番茄产量远超主菜园地栽植株。种植者认为关键在于稳定供应适量的水,而非施肥。本文分析稳定供水对番茄结果期和产量的影响,并讨论容器种植的可控性优势。
反向角色扮演:当你在游戏里成为LLM的子代理
Hacker News上出现一款反向角色扮演游戏,玩家扮演LLM的子代理执行任务。本文分析其游戏机制、AI代理热潮下的哲学意味,以及独立开发者如何用轻量交互探讨人机权力关系。