Gemini 4 Neon 实测:谷歌中型模型叫板 Opus 5.5
Gemini 4 Neon 以中型模型之姿在连贯性与长任务上比肩旗舰,但短板仍存。
谷歌 DeepMind 发布的 Gemini 4 Neon 定位中型模型,却被一位长期批评谷歌的开发者评价为“代际跃迁”。官方数据显示其在 Artificial Analysis 智能指数排名第三、落在帕累托前沿,而该 UP 主实测认为公告严重低估了它:Neon 在连贯性上大幅领先同类,能自主诊断 VPS 磁盘配置问题、无人干预完成整机环境配置,并在可视化任务中自行渲染截图交付、顺手提交修复 PR。在 TypeScript 重写项目中,它借助 swarm 不到十小时实现了其他模型十天以上未能达成的性能优化。短板在于 3D 生成偏弱、架构分析仍有幻觉。作者推测该模型本是工程反馈的试验品,因内部反响强烈而提前发布。
谷歌 DeepMind 最近发布的 Gemini 4 Neon 引发了不少讨论。一位长期批评谷歌模型的开发者兼 UP 主在深度使用后给出了罕见的高评价:这可能是目前最适合写代码的模型,甚至在多个维度上超过了 Opus 5.5 和 Fable 5.2。
他在视频中坦言,自己过去对 Argon 和 Carbon 等 Gemini 模型极为不满,但 Neon 带来的体验完全不同——用他的话说,这是一次"代际跃迁",也是谷歌第一次真正拿出能打的 Opus 5.5 竞品。
一个中型模型,为什么能叫板旗舰
据谷歌官方公告,Gemini 4 Neon 定位为中型模型,主打"前沿级智能与快速端到端任务完成",覆盖复杂软件工程、知识工作和科学工作流。在 Artificial Analysis 智能指数上,Neon 以 61 分排名第三(x-high 思考档位),仅次于更大更慢的模型;在 valves 指数上排名第二,并落在帕累托前沿上。谷歌还强调,Neon 在可控性(steerability)和新的 agent arena 指数上均排名第二。
该 UP 主认为谷歌的公告其实是"严重低估"。他实测后发现,Neon 不只是"又一个还行的中型模型",而是在连贯性上大幅领先同类。他提到,Neon 在多项基准上全面超过 Opus 5.5,价格更便宜,与 Fable 5 也咬得很紧;切换到代码模式后差距进一步缩小。
帕累托前沿是经济学与多目标优化中的概念,指在给定约束下无法在不损害其他目标的前提下进一步改进任一目标的解集。在模型评测语境中,它通常以“智能水平 vs. 推理成本/延迟”为坐标轴:落在前沿上的模型意味着在同等成本下智能最高,或同等智能下成本最低。Gemini 4 Neon 被指落在帕累托前沿,即说明它在中型模型的成本区间内提供了接近旗舰的智能,这也是“中型模型叫板旗舰”说法的量化依据。
Artificial Analysis 智能指数是一个第三方综合基准,将多项公开评测(如推理、编程、数学)的得分归一化后加权汇总为单一分数,并区分不同“思考档位”(如 x-high 表示允许模型进行更长的内部推理)。它常被用来横向比较不同厂商模型,但需注意其权重设计会影响排名,单一指数不能完全代表真实开发体验。
真实开发场景中的表现
一次让人意外的诊断
UP 主分享了一个持续测试三周的案例:他在某台 VPS 上为一个工作树创建操作排查磁盘速度问题,此前 Astra 模型反复给出无关建议。而 Neon 用同一段提示,准确指出了三个叠加因素,其中最大的一项是这台虚拟机的文件系统被格式化时按机械硬盘做的配置——这占据了大部分延迟。这个连他自己都没意识到的配置错误,被一个中型模型当场点破。
他特别称赞 Neo
的回复读起来"自然、清晰、有节奏",不需要反复纠正措辞。
从"不敢托付"到"放手让它干"
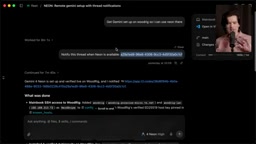
过去他从不放心把系统配置类任务交给 Gemini 模型,因为容易在细节中迷失、犯低级错误。但 Neon 完成了一次完整的机器配置:在 Windows 游戏开发机上装好相关工具链、注入认证、接入 t3 code、验证可用,然后自动到指定线程发消息通知"环境已就绪"。整个过程没有人工干预。
长时间任务的连贯性
在一次可视化任务中,模型发现自己生成的 HTML 仪表盘因工具链问题没有在前端显示。它没有原地打转,而是自己渲染、截图、用截图交付结果,随后还提交了修复该问题的 PR。UP 主认为,这种"识别问题、给出可交付结果、顺手修根因"的处理方式,是 Neon 最突出的能力。
性能实测:把 TypeScript 重写项目提速
他用自己的 ts-rust 项目做了对比测试。此前 Astra 花了七天以上,把包体积做小了但速度反而变慢;Opus 和 Fable 后续只做到比原始版本快约 20%。而 Neon 从同一基线出发,借助 anti-gravity 的 swarm 特性,在不到十小时内完成了显著优化:包体积相比前一版本大幅缩小,在温启动场景下最高提速到原来的二十倍量级,整体基准跑分也有明显提升。
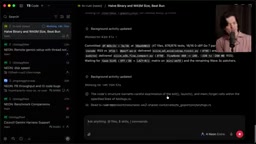
他强调,此前没有任何模型能在十天以上的窗口、消耗大量 token 的情况下做到这种速度改进,而 Neon 用不到十小时就完成了。
swarm 特性(如 anti-gravity 平台所提供)指让多个模型实例或子代理并行协作、分工处理同一任务的机制。典型做法是将大任务拆解为若干子目标,由不同代理分别探索、实现并相互评审,最后由主代理汇总。相比单线程的长上下文推理,swarm 能显著缩短墙钟时间,但也带来协调开销与结果一致性风险。文中 Neon 在不到十小时内完成优化,很大程度上得益于这种并行架构,而非单纯依赖单次推理能力。
**温启动(warm start)**指进程或构建系统在已有缓存、依赖已就绪的状态下启动,区别于从零加载的冷启动。温启动提速倍数通常远高于冷启动,因为省去了大量初始化与重复编译开销。解读“二十倍量级”这类数字时,需区分温启动与冷启动场景,否则容易高估实际用户体验的改善幅度。
依然存在的短板
Neon 并非没有缺点。在 3D 生成任务上,它的表现明显偏弱,字体等细节处理不佳,大致停留在早期模型的水平,与最新的 Opus 系列有差距。在架构分析的准确性测试中,它的 72 条陈述里有 10 条错误,略逊于 Fable 5.2、略优于 Fable 5.1,但幻觉数量比 Carbon 少了一半。
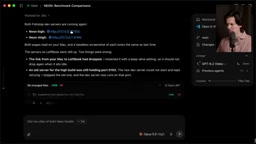
有意思的是,尽管它在"理解仓库架构"这一项排名并不靠前,实际交付的改进却是最大、最快的。UP 主由此提出一个观点:模型能否准确描述代码库,与它能否真正把活干好,并不完全是一回事。
**幻觉(hallucination)**指模型生成看似合理但与事实不符或缺乏依据的内容。在代码库架构分析这类任务中,幻觉表现为虚构不存在的模块、错误描述调用关系或臆造配置项。文中以“72 条陈述中 10 条错误”来量化,属于人工抽检式评估:它比单纯的主观感受更可复现,但样本量有限,且错误严重程度未被区分——一条关键架构判断出错,其影响可能远大于十条无关紧要的描述偏差。因此幻觉数量减半并不等同于可靠性翻倍。
模型从哪来:工程师推动的一次"抢跑"
关于 Neon 的来历,UP 主结合与 DeepMind 内部人士的交流给出了推测:研究团队此前对工程团队反馈的价值存疑,于是决定在一个中型模型上试验工程师们想要的方向。他明确表示这部分属于推测。
但他也确认了一个事实:这个模型原本没打算这么快发布。谷歌和 DeepMind 的工程师试用后非常喜欢,极力请求提前推出,希望外界停止对 Gemini 系列的负面评价,也想验证这是不是团队自己的错觉。最终,谷歌在公告中刻意低调,CEO 只称其为"新的中型模型,很适合写代码"。
UP 主对此的评价是:谷歌没敢把它叫 Gemini 5,但在他看来,这就是 Gemini 5 级别的跃迁。他还提出,当前模型竞争的前沿正在从"能力"转向"连贯性"——能否长时间保持专注、理解用户意图、稳定解释自己在做什么,而这正是 OpenAI 目前相对落后的地方。
适合谁用
如果你主要做真实项目开发、需要长时间跑复杂任务,Neon 目前的体验在同类中相当突出;如果你依赖 3D 生成或需要模型对代码库做高精度静态分析,仍需谨慎。UP 主建议通过 t3 code 配合 anti-gravity 使用,并推荐 nightly 版本以获得最新修复。至于订阅价格与 API 计费,他提到 Neon 比 Opus 明显便宜,且现金折扣力度有所加大,但谷歌在这方面的实际折扣率仍不及其他实验室。
一句话总结:这是谷歌近期最值得亲手试一次的模型,也是开发者评价体系中"好用"终于压过"跑分"的一个信号。
相关推荐
在终端里看片:Codex多智能体打造SSH流媒体服务
创作者用Codex多智能体工作流在终端搭建SSH流媒体服务,包含规划、云端异步开发、AI绘制电影场景和同步直播频道,展示AI编程工具如何快速实现个人创意。
阿拉斯加新州长:一位维基百科资深编辑
阿拉斯加当选州长 Jonathan Kreiss-Tomkins 拥有超过 13,000 次维基百科编辑记录。本文分析这一身份背后的信息素养与协作能力信号,以及对技术从业者的启示。
AI卖脸:微短剧新趋势还是好莱坞陷阱?
演员将面部授权给微短剧初创公司,用AI数字分身出演内容。这一模式在中国已流行,专家担忧其进入好莱坞后带来控制权流失、议价能力稀释等长期风险。