Gemini 4 Neon开放付费API:百万token长任务与本地LLM实测

Gemini 4 Neon付费API开放、OpenAI实时听写扩端、本地LLM跑分与GitHub Skills排名构成今日LLM动态。
文章汇总了当日LLM领域的四条动态。Google Gemini 4 Neon在付费Gemini API全面可用,单次请求最多处理100万token,输入每百万token 3美元、输出15美元,主打长而复杂的任务,但长上下文也带来成本与信息密度上的权衡。OpenAI推送实时听写功能,覆盖iOS、Android、网页和桌面端,并取消10分钟录音上限,使语音输入向连续记录工具靠拢。本地LLM实测显示,同一模型在32GB内存机器上因推理软件不同,速度从60.8 tokens/s到9.2 tokens/s相差悬殊,峰值常驻内存接近总容量。GitHub Skills按star数排名,反映编码代理正细分为可复用能力单元,但排名波动大、仅代表关注度。
Google的Gemini 4 Neon正式向开发者开放付费API,主打长上下文与复杂任务处理。同时,OpenAI升级语音输入、本地LLM跑分曝光、GitHub Skills排名更新,构成今天LLM领域的主要动态。
Gemini 4 Neon:面向长任务的大上下文模型
据YouTube频道今日LLM新闻的报道,Google Gemini 4 Neon已在付费Gemini API上全面可用。这款模型被定位为处理"长而复杂任务"的模型,最显著的特征是单次请求最多可处理100万token(或wordpiece)——相当于把一份长篇报告一次性交给模型通读处理,而不需要分段切割。
定价方面,自11月18日起,输入为每百万token 3美元,输出为每百万token 15美元,输入规模越大成本越高。这一定价结构延续了行业按输入输出分别计费的惯例,但百万级上下文意味着单次调用可能产生更高的绝对成本,开发者在设计长文档处理流程时需要提前估算。
长上下文意味着什么
百万token上下文的价值不在于"数字更大",而在于改变了任务的组织方式。过去处理长报告、多份合同或大型代码库,通常需要检索增强或分块拼接,现在可以尝试整体送入。代价则是随之上升的费用和对有效信息密度的要求——上下文越长,模型在中间段落丢失细节的风险也越值得关注。
Token 与 wordpiece:Token 是语言模型处理文本的基本单位,模型先将文字切分为 token 再编码为向量。对英文而言一个 token 大致对应 0.75 个单词,中文则常为一到两个字。Wordpiece 是 BERT 系列使用的子词切分算法,按词频把生僻词拆成更常见的片段,因此“100 万 token 或 wordpiece”指的是同一量级的输入预算。理解切分方式有助于估算:一份 10 万字的报告约对应十几万 token,百万上下文可容纳数份这样的文档,但原始字符数与 token 数并不等价。
检索增强(RAG)与分块:RAG 先从外部知识库检索相关片段,再连同问题一起送入模型;分块则是把长文档切成小段分别处理再拼接结果。两者都是为了绕开上下文窗口限制。百万上下文让“整体送入”成为可能,但 RAG 在成本、可追溯性和超长文档上仍有优势,实际工程中二者常结合使用。
“中间遗忘”现象:研究显示模型对上下文开头和结尾的信息利用较好,对中间段落的关键细节召回率偏低,长上下文并不等于均匀注意力。因此把整份文档塞入后,仍应通过明确指令、结构化提问或关键信息前置来降低遗漏风险。
OpenAI语音输入:实时听写覆盖多端
OpenAI正在推送实时听写(live dictation)功能,将语音转为文本。据同一来源,该功能将覆盖iOS、Android、网页和桌面端,同时取消此前10分钟的录音时长上限。
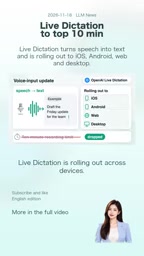
取消时长限制的实际影响值得注意:长会议、口述笔记、访谈整理等场景不再需要分段录制,语音输入从"短句工具"向"连续记录工具"靠拢。多端同步覆盖也意味着用户可以在不同设备间延续同一套输入习惯。
本地LLM实测:软件与格式决定速度
本地运行大模型是另一条并行路线。据公开测试,QEN3-8-27B在32GB内存的电脑上运行,测量短生成阶段的输出速度:使用Mirai Uzu时达到每秒60.8个token,而使用OMLX时仅为每秒9.2个token。同一模型的4-bit MLX压缩检查点占用磁盘16.1GB。
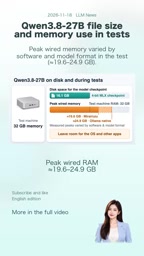
测试还统计了wired memory(必须常驻物理内存的部分),峰值区间约为19.6GB至24.9GB,并随软件与模型格式变化。这组数据给出的关键提醒是:同一模型、同一硬件,仅更换推理软件就能带来数量级的速度差异;而峰值内存接近甚至超过32GB总容量,意味着实际使用时必须为系统和其它应用留出余量。
本地部署的现实约束
对希望本地运行的开发者而言,选型不止看模型参数,还要看推理框架的成熟度、量化格式的兼容性,以及内存峰值是否留足缓冲。测试中两种软件的差距说明,工具链优化在本地场景中的权重可能不低于模型本身。
量化与 MLX:量化是把模型权重从 16 位浮点压缩到 4 位、8 位等更低精度,以减小显存与磁盘占用,代价是少量精度损失。文中 4-bit MLX 检查点即经 4 位量化的模型副本。MLX 是 Apple 为自家芯片(M 系列统一内存)设计的数组计算与推理框架,能充分利用统一内存架构;OMLX、Mirai Uzu 则是构建于其上的不同推理前端,实现细节差异会直接影响吞吐。
Wired memory(常驻内存):指不能被换出到磁盘、必须长期占用物理内存的部分,包括模型权重、KV 缓存和运行时开销。KV 缓存随上下文长度线性增长,长对话时峰值会明显抬升。32GB 机器上 19.6–24.9GB 的峰值意味着留给系统与其它应用的空间有限,超限时系统会压缩内存或换页,导致速度骤降。
GitHub Skills:AI编码代理的能力排名
在GitHub上,star项目即等于收藏。据11月18日统计,三个面向AI编码代理的Skills按所属项目获得的star数排序,统计仅计入当时仍保留在项目上的star,用于衡量关注度,质量仍需单独评估。
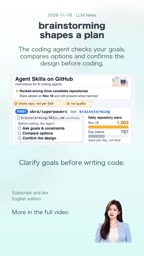
排名第一的是Obra/superpowers中的brainstorming,1903颗星,前一日为787颗;第二是Matt Pocock's/skills中的TDD(测试驱动开发),6401颗星,前一日为871;第三是OpenAI的gh-address-toggins,借助GitHub CLI与已认证访问,定位并归类当前分支PR上的评审评论、询问要修复哪些,28颗星,前一日为27。
Skills背后的工作流思路
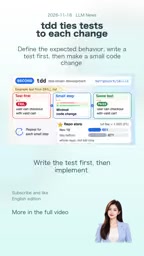
三个技能指向三种不同的代理协作模式:brainstorming让代理在编码前核对目标、比较方案;TDD让代理先写测试再小步改代码;评审评论处理则把PR反馈的筛选环节自动化。star数的单日跳变也说明,这类轻量技能正处在快速被发现和传播的阶段,排名本身波动较大,参考价值应结合具体项目质量来判断。
综合观察
今天的几条动态分布在模型能力、交互方式、本地部署与开发工作流四个层面:Gemini 4 Neon用百万上下文押注长任务场景,OpenAI把语音输入推向连续记录,本地LLM的实测数据揭示工具链差异,GitHub Skills则反映编码代理正在细分为可复用的能力单元。对开发者而言,值得跟踪的不是单一版本号,而是这些变化如何改变任务的组织方式与成本结构。
相关推荐
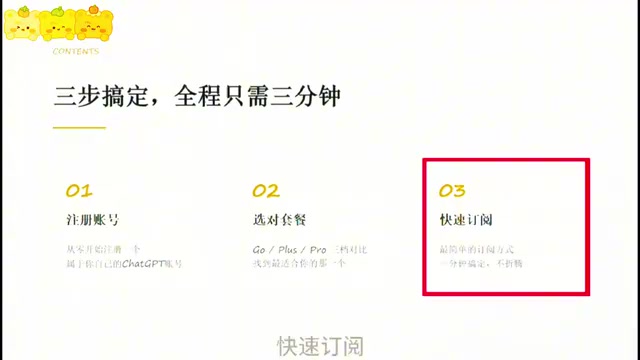
GPT Plus订阅全攻略:从注册到选档一步到位
基于B站教程整理:ChatGPT Plus订阅全流程指南。从零注册账号、Go/Plus/Pro三档套餐对比,到快速完成支付的实操步骤,帮你避开注册失败、选错档位、付款卡壳三大坑,找到最适合自己的订阅方案。
GPT-6.2 Sol/Astra发布:ChatGPT Plus订阅指南与套餐对比
GPT-6.2 Sol/Astra发布后,ChatGPT会员怎么选?本文整理B站教程精华,详解Go、Plus、Pro三档区别与适用人群,并附账号注册与快速订阅实操步骤,帮你选对套餐不花冤枉钱。
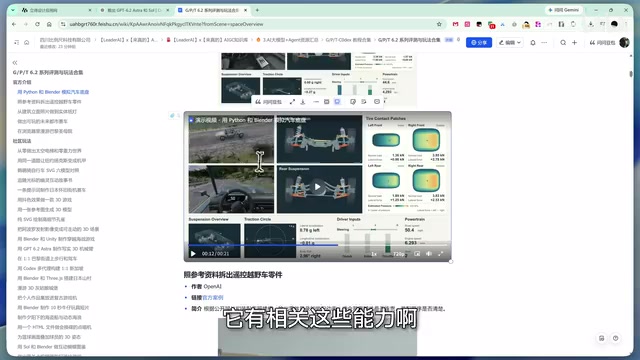
GPT 6.2 Astra/Sol社区玩法合集与深度评测
GPT 6.2 Astra/Sol 社区玩法合集与深度评测:3D建模和Computer Use能力突出,但美学对齐与意图理解短板明显。对比Claude Fable 5.2的实测数据与性价比分析,帮你判断适用边界。