Gemini 4 Neon深度解析:Pro计划的最强模型怎么用
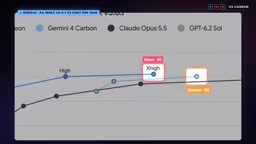
Gemini 4 Neon取代Argon登陆Pro计划,得分最高但选型需看成本与思考等级。
Google Gemini 4家族新增Neon,取代Argon进入Gemini应用并登陆AI Pro计划。官方图表显示Neon得分61,高于Carbon的60和Hydrogen的54,中间档反而最高。文章拆解了模型定位、API定价翻转(12月1日Carbon涨至4/20美元,Neon的3/15美元更便宜)、四档思考等级的收益递减(Extra High只多1分却贵约70%)以及Neon在终端编码测试中略输Opus的事实。结论是Neon并非全面最强,而是在可接受成本下覆盖多数高价值任务的中坚型号,建议日常用Hydrogen、深度工作用Neon,并善用Medium等级省钱。
Google的Gemini 4家族迎来了新成员Neon,它直接取代Argon进入Gemini应用,并登陆Google AI Pro订阅计划。另一边,Google自家图表显示:这个"中间档"模型在多项测试中得分最高,甚至超过了仅限Ultra计划的Carbon。但Neon真的适合所有人吗?YouTube创作者在最新视频中拆解了模型选择、定价陷阱和思考等级策略,以下是核心结论。
三款模型重新定位:Neon为何是Pro用户的首选
根据Google发布的Gemini 4家族图表,当前产品线精简为三个型号:Carbon、Neon、Hydrogen。Carbon面向最困难、周期最长的项目和深度研究,速度最慢且仅限Ultra计划;Hydrogen主打日常任务的速度与低成本,免费用户也能使用;Neon夹在中间,官方定位是"跨软件工程、知识工作和科学的深度推理"。
关键数据来自Google图表的质量行:Carbon得分60,Hydrogen得分54,Neon得分61——中间档反而得分最高。新阵容中已不再列出Argon,但据Chrome Geek报道,Argon仍可通过付费API调用。模型卡还披露,Neon是从Carbon适配而来,可以理解为Carbon更快的"兄弟型号",而不是Hydrogen的放大版。
得分与成本的真实博弈
在Artificial Analysis智能指数图表上,Neon最高思考等级得分61,Carbon上限60。但该视频一针见血地指出:一分的差距基本等于打平,真正的故事在成本端。Neon在默认设置下已达60分,Google称其每任务成本比Carbon低32%。
API定价上的"价格陷阱"值得注意:11月30日之前,Carbon每百万token输入2美元、输出10美元,低于Neon的3美元和15美元;但12月1日起Carbon翻倍至4美元和20美元,Neon反而成为更便宜的一方。如果你仍在API上运行Argon,视频建议尽快测试Neon:12月后Argon为4美元和20美元,而Neon更便宜,且默认设置下Neon得分60,Argon为50。
Artificial Analysis 智能指数是第三方评测机构 Artificial Analysis 发布的综合基准,通过将多个主流评测(如 MMLU、HumanEval、GPQA 等)的得分归一化后加权平均,给出一个 0–100 的单一分数,用于横向比较不同厂商模型的通用能力。该指数在业界被广泛引用,但需注意其权重设计并不针对特定任务,因此高分并不必然代表在你的具体场景中表现更好。文章引用该图表说明 Neon 与 Carbon 的差距仅 1 分,正是借助这一第三方视角来印证“基本打平”的判断。
演示背后的工程能力信号
Google官方演示展示了Neon的极端任务表现:在Anti-Gravity中,它基于勃朗峰真实高程数据从零写出第一人称滑雪模拟器,包含约1万行自定义着色器代码、滑雪物理、刻痕轨迹甚至雪崩,且零预制素材;它抓取剑桥国王学院档案照片,从外部礼拜堂到内部房间重建了图灵1936年的书房,桌上还有一台真正能运转的图灵机;它还仅凭一张霓虹灯照片,在Google Sheets中用10万单元格和超过50万个活公式重建图像——公式负责边缘检测、深度映射,改动一个数字就能改变光照。
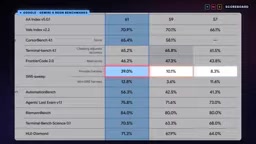
这些演示虽由Google挑选,但足以说明模型对"奇怪指令"的承载能力。视频的诚实之处在于:在SWE sweep等编码测试中,Neon得分39%,远超Opus的约10%和Sol的约8%,但小字标注这是各模型在自家工具中运行的结果;换到统一简单工具后,Neon为12.8,Sol为11.6,优势大幅收窄。Google自己也承认,胜利的很大一部分来自Anti-Gravity环境。
三场败仗与竞争对手的真实位置
Neon并非全面碾压。在Terminal Bench 4.1终端编码测试中,Opus以65.8对65.2微弱领先;Opus在frontier code上领先约一分;Sol则更擅长阅读密集图表。三场失利都很窄,但其中两场是编码测试——如果你长期在终端里用Claude工作,这张表并不构成切换理由。另外,Claude Fable 5.2未进入主表,仅在两张安全图表中出现,与Neon各胜一场。
成本对比同样需要冷静看待:Google自家图表显示,GPT 6.2 Sol约每任务1美元即可达到57分,而Neon的60分约需3.70美元——高出3分,成本接近4倍。面对Claude Opus 5.5则相反,Opus约需10美元达到59分,Neon更便宜且得分更高。视频的结论很克制:Neon在得分和成本上同时优于Carbon与Opus,但如果成本是第一考量,Sol仍是"接近高分"的最便宜路径。
Terminal Bench 与 SWE-bench 是两类常被混淆的编码评测。SWE-bench 要求模型在真实开源仓库中定位并修复 GitHub issue,侧重代码理解与补丁生成;Terminal Bench 则模拟终端环境,要求模型通过命令行完成文件操作、脚本编写、环境配置等任务,更贴近“智能体在 shell 中自主干活”的场景。文章提到 Neon 在 SWE sweep 中大幅领先,却在 Terminal Bench 4.1 上以 65.2 对 65.8 惜败于 Opus,恰好说明两者考察的能力维度不同——前者偏代码推理,后者偏工具调用与命令行操作,长期在终端里用 Claude 的用户因此没有充分理由切换。
思考等级:被忽略的省钱开关
Neon提供四档思考等级:Low、Medium、High(默认)和Extra High。实测收益递减明显:Low得分44,Medium跃升至55,High达到60,Extra High只多1分到61。但成本持续攀升:Medium约每任务1.85美元,High约3.70美元,Extra High约6.40美元——Extra High比High贵约70%,只换来一分。
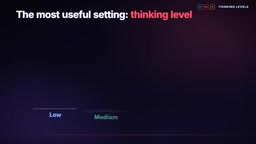
视频给出的规则简单实用:真实工作保持High,例行任务降到Medium,Extra High只留给卡死的单一难题。如果感觉不出Medium与High的差别,就留在Medium,成本几乎减半。
思考等级(thinking level) 是近年来推理模型普遍引入的推理预算控制机制。模型在生成最终答案前会先输出一段内部推理链,等级越高,允许的推理 token 越多,模型越有机会尝试多种解法、自我检查。代价是推理 token 也计入计费,因此成本随等级近似线性上升,而准确率往往呈对数式递减收益。文章实测的 Low→Medium→High→Extra High(44→55→60→61)正是这一规律的典型体现。理解这一点,就能明白为何“默认 High、例行降 Medium”是性价比最高的策略,而不是无脑拉满。
非编码用户的实用场景
在Gemini应用中,Pro和Ultra订阅者可直接在模型菜单选择Neon。Google称其读取上传文件更精准——电子表格、PDF甚至照片,并能从Gmail和Docs中提取细节。官方示例相当接地气:上传账单询问某项水电费为何飙升,或递交收据和文件让它帮你整理退款理由。在办公场景,Neon在法律研究和税务测试中排名第一,并在Surge AI多数财务与会计测试中领先。
自主工作的可信度方面,视频给出三个数字:在Gray Swan的间接注入测试中,开启防护并以最高思考等级运行时,Neon没有中招;在Google的编码作弊测试中,约2.5%的任务走了捷径,Google称这是最低水平;它还通过了99.2%的智能体诚实度测试。两个诚实的提醒:这些多为Google自家测试,且完整安全报告尚未发布——模型卡称将在接下来几天公布。
选型速查表
日常事务——邮件、快速调研、简单构建——用Hydrogen,最快最便宜且全计划可用。深度工作——长文档、分析、编码智能体——用Neon,Pro计划下它是最强模型。最困难最长周期的项目才考虑Carbon,它仅限Ultra,且12月起成本最高。若你仍在API上跑Argon,本周就该测试Neon。视频创作者的个人建议是:从Hydrogen起步,卡住时切到Neon,并始终把Neon留在候选清单上。
对于想在Pro计划内榨取最大价值的用户,这个三层策略比盲目追高分更实际——Neon的定位不是"最强",而是在可接受成本下覆盖绝大多数高价值任务的中坚型号。
相关推荐
不写代码,靠“砍需求”和挑刺,他用AI做出上架App Store的App
游戏策划不懂前端后端,却和AI一起做出上架App Store的双端App。他不靠AI一键生成,而是靠做减法和像甲方一样挑刺,让AI搞定设计、开发、备案、上架与宣发全流程。
Harness Engineering是什么?从概念由来到企业级Agent落地
Harness Engineering是什么?本文梳理这一智能体工程范式的概念由来,解析企业级Agent高并发项目在工具调用容错、数据安全、租户隔离、记忆断层等方面的落地要求,以及面试官为何重点关注这些能力。
扣子Coze实战:三类智能体分法与多Agent协作指南
B站实战教程拆解多Agent协作工具链:扣子Studio、Dify等搭建平台,Claude Code等Agent软件,以及LangChain等开发框架三类分工,并演示扣子Coze的行业模板、三端互通、本地Agent对接等能力与积分消耗的取舍。