Gemini 4 Neon实测:20美元月费反超自家旗舰
谷歌Gemini 4 Neon以20美元档位跑分反超自家旗舰Carbon,性价比突出但审美与GUI工具仍逊于Claude和GPT。
谷歌新模型Gemini 4 Neon定位非顶配,却在ModelDial V2题库中以65.4分反超自家旗舰Carbon的65分,且仅需20美元订阅即可使用。其涨分主要来自后端能力(50.5升至58.5)和可用性(59分,比Carbon高8分)。文本生成得分91.53排第三,文案风格延续谷歌“有人味”的特点;3D与前端审美较Hydrogen有进步,但仍不及Claude和GPT旗舰。死三代码测试中Neon能力分满分93.3,三道题全部一轮通过,Token效率在已测10个模型中排第三。综合来看,对前端审美要求不高的个人开发者,Neon是性价比较高的选择;若审美和GUI体验是硬指标,Claude与GPT仍有优势。
谷歌近期模型发布节奏明显加快,继Gemini Hydrogen之后,又推出了代号“Neon”的新模型。B站UP主“阿江”在第一时间进行了实测,结果有些出人意料:这个定位并非顶配的模型,在多项跑分上反超了谷歌自家的旗舰Carbon,而它的使用门槛只有20美元的订阅档位。
跑分反超旗舰,性价比成最大卖点
据B站UP主阿江的测试,Gemini 4 Neon在ModelDial V2题库中拿到65.4分,位列总榜第六,以微弱优势超过了自家旗舰Carbon的65分。在谷歌自家四个兄弟的横向对比中,Argon为56.7分,Hydrogen为59.7分,Carbon为65分,Neon以65.4分排在第一。
Neon这次的涨分主要来自后端能力,从50.5提升到58.5;可用性从48提升到59,比Carbon还高出8分。换句话说,这个模型在保持低价的同时,把之前相对薄弱的环节补了上来。对于每月只愿意付20美元的开发者来说,能用上接近甚至部分超越旗舰的模型,性价比提升非常明显。
文案能力依旧在线,但审美不是最强项
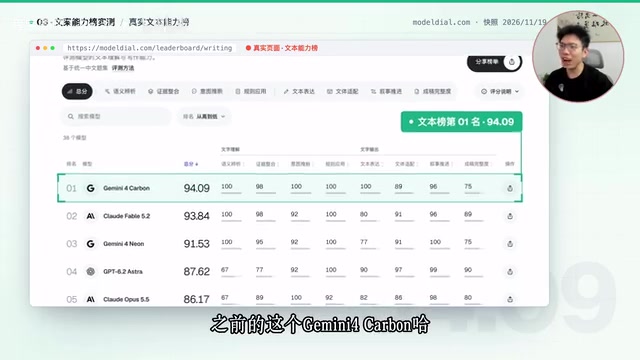
谷歌模型的文本生成能力一直口碑不错,Carbon此前在文本能力排行榜上排在第一。新模型Neon的得分为91.53,排在第三,仅次于Claude Faber 5.2,但后者的订阅成本明显更高。UP主评价称,谷歌模型的文案“特别有人味”,Neon延续了这个特点。
在3D和前端审美测试中,Neon的表现比之前的Hydrogen有明显进步,但和旗舰模型仍有差距。UP主用风力发电巡检系统和耳机沉浸式光效两个案例做了演示,Neon生成的页面交互正常、前端审美过关,但在海洋颜色、天空质感等细节上,还是能看出和GPT 6.2 Azure这类旗舰模型的差异。和Claude相比,Neon的审美也略逊一筹。
死三代码测试:能力分满分,Token效率排第三
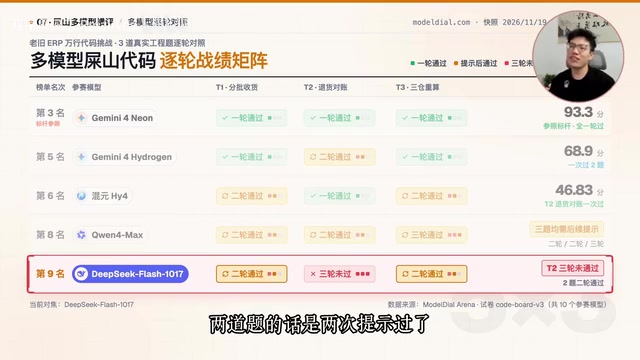
这次测试用的是三道Patheon老ERP前端题,涉及jQuery、Vue和单文件一万多行代码,UP主称这是他能找到的“比较恶心”的死三代码。Neon直接拿到93.3分,能力分满分,三道题全部一轮通过,包括回归验证、隐藏验证和自测,总计调用工具850多次,跑了三个多小时。
作为对比,上期测试的Hydrogen只得到68分,一次过了两个题,排在第五;国产模型会员室得到46.83分,三道题中两道题第一轮没过,改了第二轮提示词才搞定;DeepSeek广告在后端表现相对弱一些,T2题给了三次提示都没有通过。
效率分方面,Neon没有GPT 6.2 Azure和Sora高,Token效率这块GPT仍然更权威,Neon在已测的10个模型里排第三。
文中的“死三代码”是 UP 主对一类高难度、脏活累活型代码任务的俗称,并非官方术语。这类题目通常基于真实的老旧系统(如 Patheon 老 ERP),技术栈混杂(jQuery、Vue 并存)、单文件动辄上万行、缺少文档,考察的是模型在长上下文、跨文件理解、回归验证和隐藏用例下的综合能力。评测时不仅看最终能否跑通,还看是否一次通过、需要几轮提示词修正、调用工具的频次等。Token 效率则是另一个维度:完成同样任务消耗的 token 越少,说明模型“想得更准、废话更少”,在按量计费的 API 场景下直接关系到成本。因此“能力分满分”和“Token 效率排第三”要分开看——前者说明能干活,后者说明干得是否经济。
为什么升级到V2题库
UP主解释了ModelDial题库升级的原因:老题库V1已经被Faber 5.2和GPT 6.2“刷穿”,拉不开分差。V2把难度提了一档,目前榜首是Faber 5.2的72.9分,GPT 6.2 Azure为72.7分。新题库重点升级了后端、前端工程审美,后续还会加入知识推理等更难的题目。UP主强调站点完全靠公益维护,没有接广告和赞助。
ModelDial 是一个由社区(或个人开发者)公益维护的大模型横向评测榜单,其核心机制是用同一套题目、同一套评分流程去跑不同厂商的模型,从而把“谁更强”变成可比较的数字。榜单通常分为文本、代码、前端审美、后端能力等多个维度,并给出一个加权总分。V1 题库在运行一段时间后,被少数头部模型刷到接近满分,分数分布高度集中在顶部,导致区分度下降——这就是文中所说的“刷穿”。V2 的做法是提高题目难度、增加题型覆盖面(如后端工程、前端审美),让分数重新拉开梯度,从而能更真实地反映模型间的差距。需要注意的是,这类榜单的题目和评分规则由维护者设定,分数只能作为横向参考,并不等同于真实生产环境下的表现。
封号风险与工具链体验
UP主在总结中提到了一个现实考量:谷歌这边没有Anthropic那么严格的封号情况。他本人“挣扎了很久”之后暂时放弃了Claude,原因是封号“太猛太猛了”。不过他也吐槽了谷歌的Anti-Gravity工具,尤其是GUI版本“做得太烂”,体验上不如Claude的GUI。
综合来看,如果你的工作流对前端审美没有极高要求,Gemini 4 Neon是一个值得尝试的选择:20美元订阅、跑分接近旗舰、文案能力在线、死三代码能力满分,加上相对宽松的账号政策,对个人开发者比较友好。但如果审美和GUI工具体验是硬指标,Claude和GPT仍然有优势。
相关推荐
为什么不该在个人电脑上运行Hermes智能体
为什么不应该在个人电脑上运行Hermes等自主AI智能体?本文从安全风险、资源占用、凭证泄露和自主性需求四个角度,分析为何应将智能体部署到独立VPS而非主力设备,并给出隔离部署的实践逻辑。

Ignite 主题演讲:构建前沿生态,让 AI 落地
微软 CEO 纳德拉在 Ignite 开幕演讲中提出构建前沿生态,将 AI 进步转化为现实世界影响。本文解读这一战略背后的生态分层逻辑与落地信号。

微软Ignite大会今日开幕,AI与云成焦点
微软Ignite技术大会今日太平洋时间上午10点开幕,线上直播向全球开发者开放。本文介绍大会看点、AI与云主线以及跟进方式。