Gemini 4 Neon实测:半价挑战Opus 5.5,但有个秘密
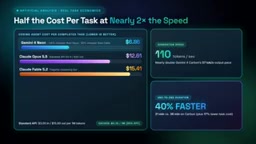
Gemini 4 Neon 以半价和双倍速度提供前沿级能力,但架构描述被删引发质疑。
Google DeepMind 推出 Gemini 4 Neon,在 Artificial Analysis 智能指数上以 61 分位列全球第三,编码智能体指数和 Cursor Bench 上领先 Claude Opus 5.5,输出速度约 110 token/秒,单任务成本约 6.86 美元,不到对手的一半。其在 UI 设计、前端和 3D 生成上进步显著,并与 AntiGravity 的 Slash Swarm 结合实现多智能体并行编排,Agent Arena 排名第二。但 Opus 5.5 在 Terminal Bench 4.1 和 Frontier Code 2.0 上仍微弱领先。发布前 Google 删除了 Neon 基于 Gemini 4 Hydrogen 的架构描述,社区质疑其本质是强化后的 Flash 级模型却按中档定价。总体而言,Neon 是当前性价比最高的日常驱动选择,但并非全面碾压。
Google DeepMind 悄然推出 Gemini 4 Neon,直接对标 Claude Opus 5.5、GPT 6.2 Sol 甚至 Fable 5.2。纸面数据上,Neon 在 Artificial Analysis 智能指数上得 61 分,在编码智能体基准上击败 Opus 5.5,并且完成复杂任务的成本仅为对手的一半。但发布前几小时,有研究者发现 Google 悄悄删除了 Neon 描述中的两行关键信息,而 Opus 5.5 在部分编码测试中依然保持领先。
速度与成本:半价背后的真实数字
根据 Artificial Analysis 的数据,Gemini 4 Neon 的输出速度约为每秒 110 个 token,几乎是 Gemini 4 Carbon 57 token/秒的两倍,将端到端多步任务时间从 36 分钟压缩到 21 分钟,缩短了 40%。在 Google Cloud 和 AI Studio 上,Neon 定价为每百万输入 token 3 美元、每百万输出 token 15 美元,缓存输入还可享受 95% 的折扣,低至 0.15 美元。
对开发者而言更直观的是单任务成本。在实际编码智能体运行中,Neon 平均每任务花费 6.86 美元,而据测试对比,Cloud Opus 5.5 为 15.61 美元,Fable 5.2 为 15.41 美元。这意味着前沿级输出成本降低超过 50%。
提示缓存(prompt caching)是理解文中 95% 折扣的关键。当请求前缀(系统提示、代码库上下文、长文档)与近期请求一致时,服务端可复用已计算的键值缓存,跳过重复的预填充阶段,只按缓存读取价计费。对编码智能体这类反复携带同一仓库上下文的场景,缓存命中率往往很高,因此标价 3 美元/百万输入 token 的实际账单可能远低于此。开发者应关注缓存的最小 token 门槛、存活时间(TTL)以及写入是否额外收费,这些细节决定了折扣能否兑现;同时输出 token 不打折,长回复仍是主要成本来源。
设计与前端能力:从被诟病到惊艳
如果你曾因旧版 Gemini 模型在 UI 设计上布局混乱、忽略指令而失望,Neon 的表现堪称翻天覆地。在 Xbox 手柄 SVG 提示词对比中,Neon 的几何形状更干净、渐变更平滑、结构更紧凑,均优于 GPT 6.2 Sol 和 Gemini 4 Hydrogen,甚至在细节创意上超过了 Opus 5.5。
在动态图形和 Web 前端方面,Neon 在视觉与呈现质量上达到 1700 ELO,比此前领先的 Sonnet 5.5 高出 45 分。测试中展示了流畅的骑自行车鹈鹕动画、现代滚动触发网页布局,以及单提示生成的东京雨夜 3D 场景。不过需要诚实指出,类似“雨城”这样的超高难度构建仍耗时 39 分钟,而 Fable 5.2 在中世纪 3D 测试中细节依然略丰富。
基准测试全表:有胜有负
在超高推理模式下,Gemini 4 Neon 在 Artificial Analysis 智能指数上以 61 分位列全球第三,领先 Opus 5.5 的 59 分和 GPT 6.2 Sol 的 57 分。它在 Artificial Analysis 编码智能体指数上以 58.6 分排名第一,VALS 指数为 70.9%,并在法律、税务、金融和电子表格基准上全面领先。在 Cursor Bench 上以 65.4 对 58.1 干净利落地击败 Opus 5.5,King Bench 4 得分为 37.9。
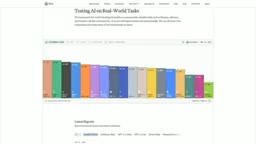
但 Opus 5.5 在 Terminal Bench 4.1 上以 65.8% 对 65.2% 微弱领先,在 Frontier Code 2.0 上以 47.3 对 46.2 保持优势。Fable 5.2 和 GPT 6.2 在最高上限任务上也有微弱优势,部分开发者指出 Neon 仍可能信任过时的 API 语法。
文中多次引用的 Artificial Analysis 智能指数,是由独立评测机构 Artificial Analysis 维护的综合基准,它把 MMLU-Pro、GPQA、LiveCodeBench 等数十个学科与推理子测试的得分,用项目反应理论(IRT)折算成单一分数,便于跨模型横向比较。该指数同时报告输出速度、首 token 延迟和每百万 token 价格,因此常被用作“智能-成本”散点图的纵轴。需要留意的是,这类聚合指数的权重由评测方设定,对编码、数学等任务敏感,对长上下文或工具调用能力的覆盖有限;且模型版本更新后分数会重测,跨期对比时应确认快照日期。文中 61 分对 59 分的差距(约 3%)在指数误差范围内,不宜解读为绝对领先。
发布前的神秘编辑:Neon 到底是什么架构?
发布前,追踪者 Lentils 发现 Google 原始模型说明中曾写道 Neon 基于 Gemini 4 Hydrogen 并使用强化学习构建,提供 Flash 级别的速度与成本。但在发布前夕,Google 悄然删除了这两处提及。Reddit、OpenRouter 和开发者社区正在争论:Neon 是否本质上是一个经过重度强化的 Flash 级架构,却以中档的 3/15 美元定价出售?尤其考虑到 Carbon 的临时折扣将于 11 月 30 日到期。
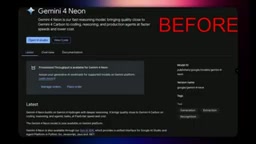
无论底层是什么,掌握 Neon 的调节技巧能省下真金白银。它提供统一的 100 万 token 上下文窗口、64,000 同步输出(后台解码可达 100 万),以及四种思考模式:低、中、高(默认)和超高。日常编辑保持中低档,仅在复杂架构任务时使用超高。
理解这场争议需要区分“模型架构”与“模型层级”。Gemini 的 Flash 系列定位为低延迟、低成本的高吞吐型号,Pro/Ultra 系列则面向高推理预算场景;同一代的不同型号通常共享预训练底座,再经不同规模的强化学习与蒸馏得到。所谓“基于 Hydrogen 构建”,意味着 Neon 可能沿用 Flash 级底座,通过 RLHF、拒绝采样和推理时计算扩展把能力推高到接近旗舰水平,而非从零训练新架构。厂商在模型卡中删除此类表述,常见原因是避免暴露参数规模、训练配方或与在售型号的替代关系,以免影响 Carbon 等产品的定价体系。
与 AntiGravity 搭配:从好模型到工作流武器
当 Neon 不再作为孤立聊天机器人,而是与 Google AntiGravity 这类智能体框架结合时,威力倍增。在 AntiGravity 内部,Neon 可解锁 Slash Swarm,作为敏锐的编排者将大型仓库任务拆分为并行切片,并调度快速的 Hydrogen 工作者同时构建。这解释了为何 Neon 在全球 Agent Arena 上以 1336 分排名第二,在任务中途用户可操控性上排名第二,并创下 Google 迄今最低的捏造率。在工作流自动化基准上,它位列 Zapier 自动化测试第一(56.3%)、Vending Bench 2 第一,并在 Agent's Last Exam 上击败 GPT 6.2 solo。
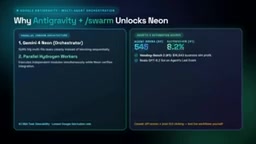
一个实际提醒:API 自动化分数不能自动证明像素级桌面点击能力。在无人监督地信任它之前,请测试自己的真实浏览器工作流。
AntiGravity 是 Google 面向“智能体优先”开发推出的 IDE 与运行时环境,其核心理念是让模型不再充当补全工具,而是作为能规划、拆解并调度子任务的编排者。Slash Swarm 即建立在这一理念上的多智能体模式:主模型把大型仓库任务切分为可并行的子切片,分派给更轻量的工作者模型并发执行,再汇总结果。这种“编排者-工作者”分层能显著压低单位任务成本,因为繁重的探索与构建由便宜模型承担,昂贵模型只负责决策。代价是引入额外的调度开销与结果一致性风险,长链路任务中错误会逐级放大,因此需要人工在中途设置检查点。
最终 verdict:值得换吗?
如果你想要一个日常驱动,用于编码智能体、干净的前端 UI、海量 100 万 token 文档和快速自主循环,同时不烧掉旗舰级预算,Gemini 4 Neon 可以说是当前 AI 领域最聪明的价值选择。保留 Claude Opus 5.5 或 Fable 5.2 用于需要绝对最大终端准确性或超细腻架构品味的场景,而在原始 token 成本最紧张时转向 GPT 6.2 Sol。
Neon 并非全面碾压,但以半价提供前沿级能力,足以让大多数开发团队重新评估订阅策略。
相关推荐
Qwen 4 Max对决Gemini 4 Hydrogen:实测游戏开发谁更强
实测对比Qwen 4 Max Preview、Gemini 4 Hydrogen与Gemini 4 Argon的游戏开发生成能力:从Minecraft克隆、3D射击到SVG交互动画,跑分最高的模型未必最好用,揭示AI编程模型选型的实战盲区。
Qwen 4 Max发布:低价混合跑分,谷歌Gemini新模型曝光
Qwen 4 Max 正式上线:2.4 万亿参数 MoE 架构、100 万 token 上下文,API 价格大幅下调但终端任务跑分落后 Opus。同时谷歌 Gemini 4 的 Oxygen、Krypton 模型曝光,GPT-6.2 Sol 疑似灰度,Anthropic 研究员预测超人类 AI 约 1.3 年后到来。
GPT-6.2 Astra发布:重建巴黎、百万级游戏生成与NVIDIA机器人革命
一周AI速览:OpenAI发布GPT-6.2 Astra与Sol,Google测试Gemini 4 Oxygen和Neon,阿里Qwen4Max与腾讯HY4 Flash以低价生成完整游戏,NVIDIA Groot 2让机器人看演示即学,加州起诉OpenAI。