Gemini 4 Neon实测:小模型追平旗舰,速度翻倍
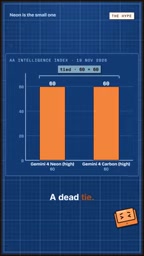
Gemini 4 Neon 与旗舰 Carbon 评分打平、速度快一倍,被误读为 AI 自我进化。
Google 新模型 Gemini 4 Neon 在独立测试中与旗舰 Carbon 评分 60 比 60 打平,完成同样工作耗时却不到一半。DeepMind 研究员称 Neon 是「小模型」并强调宁愿保守声明,却被社交平台误读为「小模型已远超旗舰」,进而衍生出「AI 自我进化」的恐慌,而事实并无任何自我改进证据。文章指出速度优势很可能来自内存带宽:每生成一个 token 都需搬运全部权重,权重越少出词越快,Neon 每秒 token 数约为 Carbon 两倍。Theo Brown 提出能力与连贯性二维框架,认为基准测试只反映能力,无法体现模型是否真正理解任务。作者建议选型时不要依赖单一分数或从档位价格猜测模型大小,而应用真实长任务端到端计时。
一次平局引发的误读
Google 的新模型 Gemini 4 Neon 在独立测试中与旗舰模型 Carbon 打成平手,完成同样的工作,耗时却不到一半。这本是工程上的好消息,却因为 DeepMind 研究员 Tianfu Fu 在 X 上的一句话,被互联网解读成了另一个故事。
他说:「Neon 其实是我们的一个小模型。」紧接着补了一句在 AI 圈罕见的话——「我们宁愿在声明上保守一些,也不想过度炒作。」结果网友的反应恰恰相反。一个大型 AI 账号直接喊出「细品」,声称 Google 的小模型已经远远领先 Carbon,随后引发了一轮关于「AI 自我进化」的恐慌。
事实是:独立评分 60 比 60,完全平局。至于 AI 自我改进,这里没有任何证据。一个小模型追平自己的大兄弟,是工程上的漂亮一周,不是奇点降临。
速度从哪来:内存带宽的账
那它为什么这么快?Google 没有公布实际参数量。但如果它确实小,答案就落在内存上。
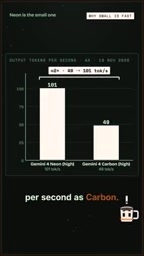
模型每生成一个 token,芯片都要把模型权重从内存里搬出来。需要搬运的权重越少,出 token 就越快。测试数据也支持这一点:Neon 每秒输出的 token 数大约是 Carbon 的两倍。
这个解释朴素得几乎不像 AI 新闻,但它指向一个常被排行榜忽略的维度——推理效率。同一张评分表上分数相同的两个模型,在实际工作流中的体感可能差出一倍。对于每天要跑大量请求的开发者来说,这个差距比榜单上的一分两分实在得多。
内存带宽(Memory Bandwidth) 指芯片在单位时间内能从显存(如 HBM)读取或写入的数据量,通常以 GB/s 计量。大语言模型的推理过程本质上是「内存受限」(memory-bound)而非「算力受限」:每生成一个 token,都需要把全部模型权重从显存搬运到计算单元一次。因此,当模型参数量减半,单次前向传播需要搬运的字节数也近似减半,在显存带宽不变的前提下,每秒可生成的 token 数就接近翻倍。这也是为什么在消费级 GPU 上运行量化后的小模型,速度提升往往远超算力比例。
值得注意的是,内存带宽与显存容量是两个不同指标:前者决定「出词快不快」,后者决定「模型能不能装下」。推理优化中常见的量化(把权重从 FP16 压到 INT8/INT4)、KV Cache 压缩、投机解码等技术,本质上都是在减少每 token 的数据搬运量或提高带宽利用率。这也解释了排行榜上分数相同、实际吞吐却相差一倍的常见现象。
Theo Brown 的改口与「连贯性」理论
对这件事反应最坦诚的,是 Theo Brown。就在 Neon 发布前五天,他还在用秒表记录 Carbon 卡顿的表现。这次他发帖说:「对不起 Google,我没看懂你的牌。」
根据真实证据公开改变判断,本来就该是这样。
他还有一个理论,解释为什么基准测试漏掉了这一点。他把模型能力拆成两个维度:
- 能力(Capability):模型在最佳状态下能做什么。
- 连贯性(Coherency):它是否真正理解自己在做什么。
在他手绘的图表上,Neon 与 Claude Fabel、Opus 处于同一水平,甚至在连贯性上比两者更靠右;而 Carbon 卡在左下角。他的结论是:基准测试只展示了能力。
这个区分值得认真对待。一个模型可以在考试里拿高分,却在长任务中反复跑偏、忘记上下文、把简单步骤做错。分数相同而耗时减半,很可能正是连贯性差异的体现——少走弯路,自然少花时间。当然,这套二维框架目前只是他个人的分析,尚无独立的量化验证。
基准测试(Benchmark) 通常指 MMLU、GPQA、SWE-bench、AIME 等标准化评测集,它们以单轮、短上下文、有明确答案的题目为主,衡量的是模型在受控条件下的峰值表现。这类评测的局限在于:题目多为一次性问答,难以反映模型在数十步、数小时的真实任务中是否保持目标一致、是否会重复犯错或遗忘中间状态。
正因如此,业界近年出现了长程任务评测(如长上下文检索、多步 Agent 任务、端到端软件工程任务)以及「人类偏好 + 实际工作流计时」等补充手段。但這些评测成本高、可复现性差,尚未形成统一标准。文章所说的「评测体系滞后」,指的正是静态题库分数与实际生产体感之间的系统性偏差——当两个模型分数相同而完成时间相差一倍时,单一分数作为选型依据的信息量已经很低。
选型建议:扔掉单一分数
这次事件给出的最实用教训,是选型方法的调整。
别再只凭一个分数挑模型。 Neon 和 Carbon 的分数完全相同,但一个的完成时间不到另一个的一半。
别再从档位或价格标签去猜模型大小。 Google 把 Carbon 当作重量级选手发布,八天后追平它的,可能恰恰是那个「小」的。
用你自己的秒表。 从你实际工作中挑一个长任务,端到端计时。这是唯一有意义的图表。
冷静看待「小模型追平旗舰」
把这件事放回合理的位置:一个更小的模型在相同评分下跑出约两倍的速度,说明推理效率的优化空间比排行榜呈现的更大。这对成本敏感的生产环境是实打实的利好。
但它不构成「AI 自我改进」的证据,也不意味着小模型已经全面超越旗舰。真正的信号是评测体系的滞后——当分数无法区分两个体感差异巨大的模型时,基准测试作为决策依据的价值就在下降。相比之下,把真实任务跑一遍并计时,虽然笨,却更接近真相。
如果想知道 Carbon 那些消失的分钟花在了哪里,原视频有更详细的时间线拆解。
相关推荐
为什么不该在个人电脑上运行Hermes智能体
为什么不应该在个人电脑上运行Hermes等自主AI智能体?本文从安全风险、资源占用、凭证泄露和自主性需求四个角度,分析为何应将智能体部署到独立VPS而非主力设备,并给出隔离部署的实践逻辑。

Ignite 主题演讲:构建前沿生态,让 AI 落地
微软 CEO 纳德拉在 Ignite 开幕演讲中提出构建前沿生态,将 AI 进步转化为现实世界影响。本文解读这一战略背后的生态分层逻辑与落地信号。

微软Ignite大会今日开幕,AI与云成焦点
微软Ignite技术大会今日太平洋时间上午10点开幕,线上直播向全球开发者开放。本文介绍大会看点、AI与云主线以及跟进方式。