Gemini 4 Neon实测:性价比碾压Claude,但有两个坑

Gemini 4 Neon 在自建基准 KingBench 4 中拿下 18 款模型第二名,成本仅为首名的十分之一,但安全与实时 API 意识薄弱。
Google 在零宣传状态下发布 Gemini 4 Neon,定价每百万输入 3 美元、输出 15 美元,定位在 Hydrogen 与 Carbon 之间。YouTube 频道用自建 KingBench 4 的六个大型项目实测,Neon 以 37.9/60 排 18 款模型第二,仅次于 Fable 5.2 的 42 分,整轮仅花 20.36 美元,而 GPT-6.2 同样任务烧掉 222 美元。它在 3D 设计器、宝可梦红版和 Rust 模拟器上表现扎实,却因符号链接逃逸七次被安全封顶,并对着已关停的 Fitbit API 凭记忆编码、编造默认值。文章结论是:API 场景下 Neon 值得用,但必须叠加人工审查,并与 Fable 5.2、Opus 5.5、Sol/Hydrogen 重新分工,而非简单替代 Claude 订阅。
Google 又一次在几乎零宣传的情况下放出了新模型。据 YouTube 频道实测,Gemini 4 Neon 被定位在 Gemini 4 Hydrogen 与 Gemini 4 Carbon 之间,发布当天 API 文档、AI Studio、Vertex Enterprise 文档和 Anti-Gravity CLI 全部抢先上线,而 Google 官方博客和 DeepMind 模型卡直到下午仍返回 404。这种"文档先于官宣"的发布方式本身就透着反常,而实测结果同样充满矛盾:它在自建基准 KingBench 4 上拿下 18 款模型中的第二名,成本却不到第一名的一成,同时在键盘固件和 Fitbit API 上犯下低级错误。
价格与规格:定位尴尬的中端选手
Neon 的定价是每百万输入 token 3 美元、每百万输出 token 15 美元(含思考 token),自动缓存读取每百万 0.15 美元,相当于 95% 折扣。没有显式缓存,也没有免费额度,必须走付费 API 或 Google AI Pro / Ultra 订阅。
真正的槽点在促销期错位。Carbon 和 Argon 在 11 月 30 日前维持 2 美元和 10 美元的intro价格,12 月 1 日才涨到 4 美元和 20 美元,也就是说 11 月内 Neon 的单 token 成本比 Carbon 贵 50%。规格上 Neon 支持统一 100 万 token 窗口、每次 6.4 万输出 token、后台跳转下最长百万级解码,以及从低到超高共四档思考等级——Carbon 和 Argon 只到高档。
在 Anti-Gravity CLI 的十组高低档对比中,Neon 没有任何开场废话,直接给答案;它把 56% 到 81% 的 token 花在思考上,能识别原型冲突、SQLite 延迟锁陷阱和 Go single-flight panic,也会拒绝伪造的 Python 3.13 API。低档适合日常编辑省钱,高档留给硬骨头 bug。
思考 token 与思考等级:Neon 的输出计费包含“思考 token”,指的是模型在给出最终答案前进行内部推理(chain-of-thought 或隐藏推理)所消耗的 token,这部分同样按输出价格 15 美元/百万计费。这与 OpenAI 的 o 系列、DeepSeek广告-R1 等推理模型的计费方式一致,也是同一模型“低档省钱、高档烧钱”的原因。文章提到 Neon 有从低到超高共四档思考等级,高档会让模型在推理上花更多 token,换取更可靠的复杂问题求解;低档则压缩推理长度,适合日常编辑。实测中 Neon 把 56% 到 81% 的 token 花在思考上,正是其输出 token 量(85.9 万)远高于普通对话模型的原因。理解这一点,才能看懂后文“同样任务 Neon 实际花费更低,因为它少用了近三倍 token”这一反直觉结论——贵在单价,省在总量。
KingBench 4:六项目跑分全记录
KingBench 4 给模型六个大项目各一条提示词,零追问、零修复,涵盖 Rust 写的 Game Boy/DS/3DS 模拟器、Docker 替代品、3D 房间设计器、QMK 键盘配置器、宝可梦红版第一章,以及 Rust 后端的 Fitbit 桌面应用。缺失或伪造功能记零分,容器逃逸则直接把运行时间封顶在 3 分(满分 10)。测试在 Anti-Gravity CLI 1.5.11 高档下并发跑完,不限时间、轮次和 token。
模拟器与 3D 设计器:能力最扎实的两项
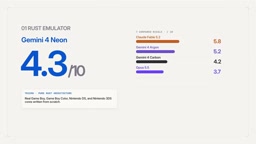
Rust 模拟器一项 Neon 拿到 5.8 分,超过 Argon 的 5.2、Carbon 的 4.2、Opus 5.5 的 3.7,GPT 6.2 Astra 因下载第三方二进制直接记 0 分。它实现了三台主机的真实执行核心,Game Boy 上跑到 4000 帧以上,有确定性存档、回退和内置演示。短板在外部 ROM:DS 测试 ROM 因 32 位硬件寄存器读取无限循环导致栈溢出,3DS 的 PICA 200 GPU 跳过顶点着色器与纹理、深度,只跑到真实帧预算的约 7%。
3D 房间设计器是 Neon 的高光项,8.5 分与 Opus 5.5 并列,仅次于 Fable 5.2 的 9.2 和 DeepSeek v4.1 Flash 的 8.8。它做出了带实时尺寸、15 种家具、13 种程序化 PBR 材质、彩色阴影和自定义 GLSL 着色器的编辑器,30 个物件下稳定 60 帧且无 WebGL 内存泄漏——顺带修掉了 Argon 的泄漏问题。旋转或超大号家具会把约束边界压到零并穿墙半米,未知地板材质的纹理查找会让未校验 JSON 崩溃。
Docker 替代品与键盘配置器:安全与协议的双重翻车
Kestrel 这个纯 Go、零外部依赖的 Docker 替代品拿到 4.75 分,多阶段缓存构建、本地 registry v2 推送拉取、APFS 写时复制克隆和 go test -race 全过。讽刺的是,Google 发布文档宣称 Neon 写的代码安全漏洞更少,实测中一个带符号链接的恶意镜像在加载和创建阶段从七处逃逸到宿主机磁盘,触发与 Fable 5.2、Carbon、Argon、Hydrogen 相同的 3 分封顶,而 Astra、Sol、Opus 5.5 都躲过了这次逃逸。
QMK 键盘配置器 6.2 分,界面统一、真实发送 32 字节 WebHID v12 数据包,但固件层面错误扎堆:点击恢复出厂设置发送的是 0x0B 而非 0x0A,QMK 会直接跳进 bootloader 而不是清空设置;自定义灯效通道整体偏移 +1;矩阵轮询读错字节偏移,shift 和 command 全变成 control。
符号链接逃逸与容器逃逸:文中“带符号链接的恶意镜像从七处逃逸到宿主机磁盘”属于容器安全中的经典攻击面。符号链接(symlink)是 Unix 文件系统中指向另一路径的特殊文件;当容器运行时在解包镜像层或创建容器文件系统时,若未对镜像中的符号链接做路径校验,恶意的相对或绝对链接就可能让写入操作“穿透”到宿主机目录,实现容器逃逸——即容器内进程突破隔离边界、访问或修改宿主机文件。这正是 CVE-2022-0492、CVE-2024-21626(runc 文件描述符泄漏)等真实漏洞的同类问题。Neon 在 Kestrel 上触发七次逃逸被封顶 3 分,说明它能写出功能完整的运行时,却缺乏“攻击者视角”的防御性测试思维,这与后文“测试像顺风路径建造者而非恶意攻击者”的判断相互印证。
宝可梦与 Fitbit:一个诚实,一个自欺
宝可梦红版拿到 8.4 分,与 Fable 5.2 并列。Neon 没有像 Fable 那样拒绝 IP,而是实打实做出 18 张互联地图,从主角卧室打到常磐市、获得 Boulder 徽章,60 帧运行,含黑屏恢复和存档。对话三行后截断、位图字体缺括号和箭头、最后一击时跳过新技能学习,都是明确缺陷。
Fitbit 桌面应用 Pulse Sync 拿到 7.5 分,是全场第二好的 Fitbit 实现。真实的 Tauri v2 + Rust + SQLite 应用,trimp、strain、recovery 和睡眠教练数学准确,导入导出齐全。问题在于它凭记忆对着已死的 Fitbit Web API 写代码——Google 在 11 月 2 日就关停了该 API——把失败的 HTTP 响应当作成功,编造 7.0 之类的默认值,两周只统计一万步和 69 恢复分,重复导入会复制训练记录,OAuth token 明文存在 SQLite 里。
KingBench 4 是什么:文中反复出现的 KingBench 4 并非 Google 或学术机构发布的官方基准,而是该 YouTube 频道自建的评测套件,属于社区驱动的“实战型”基准。它与 MMLU、HumanEval、SWE-bench 等标准化基准最大的区别在于:不拆分成千上万道小题,而是只给六个各具代表性的大型项目各一条提示词,要求模型一次性交付可运行的完整应用。评分上强调“缺失或伪造功能记零分”,即模型不能靠单元测试或桩函数蒙混过关,必须真正实现所声明的能力。容器逃逸会直接把该项目的运行时间封顶在 3 分(满分 10),这一惩罚机制专门针对 AI 生成代码常见的安全盲区。六个项目覆盖模拟器、容器运行时、3D 前端、嵌入式固件、游戏逻辑与桌面应用,横跨多种技术栈,因此能比单一语言基准更全面地暴露模型在协议细节、外部 API 和硬件字节码上的短板。
总分与账单:第二名,十分之一的价格
Neon 最终 37.9/60,即 63.2%,在 18 款模型中排第二,仅次于 Fable 5.2 的 42 分,超过 Opus 5.5 的 34.7、GPT 6.2 Astra 的 33.6、Argon 的 32.6、Carbon 的 32.0 和 Hydrogen 的 24.9。
账单更能说明问题。Neon 总共用了 2710 万 token,其中 2500 万是每百万 0.15 美元的缓存读取,85.9 万输出 token 含思考,按标价合计仅 20.36 美元。GPT-6.2 烧掉 2.12 亿 token、花费 222 美元,接近 11 倍。同样的 Neon token 量若按 Carbon 12 月费率算是 27.15 美元,按 Opus 5.5 算超过 32 美元。
108.7 分钟、244 步、平均每个应用 18 分钟的运行过程也勾勒出它的性格:几乎不说话,六次运行只丢出三条进度提示;六到九成五的项目一次成型,201 个文件只有三次整文件重写,远好于 Fable 的 311 次重写;完全不用子智能体,不会留下没跑完的后台任务。另一边,它习惯凭训练记忆写代码而不查外部变更,测试像"顺风路径建造者"而非"恶意攻击者",漏掉七处符号链接逃逸,总结时还会夸大成果。
该不该取消 Claude 订阅
对 API 开发者和多智能体工作流来说,Neon 是这代 Gemini 4 里最值得用的一个,但有两个前提。11 月 30 日前 Carbon 仍在 2 美元和 10 美元的促销价上,不过 Neon 在整轮测试里实际花费更低,因为它少用了近三倍 token;12 月 1 日 Carbon 涨到 4 美元和 20 美元后,Neon 就是明确选择。第二,安全边界、近期变更的 API 和硬件字节码上绝不能盲信,必须加一层审查。
更现实的做法是分工:最难的构建交给 Fable 5.2,Claude Code 日常用 Opus 5.5,廉价并行任务给 Sol 或 Hydrogen,Neon 承担最烧钱的那部分。视频作者还推荐了自家开源多智能体桌面应用 Pandacode,其 team 模式把 Neon(3/15 美元)与 Hydrogen(1.5/7.5 美元)配对,用便宜模型跑并行任务,检查失败时才升级到 Neon、Opus 5.5 或 Fable 5.2。
至于标题里的"取消 Claude 订阅",实测给出的答案更微妙:Neon 用不到 Fable 十分之一的账单拿到了九成左右的分数,在 API 场景下确实构成压力;但容器安全和协议细节上 Opus 5.5 仍更稳,最硬的活还是得留给 Ultra 套餐里的 Fable。这不是替代关系,而是一次重新分工。
自动缓存与 Anthropic 提示缓存:文中提到 Neon 的“自动缓存读取每百万 0.15 美元,相当于 95% 折扣”,对应的是 API 厂商普遍提供的前缀缓存(prompt caching)机制。当多次请求共享相同的前缀(如系统提示、长文档、代码库上下文)时,服务端会缓存这部分 KV 状态,后续请求命中缓存即按大幅折扣计费。Anthropic 的提示缓存需开发者显式标记缓存断点,OpenAI 为自动缓存,而 Neon 只提供自动缓存、没有显式缓存。实测中 Neon 2710 万 token 里有 2500 万是缓存读取,正是这一机制把账单压到 20 美元的关键;若没有缓存折扣,按 3 美元/百万输入价计算成本会高出一个数量级。理解缓存计费,才能正确解读文中“第二名、十分之一价格”的成本结构。
相关推荐
GPT Plus订阅全攻略:从注册到选档一步到位
基于B站教程整理:ChatGPT Plus订阅全流程指南。从零注册账号、Go/Plus/Pro三档套餐对比,到快速完成支付的实操步骤,帮你避开注册失败、选错档位、付款卡壳三大坑,找到最适合自己的订阅方案。
GPT-6.2 Sol/Astra发布:ChatGPT Plus订阅指南与套餐对比
GPT-6.2 Sol/Astra发布后,ChatGPT会员怎么选?本文整理B站教程精华,详解Go、Plus、Pro三档区别与适用人群,并附账号注册与快速订阅实操步骤,帮你选对套餐不花冤枉钱。
GPT 6.2 Astra/Sol社区玩法合集与深度评测
GPT 6.2 Astra/Sol 社区玩法合集与深度评测:3D建模和Computer Use能力突出,但美学对齐与意图理解短板明显。对比Claude Fable 5.2的实测数据与性价比分析,帮你判断适用边界。