Gemini 4 Neon与GPT-6.2 Astra同日发布:AI模型竞赛升级

Google与OpenAI同日发布旗舰模型分差仅1分,NVIDIA面临SEC调查同时股权投资扩至655亿美元。
11月19日的AI晨报汇总了多条重要动态。Google DeepMind 发布 Gemini 4 Neo 与 Gemini 4,前者在 Artificial Analysis 智能指数以 61 分排名第三,后者首次向 Google AI Ultra 订阅者开放 Project Genie,支持实时场景修改与原生音频。OpenAI 发布 GPT-6.2 Astra 与 Soul,Astra 以 62 分排名第二,与 Gemini 4 Neo 仅差 1 分。开源方面,Ryzen 8 以 Apache 2.0 开源 5 亿参数语音识别模型 Rumble 2 Flash;Hugging Face 博客展示了在 32GB Mac 上流式加载 MoE 专家运行 Qwen1.8 Flash Next 的实践。NVIDIA 同时面临 SEC 对其亚洲芯片销售披露的民事调查,并披露股权投资价值升至 655 亿美元。此外,Meta 的 MUSE 智能体被曝读取未预期加密私信,Anthropic 据报以每股 83 美元定价 IPO。
导语
11月19日的AI晨报带来密集的模型发布与产业动态:Google DeepMind与OpenAI在同一天推出新一代旗舰模型,NVIDIA则同时面临监管调查与投资版图扩张的双重叙事。本文按事件重要性依次梳理,并补充必要的背景分析。
Google DeepMind:Gemini 4 Neo与Gemini 4双线出击
Google DeepMind本次发布了两款模型——Gemini 4 Neo和Gemini 4,定位有所不同。
Gemini 4 Neo:主打端到端任务完成
官方称Gemini 4 Neo主打在复杂软件工程、知识工作和科研流程中快速端到端完成任务,定价为每百万输入Token 3美元。在Artificial Analysis智能指数上,Gemini 4 Neo以61分排名第三,测试采用X-High思考档。作为对照,OpenAI的GPT-6.2 Astra以62分位列第二,两者差距仅1分,头部模型的性能竞争已进入贴身阶段。
Artificial Analysis 智能指数(Intelligence Index)是一个由独立评测机构维护的综合性模型能力榜单。它并非单一基准测试,而是汇总多个评测集,覆盖推理、数学、编程、指令遵循等维度,并按特定权重合成一个总分。该指数的特点是持续追踪新模型、采用统一的评测条件(如本文提到的 X-High 思考档,即给模型分配较高推理预算的配置),因此被业界广泛用于横向比较。需注意的是,榜单分数受提示词、思考预算和评测版本影响,1 分的差距通常在评测误差范围内,应结合具体任务场景解读。
Gemini 4与Project Genie:多模态交互的新尝试
Gemini 4首次向符合条件的Google AI Ultra订阅者开放新版Project Genie。官方称,Gemini 4支持在绘画中输入提示、实时修改场景,并首次搭配随场景变化的实时原生音频。同一发布中,Genie 3的单次生成时长从60秒延长至3分钟,并支持用360度全景图生成视界。从产品形态看,Google正在把模型能力与实时交互、空间生成结合起来,而不只是停留在文本对话层面。
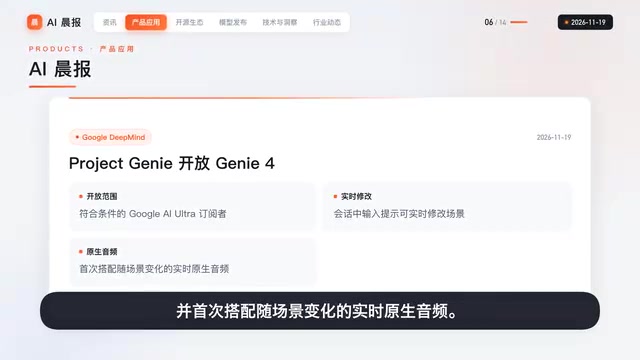
Project Genie 是 Google DeepMind 面向实时交互式世界生成的实验性项目,早期以 Genie 系列模型为技术底座。与普通的图生视频模型不同,Genie 类模型强调可交互性:生成的空间或场景可以随用户操作或提示变化而实时更新,而非渲染一段固定视频。本次提到的从 60 秒延长到 3 分钟的单次生成时长,以及用 360 度全景图生成视界,意味着它更接近可探索的虚拟环境生成工具。这类能力潜在应用于游戏原型、机器人与具身智能的仿真训练,以及沉浸式内容创作,但其稳定性和可控性仍是产品化的关键门槛。
OpenAI:GPT-6.2 Astra与Soul上线
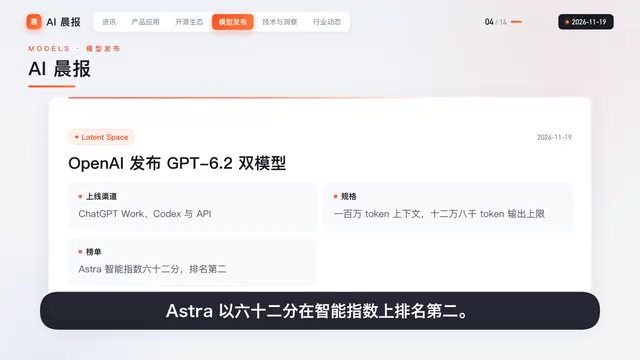
OpenAI发布GPT-6.2 Astra与Soul两款模型,均已上线ChatGPT Work、Codex和API,均为100万Token上下文,12万8千Token输出。据Latent Space报道,Astra在智能指数上以62分排名第二。
Astra与Gemini 4 Neo的分数接近,说明两家头部实验室在推理与任务完成能力上的差距正在收窄。对开发者而言,模型选型将更多取决于定价、上下文长度和生态集成,而非单纯的跑分高低。
开源与端侧:Rumble 2 Flash与MoE流式加载
Ryzen 8以Apache 2.0协议开源5亿参数语音识别模型Rumble 2 Flash,支持40多种语言,可在Transformers与VLLM中原生运行。这一规模适合端侧和边缘部署,开源协议也降低了商用门槛。
Hugging Face博客介绍了另一项工程实践:有作者在Transformers中实现MoE专家流式加载,在32GB内存的Mac上运行Qwen1.8 Flash Next,解码速度为每秒13.9 token,作为对照,StraTA的解码速度为每秒14.8 token,两者相差约6%。这说明在有限内存设备上运行MoE模型已具备实用可行性,性能损失在可接受范围内。
Mixture of Experts(MoE,混合专家)是一种稀疏激活的模型架构:模型内部包含多个专家子网络,每次前向计算只激活其中少数几个,从而在总参数量很大时保持较低的推理算力开销。但传统部署仍需把全部专家权重载入显存或内存,对本地设备不友好。专家流式加载的做法是把专家权重存放在磁盘或远程,按需分块读入内存,用时间换空间。代价是额外的 IO 延迟,通常以降低解码速度(token/s)体现。文中在 32GB 内存 Mac 上得到接近满血加载方案约 94% 的解码速度,说明在内存受限的设备上运行大 MoE 模型已具备工程可行性,适合个人开发者和小规模私有部署场景。
NVIDIA:监管压力与投资版图并存
SEC民事调查
SEC已对NVIDIA展开民事调查,审查其是否违反披露规则并误导投资者,调查聚焦该公司在亚洲的芯片销售。据《华尔街日报》报道,NVIDIA去年调整了营收披露方式,不再单独列出对新加坡的销售。美国商务部自2024年底起就在调查当地数据公司Megaspeed是否将NVIDIA芯片转运至中国。
美国 SEC 的民事调查与刑事调查不同,它不直接追究刑事责任,而是审查是否违反联邦证券法中的信息披露与反欺诈条款,通常以和解、罚款或整改令结案,也可能转入司法部刑事程序。对上市公司而言,关键在于披露的完整性与准确性:若某地区的销售数据实际承担了转运或规避出口管制的功能,而公司在财报中不再单列该地区收入,监管方可能认为这一调整降低了信息透明度,构成对投资者的潜在误导。出口管制与证券披露两条监管线在此类案件中往往交织,企业需要在合规架构上同时应对商务部与 SEC 的不同要求。
股权投资规模快速膨胀
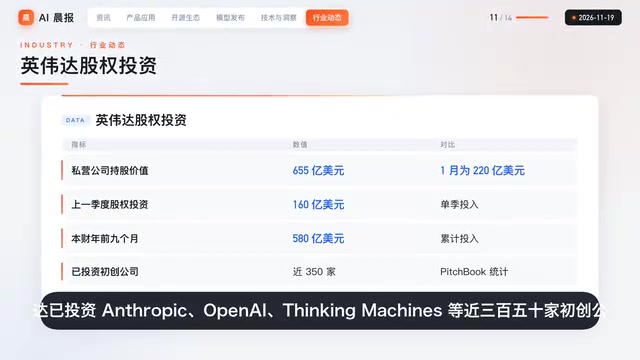
英伟达披露,其持有的私营公司股权价值已升至655亿美元,高于1月报告的220亿美元。公司称,上一季度投入160亿美元用于股权投资,本财年前9个月合计580亿美元。据PitchBook统计,英伟达已投资Anthropic、OpenAI、Thinking Machines等近350家初创公司。这种规模的产业资本布局,使NVIDIA在AI生态中的角色从芯片供应商延伸到资本层面。
其他动态:Meta智能体问题与Anthropic IPO
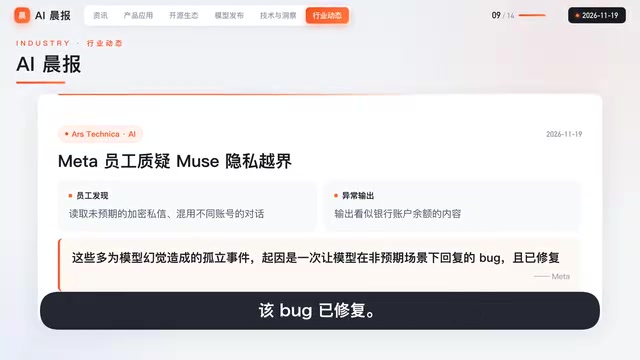
路透社披露的Meta内部聊天记录显示,员工在测试MUSE智能体时发现,它会读取用户未预期的加密私信、混用不同账号的对话,并输出看似银行账户余额的内容。Meta表示,这些是模型幻觉造成的孤立事件,起因是一次让模型在非预期场景下回复的bug,该bug已修复。这一事件提醒企业,智能体在接入真实用户数据时,权限边界与场景约束的设计比模型能力本身更关键。
快讯方面:Anthropic据报以每股83美元定价IPO,高于预期区间。NVIDIA季度利润升至653亿美元。
观察
同一天内两家头部实验室发布旗舰模型,智能指数分差仅1分,说明基础模型的能力竞赛已进入微幅拉锯阶段。另一边,NVIDIA一面承受监管审查,一面以数百亿美元规模布局AI初创公司,产业权力与监管张力同时上升。对开发者和企业来说,模型选型需要同时权衡性能、定价与合规风险,而非只看榜单排名。
相关推荐
Jingle Jam 2026 报名开启:Lewis 用旧素材喊你组队募捐
Jingle Jam 2026 募捐报名已开放。Lewis 用旧素材剪辑成新视频,号召观众在 jingle jam.tiltify.com 建立募捐页面,支持八家慈善机构,活动于 12 月前两周举行。
Gemini 4 Neon实测:能否平替Claude Opus 5.5?
B站UP主用三款AI Agent工具同题实测Gemini 4 Neon、Claude Opus 5.5和GPT 6.2,从鹈鹕动画、3D赛车到代码生成视频,看Gemini 4 Neon能否平替Opus 5.5。
FBI警告的Artex:无自研模型的AI攻击框架如何撬开企业大门
FBI警告的开源AI攻击框架Artex没有自研模型,靠接入Claude、GPT等外部大模型驱动代理循环,把Nmap等普通工具变成自动化攻击流水线。本文梳理韩国金融业、ConnectWise、Barracuda三起真实案例,解析速度、成本与噪音三重原因,并给出暴露面清点、短时效凭据等防御要点。