Gemini 4三款编程模型对比:Neon、Hydrogen、Argon怎么选
Google Gemini 4 四款模型的分工、价格陷阱与编程选型建议。
文章梳理了 Google Gemini 4 系列四款模型——Carbon、Argon、Neon、Hydrogen 的定位与差异:Carbon 处理最难的长周期问题,Hydrogen 主打快速日常执行且是唯一有免费层的,Neon 平衡深度与效率并可编排并行子 agent,Argon 定位高效前沿推理。价格方面,12 月 1 日 Argon 涨价将使最贵模型从 Neon 翻转为 Argon。在 Artificial Analysis 与 Cursor 的编码 agent 基准上,Neon 均排名第一且成本约为 Claude 顶级模型的一半,Hydrogen 次之,Argon 落后。但开发者对 Neon 的实际手感评价存在分歧。结论是新项目优先选 Neon,预算敏感选 Hydrogen,Argon 仅适合已深度绑定的团队。
Google 的 Gemini 4 系列用化学元素命名,Argon、Neon、Hydrogen 三个名字摆在一起,几乎不提供任何功能线索。加上更早的 Carbon,四个模型分别对应什么问题、价格差多少、写代码该用哪个,是很多开发者真正困惑的地方。本文基于 YouTube 科技频道的实测梳理,结合 Artificial Analysis 与 Cursor 的独立基准,把这件事讲清楚。
四款模型的分工:一句话版本
Google 自己的说法可以压缩成三句话:Carbon 处理最难、周期最长的问题;Hydrogen 负责快速、日常的执行任务;Neon 在深度与效率之间取平衡。
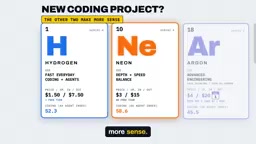
Hydrogen 于 11 月 12 日发布,定位是"快速高效",面向日常编程和 agent 工作。它是普通用户接触最多的那个——Gemini 应用、搜索、以及 API 免费层用的都是它。Google 称其完成任务的速度比 Gemini 3.8 Flash 快 2.5 倍。
Argon 是三者中资历最老的,10 月就已上线,官方定位为"高效前沿推理模型",文档里明确写着适合大多数高级软件工程与知识工作。它每轮思考比 Carbon 少,所以响应更快。
Neon 于 11 月 18 日发布,是三者中最新的。在 anti-gravity 环境中,它还能充当编排者,调度并行的 Hydrogen 子 agent。三款模型都支持 100 万 token 上下文。
价格:谁最贵要看日期
按 Gemini API 每百万 token 计价,三款模型的输入/输出价格如下:Hydrogen 为 1.50 美元 / 7.50 美元,也是三者中唯一提供免费层的;Neon 为 3 美元 / 15 美元;Argon 目前是 2 美元 / 10 美元,但这属于介绍期价格。
关键的时间节点是 12 月 1 日:Argon 的价格翻倍到 4 美元 / 20 美元。也就是说,11 月底之前,单 token 最贵的是 Neon;12 月 1 日之后,最贵的变成 Argon。Simon Willison 曾公开评价 Gemini 4 的定价"相当令人困惑",这个判断不算冤枉。
对预算敏感的团队,这个价格切换点值得单独标记在日历上——同一个模型,跨一个月成本结构就完全不同。
每百万 token 计价与介绍期价格:大模型 API 普遍按输入 token(提示词与上下文)和输出 token(模型生成内容)分别计价,单位是每百万 token 的美元数。由于输出通常更贵,且 agent 任务会反复回传上下文,实际账单往往由输入侧和轮次数量共同决定,不能只看单价。介绍期价格(introductory pricing)是厂商在新模型上线初期给出的折扣,用于吸引开发者试用,到期后恢复标准价。对成本敏感的团队,应把这类折扣截止日当作采购决策的硬约束,在预算模型里为涨价后的费率留出余量,而不是按当期价格做长期容量规划。
编程能力实测:Neon 排第一,但优势并非压倒性
Artificial Analysis 在真实工程任务上跑了一个 coding agent index,计分方式是"模型 + harness"。在 Google 自家的 anti-gravity CLI 下,Neon 得分 58.6,排名第一,基本与 Claude Fable 5.2 和 Opus 5.2 打平。更说个细节成本:Neon 每任务约 6.86 美元,而 Opus 为 12.61 美元,Fable 为 15.47 美元。
Hydrogen 在同一基准上得分 52.3,Argon 为 45.5。Cursor 用自己的基准跑出了同样的排序:Neon 63.7%,Hydrogen 57.3%。
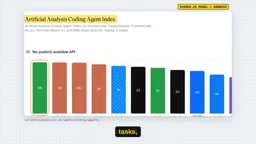
那 Argon 是不是不行?倒也不是,它只是被后来者快速超越了。在 Artificial Analysis 的 intelligence index 上,Hydrogen 以 51 比 50 略微领先 Argon,而且价格更低。Argon 仍有一个保留优势:在不知道答案时,它是"瞎猜"最少的那一档模型之一。但对新开的编程项目,另外两款明显更划算。
coding agent index 与“模型 + harness”评分:这类基准并非单纯测模型单次生成代码的质量,而是把模型放进一个完整的 agent 循环里——它会读写文件、运行命令、查看报错、再修改,直到任务完成或步数耗尽。所谓 harness 指的是驱动这个循环的外部框架(如 anti-gravity CLI、Cursor 的 agent 环境),它决定了工具调用的格式、上下文如何裁剪、失败后是否重试。因此同一模型换一套 harness,分数可能明显浮动;这也是为什么文中强调排序在两家独立基准上一致才有参考价值。计分通常综合任务通过率与消耗的 token/费用,所以“每任务成本”和得分要一起看,才能判断性价比。
intelligence index 与“瞎猜率”:Artificial Analysis 的 intelligence index 是一个跨学科、跨难度的综合能力分数,把数学、科学、代码、指令遵循等多类评测加权成一个数字,便于横向比较不同厂商的模型,但它不反映某一具体工程场景的表现。文中提到的“不知道答案时瞎猜最少”,对应的是模型的校准度(calibration)——即在不确定时是否倾向于承认不确定,而非编造一个看似合理的答案。校准好的模型在需要人工复核的高风险任务中更可控,但对“从零写新项目”这类创造性任务,校准优势带来的收益不如速度和成本明显,这解释了为何 Argon 在该指标上表现不错却仍不敌 Neon 和 Hydrogen。
开发者口碑:基准打平,手感有分歧
Cursor 关于 Neon 的帖子获得了超过 2000 个赞,Kimonismus 评价 Hydrogen 时说"Google 这一波状态惊人,我很喜欢这个模型"。
但 Neon 的实际体验反馈是分裂的。一位开发者用它做了个游戏,认为已经接近 Fable 和 Opus 的水平,不过"Fable 还是做得更好"。另一位则直言,实际用起来"感觉和 Opus 5.5 差得远"。
这就是当前的分歧所在:基准测试说打平,一部分人的手感说还差一口气。考虑到 agent 基准的分数高度依赖 harness 和任务分布,这种分歧本身并不意外,但计划把 Neon 用于生产环境的话,最好先用自己团队的真实任务跑一轮。
生产环境验证与 harness 依赖:把新模型接入生产前,仅看公开基准是不够的,因为基准的任务分布与自家业务往往差异很大——公开基准偏重算法题和标准化工程任务,而真实项目包含大量私有代码规范、内部库和特定业务逻辑。合理的做法是构建一个小规模内部评测集:从团队历史任务中抽取 20–50 个有明确成功判据的样本,用与生产一致的 harness 和提示词跑一遍,同时记录通过率和单任务成本。这样得到的排序才对自己有效,也能暴露模型在长上下文、多轮工具调用等真实条件下的退化情况。
该选哪个:按场景给结论
追求最好的 Gemini 编程能力:Neon。 编码 agent 得分最高,每任务成本约为 Claude 顶级模型的一半,是综合性价比最突出的选择。
预算有限或想免费:Hydrogen。 速度快、价格低,且直接内置在每个人的 Gemini 应用里,几乎没有试用门槛。
Argon:只适合已经深度绑定它的团队。 它的位置正在被 Hydrogen 从下方挤压,同时要留意 12 月 1 日的涨价。
Carbon:留给最难的问题。 它不在这次对比里,但定位清晰——长周期、高难度的深度思考任务交给它。
模型命名的混乱短期内大概不会改善,但选择逻辑其实不复杂:先看预算区间,再看任务是否需要编排能力,最后用真实任务验证手感。三款模型都能吃下 100 万 token 上下文,差异主要在速度、深度和单价上,而不是能力边界。
相关推荐
不写代码,靠“砍需求”和挑刺,他用AI做出上架App Store的App
游戏策划不懂前端后端,却和AI一起做出上架App Store的双端App。他不靠AI一键生成,而是靠做减法和像甲方一样挑刺,让AI搞定设计、开发、备案、上架与宣发全流程。
Harness Engineering是什么?从概念由来到企业级Agent落地
Harness Engineering是什么?本文梳理这一智能体工程范式的概念由来,解析企业级Agent高并发项目在工具调用容错、数据安全、租户隔离、记忆断层等方面的落地要求,以及面试官为何重点关注这些能力。
扣子Coze实战:三类智能体分法与多Agent协作指南
B站实战教程拆解多Agent协作工具链:扣子Studio、Dify等搭建平台,Claude Code等Agent软件,以及LangChain等开发框架三类分工,并演示扣子Coze的行业模板、三端互通、本地Agent对接等能力与积分消耗的取舍。