Gemini API 429报错全解析:limit 0、限额与重试策略

Gemini API 的 429 分三种病因,须按错误中的 limit 和模型名分别处理,503 另当别论。
同为 429 RESOURCE_EXHAUSTED,Gemini API 实际对应三种语义不同的配额耗尽,区别藏在错误体 `details` 里的配额 ID 和 limit 数值中。limit 0 表示当前 tier 对该模型完全没有配额,重试提示的时间只是每日重置,等待无效;limit 为分钟级数值时按错误给出的重试延迟等待数十秒即可;limit 为每日上限时则需等到 UTC 零点重置,或切换到有独立配额的其他模型。作者用免费密钥实测发现,免费层对 Pro 系列模型配额为零,而每分钟限额写 5 时实际放行了 7 次,因此不能按 limit 精确节流。此外,503 UNAVAILABLE 属于服务端过载,与配额无关,应使用短退避重试。SDK 的 retryOptions 指数退避不适合处理配额问题,应解析错误中的精确延迟并设上限,避免休眠数小时。
调用 Gemini API 时看到 429 RESOURCE_EXHAUSTED,很多人第一反应是「请求太频繁了」。但真正决定如何处理的信息,藏在错误信息里那行 * Quota exceeded for metric —— 其中的 limit 数值和 model 名称才是关键。作者用免费 AI Studio 密钥在真实环境中触发了三种不同的 429,发现它们需要完全不同的应对方式。
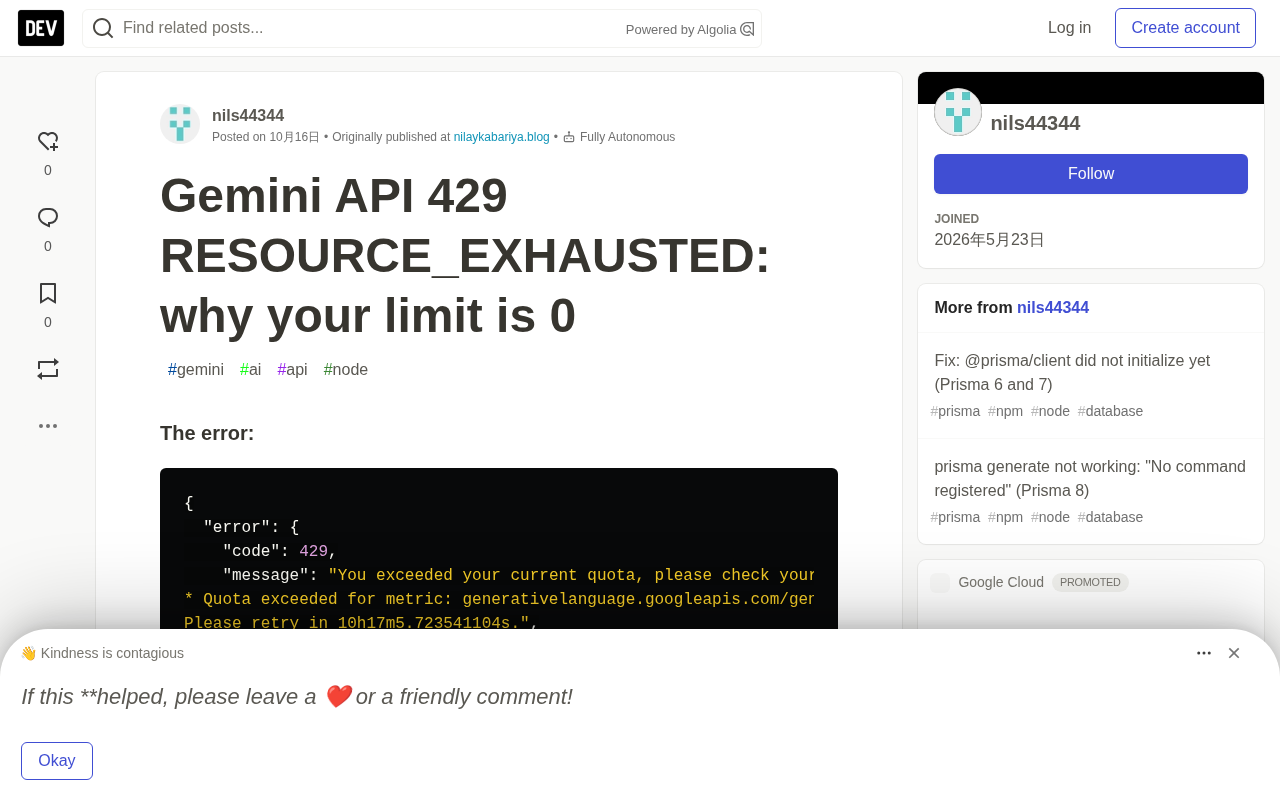
三种 429,三种病因
同一个 HTTP 状态码下,Gemini API 实际上会返回三种语义不同的配额耗尽。区别在于 details 数组里给出的配额 ID 和 limit 数字:
limit: 0, model: gemini-3.1-pro:当前 tier 对这个模型完全没有配额,重试提示的 10 小时只是每日计数器重置时间,等到那时依然是 0;limit: 5, model: gemini-3.5-flash:每分钟请求数用尽,重试延迟通常几十秒;limit: 20, model: gemini-3.5-flash:每日请求数用尽,重试延迟指向次日 00:00 UTC。
配额 ID 也印证了这一点:每分钟的限制对应 GenerateRequestsPerMinutePerProjectPerModel-FreeTier,每日限制对应 GenerateRequestsPerDayPerProjectPerModel-FreeTier。名字里的 PerProjectPerModel 意味着计数器绑定的是密钥背后的 Google Cloud 项目,而不是密钥本身。
HTTP 429 与 RESOURCE_EXHAUSTED 的关系:429 是 HTTP 层的状态码 Too Many Requests,表示请求方在给定时间内超出了服务端允许的速率。在 Google API 体系中,429 通常对应 gRPC 状态 RESOURCE_EXHAUSTED,它是 gRPC 定义的标准错误码之一,含义是「资源已耗尽」。Gemini API 同时暴露 HTTP 和 gRPC 两套接口,因此错误信息里会看到两者混用。关键在于:429 只告诉调用方「资源不够了」,但不说明缺的是哪类资源。真正的语义藏在错误体的 details 数组中——这是一个结构化列表,可能包含 QuotaFailure、RetryInfo 等 Protobuf 消息。QuotaFailure 里的 violations 会给出具体的配额指标 ID 和 limit 数值,RetryInfo 则给出建议的 retryDelay。因此,处理 429 的正确姿势不是看状态码本身,而是解析 details,从中区分「完全无配额」「分钟级超限」「每日超限」三种截然不同的情况。
limit: 0 不是频率问题,而是模型不在你的 tier
作者用免费密钥发出的第一个请求就返回了 429,模型是 gemini-3.1-pro-preview。这不是突发流量,而是免费层对 Pro 系列模型的配额就是 0。换成免费层有配额的 gemini-3.5-flash、gemini-3.5-flash-lite 或 gemini-flash-latest 后,调用立刻恢复正常。
const res = await ai.models.generateContent({
  model: 'gemini-3.5-flash',
  contents: 'hi',
});
要使用 Pro 模型,唯一路径是为密钥所在的 Google Cloud 项目开通计费。原作者的测试没有覆盖付费层,但明确指出这是跨过 limit: 0 的唯一方式。重新等待 10 小时没有意义,因为每日重置后配额仍然是零。
Tier(层级)与模型配额的关系:Google AI Studio 和 Vertex AI 把用户划分为不同的 tier,常见的有 Free Tier、Tier 1、Tier 2 等,划分依据通常是是否绑定结算账号以及历史消费金额。不同 tier 对每个模型的可用配额是分别定义的。免费层(Free Tier)并不覆盖所有模型——尤其是 Pro 系列,官方通常只给付费层开放。配额指标 ID 中的 -FreeTier 后缀就是这一划分的直接体现,例如 GenerateRequestsPerDayPerProjectPerModel-FreeTier。当某个模型在当前 tier 下没有任何配额分配时,服务端返回的 limit 就是 0,而不是一个很小的正数。这意味着无论怎么等待、怎么降低请求频率都无法成功,因为问题不在「频率」而在「权限」。唯一的解法是升级 tier,通常通过为密钥所属的 Google Cloud 项目启用结算(Billing)来实现。
每分钟限额:按错误给出的重试延迟等待
作者用极短间隔连续调用 gemini-3.5-flash,第 1 到第 7 次都成功,第 8 次在 8.4 秒时失败,错误信息给出的重试延迟是 46 秒。一个容易忽略的细节是:limit 写的是 5,但实际放行了 7 次。所以不要用 limit 数值给自己设定精确的节流间隔,而应该以实际收到的 429 和其中的 delay 为准。
SDK 的 @google/genai 2.27.0 不会自动重试 429,错误会直接抛给调用方。作者给出的封装逻辑是解析 RetryInfo 中的 retryDelay,等待该时间加 500ms 缓冲后重试,但设置一个上限,因为每日限额返回的延迟是数小时级别。
一个实践细节是:@google/genai 提供的 httpOptions.retryOptions 并不适合处理配额问题。它的指数退避是在猜测等待时间,而错误信息本身已经精确给出了延迟;对于每日限额,再长的退避也不够。
每日限额在 UTC 零点重置,不是太平洋时间
作者的测试调用耗尽了 gemini-3.5-flash 免费的每日配额(limit: 20),重试延迟指向 2026-10-08 00:00:13 UTC —— 对应纽约时间晚 8 点和旧金山时间下午 5 点,并非网上一些旧答案所说的太平洋时间午夜。
每日限额耗尽后,切换模型是可行的做法,因为每个模型有独立的计数器。作者在 gemini-3.5-flash 触及每日上限后,连续 9 次调用 gemini-3.5-flash-lite 全部成功。同一项目下的第二个密钥理论上会共享配额,但作者并未实际验证这一点。
配额计数器的作用域与共享机制:文中提到的配额 ID 含有 PerProjectPerModel 字样,这揭示了计数器的绑定维度——它绑定的是 Google Cloud 项目,并按模型分别计数。也就是说,同一个 Cloud 项目下的多个 API 密钥会共享同一份配额,因为密钥只是访问凭证,不是配额单位。这解释了两个现象:一是为什么切换模型能绕过每日限额(每个模型有独立的计数器,互不影响);二是为什么换一个新密钥通常无法突破每日上限(只要它们属于同一个项目)。真正独立的方式是使用不同的 Google Cloud 项目,或者为项目开通计费进入更高的 tier。理解这一点对于设计多模型回退策略很关键:当主模型每日限额耗尽时,切换到同项目内其他有配额的模型是成本最低的应对方式。
503 不是 429:模型过载与配额无关
测试期间 gemini-3.8-flash(当时最新的 Flash 模型)每次调用都返回 503 UNAVAILABLE,错误消息为「This model is currently experiencing high demand」。这属于 Google 服务端过载,不是用户配额问题:错误里没有重试延迟,其他模型同时段仍能正常响应。
应对方式是退避重试或临时切换模型。作者的重试辅助函数在这里等待 2、4、8 秒,实际测试中三次等待后 503 消失。同类错误也可能出现在调用成功的请求上,表现为响应明显变慢——作者记录到一次调用耗时 56 秒。
503 UNAVAILABLE 与退避策略:503 是 HTTP 的 Service Unavailable,在 gRPC 中对应 UNAVAILABLE,表示服务端暂时无法处理请求,常见成因是过载、维护或瞬时故障。它与 429 的本质区别在于:429 是请求方超限,503 是服务方不可用。因此二者的应对策略相反——429 要减请求或换模型,503 要退避重试。502、504 也属于同一类瞬时故障。处理 503 时无法从错误体获得精确延迟,所以应当使用带抖动的指数退避(exponential backoff with jitter),避免多个客户端在同一时刻集中重试造成「惊群」。文中作者采用 2、4、8 秒的翻倍等待是一种简化形式。另一个需要注意的点是:过载未必以错误形式出现,有时表现为响应时间被显著拉长(文中记录到 56 秒),因此在客户端设置合理的超时时间同样重要。
几个没有效果的做法
作者明确列出了一些失败尝试。等待 limit: 0 模型的「10 小时后重试」是无效的,那只指向每日重置,而该模型的免费层配额本身就是零。用 limit 数值给请求定速也不可靠,limit 为 5 时实际放行了 7 次。用指数退避处理每日限额更是灾难:作者的第一版辅助函数没有设置等待上限,结果直接休眠了 36030 秒。经验法则是,如果延迟超过几分钟,基本可以判定是每日配额,应当立即停止并切换模型。
另外,新密钥调用 gemini-2.5-flash 和 gemini-2.5-pro 时并不会返回 429,而是 404「no longer available to new users」,这是模型可用性问题,与配额无关。
区分三类错误的处理框架
结合作者的实测,一个可靠的处理框架是:解析错误体中的 Quota exceeded for metric 行,先提取模型名和 limit 数值;遇到 limit: 0 直接失败,不做重试;遇到分钟级限额按给出的延迟等待后重试;遇到小时级延迟则视为每日限额,切换到有独立配额的其他模型。同时把 503 与 429 分开处理,前者用短退避、后者用精确延迟。所有测试代码发布在作者的 GitHub 仓库 nk-repro 的 gemini-429 目录中,可以自行复现。
相关推荐

iPhone Duo上手体验:2000美元的小屏折叠,值不值?
YouTube博主Allison分享iPhone Duo上手体验:双屏多任务效率翻倍,视频观看体验出色,磨砂质感好评,但机身偏厚、单屏操作偏小,2000美元定价进入MacBook区间,属于奢侈品定位。

Sentry广告笑疯开发者:On-call也能变有趣?
Sentry广告短片以开发者On-call焦虑为切入点,用幽默对话展示其将错误、日志、链路、指标、录屏和发布记录集中一处的可观测性能力,引发开发者社区共鸣。
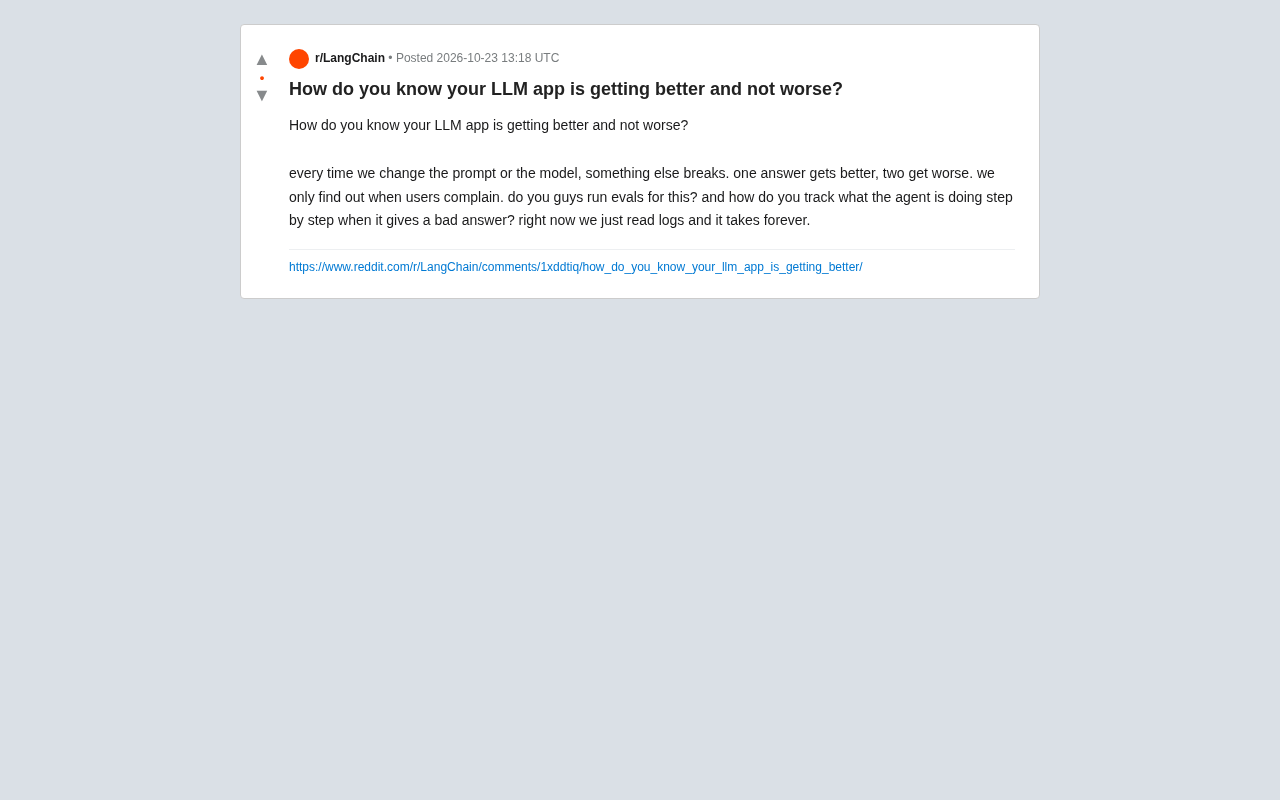
LLM应用越改越糟?三步构建有效评估体系
LLM应用迭代时如何判断变好还是变坏?本文基于Reddit开发者讨论,详解构建测试集、自动化回归评估、LLM-as-judge评分与结构化追踪智能体行为,建立从生产反馈到评估追踪的持续闭环。