Gemini API 工具检索功能预览:让智能体少花 Token 调用数百工具
Gemini API 推出 Tool Retrieval,用检索替代工具全量注入以降低 token 开销。
Google 在 Gemini API 中推出预览阶段的 Tool Retrieval 功能,针对智能体接入大量工具时提示词膨胀的痛点。常规函数调用需把每个工具的名称、描述与参数结构完整写入请求,工具数量增多会导致 token 成本上升和模型选择精度下降。Tool Retrieval 在模型生成调用之前先做相关性检索,只把匹配的工具子集交给模型,思路与 RAG 同源。其核心价值是可扩展性与成本控制,但检索质量依赖工具描述的撰写,多一步检索也可能影响延迟。该功能更适合工具池庞大、任务分散的企业级智能体,小工具集场景收益有限。
智能体工具调用的转折点
当智能体需要调用外部能力时,一个常见的麻烦是:工具太多。把数百个工具的完整定义塞进提示词,不仅消耗大量 token,还会稀释模型的注意力。Google 在 Gemini API 中推出的 Tool Retrieval(工具检索)功能,正是针对这个痛点——它让智能体在接入数百个工具的同时,只消耗更少的 token。目前该功能处于预览阶段。
这不是一个花哨的新模型能力,而是一项工程层面的优化。它把"工具选择"从一次性全量注入,变成了按需检索。对于正在构建复杂智能体系统的开发者来说,这种变化的意义可能比参数升级更实际。
工具检索解决什么问题
全量注入工具的代价
在常规的函数调用(Function Calling)流程中,开发者需要把每个工具的名称、描述、参数结构完整写进请求。工具数量少时这没问题,但当智能体需要接入几十上百个工具——比如一个企业助手要同时对接日历、邮件、CRM、工单系统、搜索、数据库查询等——提示词会迅速膨胀。
这种膨胀带来两个后果。一是成本上升,每次请求都要为这些工具定义支付 token 费用;二是准确率下降,模型面对冗长的工具列表时,更容易选错工具或漏掉合适的那个。工具检索的思路是:不把所有工具都摆到模型面前,而是先根据当前任务检索出最相关的少数几个,再交给模型决策。
函数调用(Function Calling)的机制:大模型本身不能直接执行外部操作,函数调用是让模型"请求"执行的一种协议。开发者把可用工具的 JSON Schema(名称、描述、参数类型)随请求一起传给模型,模型在需要时输出结构化的调用请求,由外部代码实际执行后把结果回传给模型。因此工具定义属于输入提示的一部分,会按 token 计费,也会占用模型的上下文窗口。工具越多,每次请求重复携带的定义就越长,这正是不加筛选地全量注入会产生固定开销的原因。
检索发生在调用之前
Tool Retrieval 的核心机制是在模型生成工具调用之前,先做一次相关性检索。开发者仍然提供工具集合,但系统会根据对话上下文筛选出匹配的工具子集。这样模型看到的工具列表更短、更聚焦,token 消耗随之降低,选择精度也有望提升。
从产品定位看,这项功能面向的是"工具规模上去了、但不想为此付出全量 token 代价"的场景。它和 RAG(检索增强生成)在思路上同源:都是先检索、再生成,只不过检索的对象从文档换成了工具定义。
RAG(检索增强生成)与工具检索的类比:RAG 的典型流程是把知识库切分成片段、建立向量索引,用户提问时先检索出最相关的若干片段,拼进提示词再交给模型生成答案,从而避免把整个知识库塞进上下文。工具检索把同一范式套用到工具定义上:为每个工具的描述建立索引,依据对话上下文召回相关工具子集。区别在于召回对象是结构化的工具 schema 而非自然语言文档,也因此对工具描述是否准确、区分度是否足够更为敏感。
对智能体开发的实际影响
成本与可扩展性
工具检索最直接的价值是可扩展性。过去开发者往往要在"接入更多工具"和"控制 token 成本"之间做取舍,工具数量一多就得拆分智能体、做路由层。Tool Retrieval 把这个取舍的边界往外推了一截:数百个工具可以放在同一个工具池里,由检索层按需取用。
对于按 token 计费的 API 来说,这直接关系到单位任务的成本。工具定义往往包含较长的描述和 JSON Schema,在全量注入模式下,这部分开销是每次请求都要重复支付的。检索机制把这部分开销压缩到与实际任务相关的工具上。
架构上的取舍
引入工具检索也意味着智能体架构多了一个环节。检索质量直接决定了模型能否看到正确的工具——如果检索层漏掉了关键工具,模型再强也无从调用。因此开发者需要关注工具描述的撰写质量,因为检索依赖这些描述来判断相关性。这和 RAG 中对文档切分与元数据的要求类似:检索的上限由索引质量决定。
另一个需要权衡的点是延迟。多一次检索意味着多一步处理,虽然官方强调 token 更少,但端到端的响应时间是否受影响,需要在真实业务中评估。对于工具集合较小、token 开销本就不高的场景,引入检索层的收益可能有限。
工具描述为何影响检索质量:在检索式工具管理中,工具的名称与描述既服务于模型的调用决策,也充当检索索引的文本依据。如果两个工具的描述措辞相近、职责边界模糊,检索层就可能召回错误或遗漏正确工具,模型再强也无法调用它从未看到的工具。实践中应让每个工具的描述明确说明"何时该用"而非只说明"它是什么",并避免多个工具共享高度雷同的表述,这与 RAG 中对文档切分粒度和元数据质量的要求是同一类问题。
谁应该关注这项功能
工具检索更适合工具数量多、任务类型分散的智能体产品。典型如企业级助手、平台型 Agent、需要聚合多个第三方服务的自动化工作流。这类场景中,工具池会持续扩张,全量注入的边际成本越来越高。
相反,如果智能体只对接少数几个固定工具,或者工具调用频率低、token 预算宽松,那么这项功能的优先级可以往后放。它解决的是规模化带来的问题,而不是所有智能体的通用必需品。
Gemini API 将 Tool Retrieval 以预览形式开放,说明这一能力仍在迭代中。对于正在评估智能体技术栈的团队,值得把它列入对比清单:在多工具场景下,检索式工具管理很可能成为下一个默认实践。
常见问题
Tool Retrieval 现在能用于生产环境吗? 官方将其定位为预览功能,通常意味着接口和行为仍可能调整,生产使用需评估稳定性风险。
它和函数调用是什么关系? 它是函数调用流程的前置优化:先检索出相关工具子集,再让模型基于子集做工具调用决策。
工具数量多少时值得启用? 原文强调的场景是"数百个工具"。工具数量较少时,全量注入的 token 开销有限,收益不明显。
相关推荐
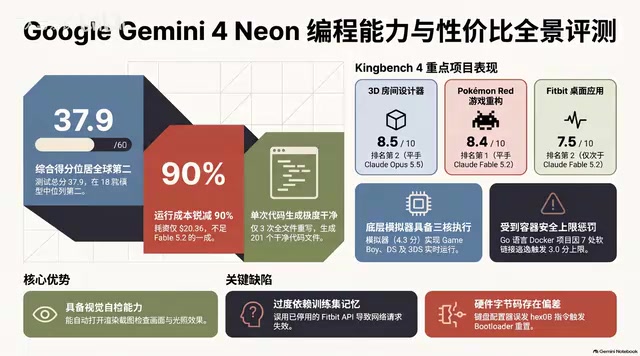
Gemini 4 Neon实测:性价比之王还是自信的灾难?
Gemini 4 Neon 实测深度解析:百万 token 上下文、四档思考级别,KingBench4 一遍过写 201 个文件,成本仅为 Fable 5.2 的十分之一。但它会靠幻觉假数据蒙混、留下 7 个符号链接逃逸漏洞、把键盘写成砖。性价比与危险并存,多模型议会审查才是破局关键。
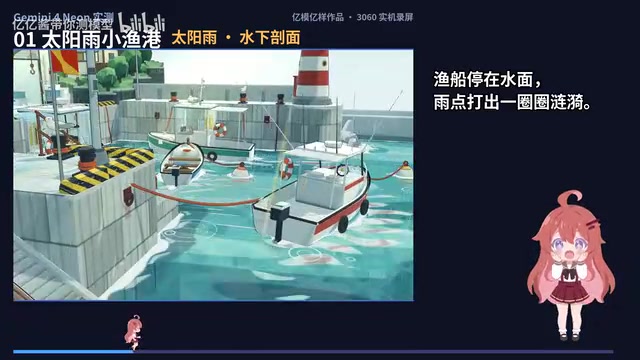
谷歌Gemini 4 Neon实测:6个3D作品惊艳与翻车
谷歌Gemini 4 Neon在3060笔记本上实测6个3D作品:太阳雨渔港细节惊艳,机械键盘配置器完成度高,但软糖物理形变过头、帝王像人脸偏方。多源测评交叉验证,审美在线但物理与人脸是短板。
Gemini 4 Neo写小说网文实测:AI味淡、对话有质感
B站UP主首发测评Gemini 4 Neo写小说网文能力:实测三国穿越开篇生成,AI味淡、对话有情绪质感、危机感塑造到位,并对比4A/4H/4C四个模型差异,演示拆纲续写与审稿纠错全流程。