Gemini Omni 1.2 Flash发布,字节C-Dance靠什么守住牌桌?

谷歌Gemini Omni 1.2 Flash以对话式编辑和8元一条的价格,重构AI视频生产逻辑。
谷歌发布 Gemini Omni 1.2 Flash,在文生视频与图生视频双榜登顶,价格降至上一代七折,一条15秒视频约8元,仅为竞品 C-Dance 2.5 的三分之一。文章认为其真正冲击不在画质,而在交互与成本结构:多轮对话式编辑让同一段视频可逐轮精修,表演与构图保持不变,无需重写提示词;配合低分辨率起草、对话修改、一键升清的工作流,用户只为最终镜头付费。作者指出,C-Dance 在单次生成审美与国风质感上仍属第一梯队,但谷歌在成本控制与工程化落地上拉开了维度差距,国产模型需在极致审美与低价、多轮对话基建之间做出战略取舍。
谷歌刚刚发布 Gemini Omni 1.2 Flash,文生视频、图生视频双榜第一,价格直接砍到上一代的七折——一条视频只要 8 块钱,仅为竞品 C-Dance 2.5 的三分之一。这不是一次普通的模型迭代,而是把 AI 视频的成本结构和操作逻辑同时掀翻。
从"抽卡"到"对话":交互范式变了
过去用 AI 做视频最崩溃的环节是抽卡:生成错了,改一个细节,整段推倒重来,钱和时间一起烧掉。Omni 1.2 Flash 把这套逻辑彻底换掉——它支持多轮对话式编辑。
背景不对,说一句"换";光线太暗,说一句"调亮";想投抖音,说一句"切竖屏"。同一段 15 秒的视频可以逐轮精修,前面的表演和构图纹丝不动,不用重写提示词,也不用重新生成。
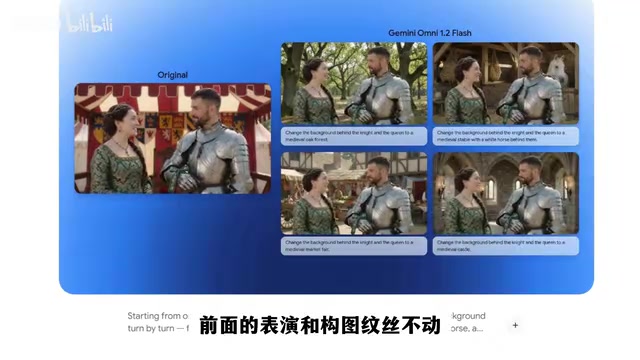
这意味着什么?做一条模板视频,就能像聊天一样批量"聊"出几十条针对不同人群、不同平台的广告变体。过去按天算的工作流,现在按分钟算。视频生成从"单次赌博"变成了"可迭代的工程流程",这是交互层面的根本性变化,而不只是画质提升。
所谓"抽卡",源自手游的随机抽取机制,在 AI 生成领域被借用来形容一种典型工作流:每次生成结果都带随机性,用户只能反复提交提示词,靠次数去撞出满意的一张图或一段视频。这种模式的核心痛点在于不可控——提示词与输出之间没有稳定的映射关系,改动一个词可能连带改变构图、光影和人物姿态,导致"改一处、崩全局"。抽卡式工作流的隐性成本极高:每次失败生成都要付费,创作者的时间大量消耗在筛选和重试上,且结果难以复现,团队协作时无法沉淀可复用的生产规范。多轮对话式编辑的意义正在于把这种概率性产出转成确定性迭代,让每次修改只作用于目标维度,从而把视频生成纳入可控的工程流程。
价格与工作流:降本设计贯穿始终
价格方面,720p 每秒 0.07 美元,一条 15 秒的片子算下来 1.05 美元(约合 8 元人民币)。更关键的是,工作流本身就是降本设计:先用 360p 或 720p 快速起草,对话修改到位后,再一键升到 1080p 甚至 4K。你不再为抽卡买单,只为最终那个对的镜头付费。
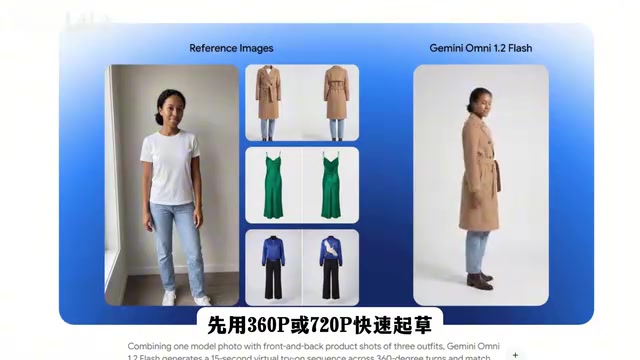
画质和一致性也跟上了:角色、产品、品牌色在不同镜头角度下不飘移,口型同步更自然,FPV 穿越、环绕运镜的跳切大幅减少。对于需要批量产出广告素材的团队来说,这种"起草—精修—升清"的流水线,比单次生成的惊艳度更有商业价值。
文生视频模型的价格通常按"每秒输出时长"计价,而非按次或按 token,因为视频的算力消耗随时长和分辨率呈近似线性甚至超线性增长。分辨率对成本的影响尤为显著:像素总量大致按分辨率的平方增长,从 720p 升到 1080p,单帧计算量约增加一倍以上,4K 则更高。这正是"低分辨率起草、高分辨率定稿"这套流水线在经济上成立的原因——把昂贵的算力只花在已经确认正确的那一版上。对比之下,传统一次性生成模式中,用户在低质量结果上的每一次重试都按最终分辨率计费,浪费被放大。理解了这一计价结构,就能明白为何"起草—精修—升清"不只是操作习惯的改良,而是对视频生成成本曲线的直接重构。
国产模型的真正差距在哪?
看到这里有人会说:国内 AI 视频模型那么多,尤其字节的 C-Dance,国风审美和画面质感绝对是当红炸子鸡,很多人觉得国内 AI 视频早就跟老美并驾齐驱了。
但面对 Omni 1.2 Flash,得客观聊聊背后的差距。论单次生成的视觉惊艳度,C-Dance 绝对是第一梯队——它的审美、它的中国风,谷歌这个"老外"真不一定学得会。但论控制成本和工程化落地,谷歌这次把桌子掀了:不到 8 块钱的成本,加上多轮对话这种傻瓜式操作,还有直接开放的底层 API。
打个比方:C-Dance 是一把工艺绝伦的绝世好剑,而谷歌直接把枪炮流水线搬出来了。单点审美优势与系统化工程能力,是两种不同维度的竞争。
"工程化落地"在 AI 模型竞争中通常指三件事:一是成本可控,即单位产出的价格能支撑商业化批量使用;二是流程可集成,即通过稳定的 API 把模型嵌入企业已有的内容生产与投放系统;三是结果可复现,即相同输入在多次调用中保持一致性,便于质量管理和规模化复制。单次生成的视觉惊艳度属于模型能力的"上限",而工程化决定的是"下限"与"吞吐量"——后者才直接对应广告、电商等行业的真实预算。一个模型即使画面更美,若价格高、接口不稳、每次结果漂移,就难以进入批量生产环节。因此两者的差距不是审美优劣之争,而是能否把模型能力转化为可计价、可调度、可规模化的生产力。
字节的下一步:审美还是基建?
那么问题来了:当谷歌把成本打到几块钱、把操作变成纯聊天的时候,国产模型比如字节的 C-Dance,下一步该靠什么继续留在牌桌上?
是继续死磕极致的画面和国风审美,还是快速跟进白菜价和多轮对话的工程化基建?
更关键的是:如果 C-Dance 明天也把价格打五折,甚至开放同样的多轮对话功能,作为创作者的你会怎么选——继续支持国产的本土化生态,还是转身投入谷歌这近乎白嫖的算力池?
从内容创作者的实际决策看,答案可能不是二选一。本土化生态在中文提示词理解、国风素材、平台适配上有天然优势;而谷歌的价格和多轮编辑能力,对批量投放的广告团队诱惑极大。真正的分野在于:谁能把"便宜"和"可控"同时做到位,谁就能留住创作者。
这场竞争的下半场,比的不是谁生成的第一帧更惊艳,而是谁能把视频生产变成一条稳定、廉价、可对话的流水线。
相关推荐
 科技前沿
Memorias:用AI传记作家把你的故事变成书
Memorias 是一款 AI 传记作家工具,通过对话式访谈将你的口述故事整理成回忆录,自动映射人物、地点与年份,支持照片与 EPUB/PDF/DOCX 导出,按次付费。
 科技前沿
mamitsu:让社交视频自动转成JSON的API与MCP
mamitsu是一款在Product Hunt上发布的API和MCP服务器,能将社交视频中的画面、音频和配文解析为JSON结构化数据,适用于食谱提取、产品信息抓取等开发者场景。
 科技前沿
GitHub日报·11月08日:Agent 基础设施全面开花
Deep dive into 7 new GitHub trending projects today