Gemini接入谷歌商家资料:AI如何成为中小企业的专属业务伙伴

Gemini的新定位:从通用助手到懂你品牌的伙伴
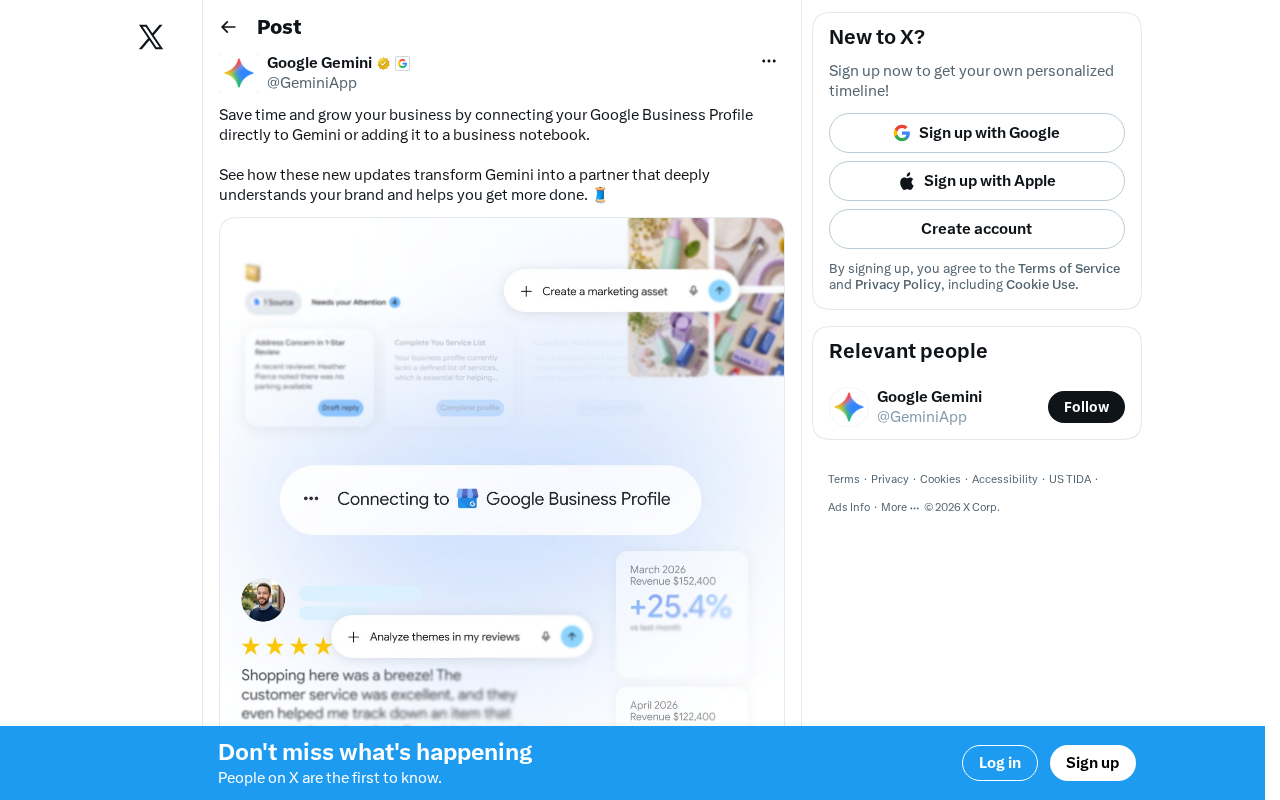
谷歌近期宣布了一项重要更新:允许企业将 Google Business Profile(谷歌商家资料) 直接连接到 Gemini,或将其添加到专属的业务笔记本(business notebook)中。这一改动看似不起眼,却代表着 AI 助手在企业服务领域的关键进化——从"什么都懂一点"的通用工具,转变为"深度理解你品牌"的专属合作伙伴。
背景知识:Google Business Profile 前身为 Google My Business,是谷歌为本地商家提供的免费业务管理平台,全球活跃商家资料超过2亿个。商家可通过它管理在谷歌搜索和地图中的展示信息,包括营业时间、联系方式、照片、评价回复等。对于本地搜索流量而言,一份完善的 Business Profile 往往直接决定商家能否出现在"本地三件套"(Local Pack)结果中,进而影响到店率和在线转化。所谓"本地三件套",是指谷歌搜索结果页中地图下方展示的三条本地商家推荐卡片——研究数据显示,出现在这一位置的商家点击率比普通自然搜索结果高出约44%,对餐饮、零售、服务业等依赖本地客源的业态而言具有决定性的流量价值。本地三件套的排名算法综合考量三大核心因素:相关性(商家类目与用户搜索意图的匹配程度)、距离(商家位置与用户或搜索地点的地理远近)和知名度(涵盖评价数量与评分、引用一致性、外部链接等信号)。这意味着 Business Profile 资料的完整度、更新频率与评价互动质量,直接影响商家在数亿次本地搜索中的竞争结果——而 Gemini 读取这些数据后,便有能力从算法视角为商家提供针对性的优化建议。
对于中小企业主而言,时间和精力永远是稀缺资源。谷歌此次更新的核心卖点正是"节省时间、助力增长"(Save time and grow your business)。通过打通商家资料与 Gemini 之间的数据壁垒,AI 能够基于企业的真实经营信息提供更有针对性的建议,而非泛泛而谈的通用回答。
为什么"连接商家资料"是关键一步
上下文决定 AI 的实用性
大语言模型的输出质量高度依赖于上下文。过去,当你向 Gemini 咨询"如何提升我店铺的曝光"时,它只能给出一套放之四海而皆准的营销建议。但当 Gemini 能够读取你的 Google Business Profile 后,情况就截然不同了。
这一机制在技术层面对应的是检索增强生成(RAG,Retrieval-Augmented Generation)——在模型生成回答之前,先从外部知识库中检索与问题相关的信息,再将其作为上下文一并传入模型。RAG 技术的核心价值在于:模型不再依赖训练时习得的泛化知识,而是能够基于真实、最新的业务信息生成回答。
RAG技术深度解析: RAG 的工作流程通常分为三个阶段:首先,将外部文档切分成语义片段并转化为**向量嵌入(Vector Embedding)**存入向量数据库;其次,用户提问时同步将问题向量化,通过相似度检索找出最相关的知识片段;最后,将检索结果与原始问题拼接成完整提示词传给大模型生成答案。向量嵌入的本质是将文本映射到一个数百至数千维的数值空间——语义相近的文本(如"营业时间"与"开放时段")在这个空间中的向量距离也更近,这使得检索能够突破关键词精确匹配的局限,实现真正意义上的"语义搜索"。常用的相似度计算方法包括余弦相似度(Cosine Similarity)和欧氏距离,主流向量数据库有 Pinecone、Weaviate 和谷歌自家的 Vertex AI Vector Search。这一架构有效解决了大模型的两大固有缺陷:训练数据的时效截止问题(模型不知道最新信息)和幻觉问题(模型可能编造不存在的事实)。当 Business Profile 作为 RAG 数据源时,商家的营业时间、地址、服务类目等结构化数据会被实时检索注入,使模型的回答建立在真实可验证的第一方数据之上,而非模型对"典型餐厅"或"典型零售店"的统计印象。
多模态数据融合的工程挑战: 谷歌将Business Profile与Gemini打通的背后,涉及结构化数据与非结构化数据的融合处理技术。商家资料中的营业时间、坐标、类目标签属于高度结构化的数据,可直接序列化为模型可读的 JSON 格式注入提示词;而客户评价文本、商家动态帖子则是典型的非结构化数据,需要先经过语义分块(Semantic Chunking)和向量化处理才能进入检索管道。现代多模态 AI 系统在整合这两类数据时,通常采用"混合检索"(Hybrid Retrieval)策略——对结构化字段使用精确匹配(Exact Match),对非结构化文本使用向量相似度检索,最终通过互惠排名融合(Reciprocal Rank Fusion,RRF)算法将两路结果合并排序,从而在精准性和语义灵活性之间取得平衡。这一工程细节决定了 AI 能否同时准确回答"你们周日几点关门"(结构化查询)和"客户对你们服务最常见的抱怨是什么"(语义分析)这两类截然不同的问题。
谷歌将 Business Profile 接入 Gemini,本质上是将商家的第一方经营数据作为动态上下文注入,使这一技术优势对普通商家触手可及。AI 可以直接获取你的营业时间、经营类目、客户评价、地理位置及历史发布内容等关键信息。这意味着它给出的建议不再是"应该多回复评论"这类空话,而是能针对店铺具体差评制定回应策略,或根据所在行业和区域提供更精准的推广方向。
业务笔记本:为品牌构建专属知识库
除了直连 Gemini,谷歌还提供了将商家资料添加到"业务笔记本"的选项。这一功能类似于为企业打造一个专属知识库——AI 可以持续调用其中的信息,在多轮对话中始终保持对品牌的一致理解。
这种设计思路与业界流行的"知识库 + AI"模式一脉相承,参考 NotebookLM 的理念尤为直观。NotebookLM 是谷歌于2023年推出的 AI 笔记工具,核心理念是允许用户上传文档、PDF、研究资料等,让 AI 在这些特定资料的范围内回答问题,而非依赖通用训练知识——即"有边界的 AI"。
NotebookLM 与企业知识库的技术演进: NotebookLM 的成功验证了"围栏式 AI"(Bounded AI)的产品价值——相比让 AI 在无边界的互联网知识中漫游,将其限定在特定文档范围内反而能大幅提升答案的精准度和可靠性,因为错误答案的来源空间被大幅压缩。从企业知识库的发展历程来看,这一赛道经历了从静态文档库(SharePoint 时代)→ 全文检索系统(Elasticsearch 时代)→ 向量语义检索(当前 RAG 时代)的三次范式迁移,每次迁移都大幅降低了"信息找不到"和"找到了但不是想要的"这两类失败模式的概率。业务笔记本功能将这一逻辑延伸到企业场景:商家资料中的结构化数据(类目标签、服务列表、地理属性)比非结构化的 PDF 文档更易于 AI 精确解析,而自动同步机制也解决了传统企业知识库最头痛的"数据腐烂"(Data Rot)问题——员工手动维护的知识库往往在三到六个月后就开始失效,文档过时比例超过40%,而与 Business Profile 实时同步的笔记本则能确保 AI 始终基于最新的营业信息作答,从根本上消除了这一维护成本。
业务笔记本功能继承了这一设计哲学,区别在于数据源从用户手动上传,进化为自动同步的结构化商家经营数据。企业无需每次都重新向 AI 说明自己的业务背景,AI 会像真正了解公司的员工一样,带着完整的品牌认知来协助处理工作。
对中小企业意味着什么
大幅降低 AI 使用门槛
对于缺乏专业营销团队或技术人手的小微商家而言,这项功能极大降低了利用 AI 的门槛。Prompt 工程(Prompt Engineering)——即通过精心设计输入指令来引导 AI 产出高质量结果的技能——一度是使用 AI 工具的必备门槛,甚至催生了"Prompt 工程师"这一新兴岗位。
Prompt 工程的兴衰与系统化趋势: Prompt 工程在2022至2023年间迅速成为热门技能,其核心技巧包括:少样本提示(Few-shot Prompting,在问题前提供2-5个示例让模型理解预期输出格式)、思维链提示(Chain-of-Thought,要求模型"逐步思考"以提升复杂推理准确率,研究显示可将数学推理准确率提升近20%)、角色扮演指令(Role Prompting,指定 AI 扮演特定专家身份以激活相关知识域)以及结构化输出约束(指定 JSON、Markdown 等格式以便下游系统处理)。然而随着模型能力提升和应用层的成熟,行业正在经历从"手工 Prompt"向"系统化上下文注入"的转变——与其培训每个用户写出好指令,不如在系统层面预置结构化上下文,让 AI 在获得充分信息的前提下自动生成高质量输出。这一趋势在业界被称为"Prompt 的民主化"或"无 Prompt 化"(Prompt-less AI)。谷歌此次将 Business Profile 自动注入为上下文,正是这一趋势的典型体现:Prompt 优化的工作从用户侧转移到了平台侧,普通店主无需理解"零样本"与"少样本"的区别,也能获得媲美专业 Prompt 工程师调教出的结果质量。
谷歌此次更新通过自动注入商家上下文,实质上是将 Prompt 优化的工作内置于系统层面:店主无需学习复杂的 Prompt 技巧,也不必手动整理企业信息再喂给 AI,只需完成一次授权连接,Gemini 便能自动获取所需的上下文背景,让任何人都能获得高质量的个性化输出。
从"回答问题"到"帮你办事"
谷歌在官方宣传中特别强调,新功能让 Gemini 成为一个"帮你完成更多工作"(helps you get more done)的伙伴。这透露出谷歌希望 Gemini 从单纯的问答工具,向能够执行实际业务任务的 AI Agent(智能体) 方向演进。
AI Agent 是当前 AI 领域最受关注的发展方向之一。与传统问答式 AI 不同,Agent 能够自主规划任务步骤、调用外部工具(如搜索、日历、邮件),并持续执行直到完成目标,而无需人类逐步指令。
AI Agent 的技术架构与成熟度现状: 一个完整的 AI Agent 系统通常由四个核心模块构成:规划模块(将复杂目标拆解为可执行子任务序列,常见实现方式包括 ReAct 框架和 Tree-of-Thoughts)、记忆模块(短期的对话上下文窗口 + 长期的向量数据库存储,解决模型原生上下文长度限制问题)、工具调用模块(通过标准化 API 连接搜索引擎、日历、数据库等外部系统,谷歌的实现对应 Function Calling 和 Extensions 机制)和执行反馈循环(根据工具返回结果评估进展并调整后续行动,即 Observe-Act 循环)。目前业界普遍面临的挑战在于:Agent 在多步骤任务中的错误累积效应——每一步有95%的准确率,十步串联后成功率就跌至约60%(0.95的10次方≈0.60),这在需要十几步操作的复杂任务中会使成功率降至无法商用的水平。这也是为何谷歌选择从"有边界的、数据明确的"Business Profile 场景切入 Agent 化,而非直接开放复杂的多步骤自主任务:结构化商家数据降低了信息检索环节的出错概率,为 Agent 的可靠性奠定了更稳固的基础。OpenAI 的 Operator、Anthropic 的 Computer Use 以及谷歌自身的 Project Mariner 都是这一方向的代表性探索,但均仍处于能力边界快速扩张、可靠性持续优化的阶段。
可靠性工程的破局思路: 针对错误累积这一根本性挑战,业界正在发展多种缓解策略。其一是引入验证节点(Verification Checkpoint):在高风险操作(如正式发布内容、修改商家核心信息)前强制触发人工确认,将 Agent 从"全自动"降格为"人机协作"模式,以牺牲部分效率换取可靠性;其二是并行路径探索(Parallel Path Exploration):同时运行多条任务执行链,通过多数投票或置信度评分选出最优结果,类似于软件工程中的冗余容错设计;其三是工具调用沙盒(Tool Sandbox):在正式执行前先在模拟环境中"预演"操作,验证结果符合预期后才真正执行——谷歌在 Business Profile 场景的 Agent 化中,极可能采用类似的"草稿预览"机制,让商家在 AI 代为修改商家资料或回复评价前先确认内容,这一设计既降低了 Agent 出错的实际影响,也有助于建立用户对 AI 自主操作的信任。
将 Business Profile 接入 Gemini,可视为谷歌为 Agent 化铺垫基础——当 AI 具备了稳定的业务上下文,才有能力自主执行"更新商家信息""回复评价"等实际任务,而不仅仅是给出建议。
可以预见的应用场景包括:
- 根据商家资料自动起草社交媒体帖子或商家动态
- 分析客户评价趋势并提出针对性改进建议
- 优化商家资料内容以提升本地搜索可见性
- 快速生成常见客户咨询的回复模板
深层观察:谷歌的生态整合野心
这次更新规模虽小,却清晰映射出谷歌的战略意图。谷歌坐拥 Search、Maps、Business Profile、Workspace 等庞大的企业与商家数据生态,而 Gemini 正是将这些分散能力串联起来的"智能中枢"。
谷歌的数据优势不仅在于体量,更在于数据的多模态性与闭环性:Search 提供用户意图数据,Maps 提供地理与出行数据,Business Profile 提供商家经营数据,Workspace 提供企业协作数据,YouTube 提供内容消费数据。这些数据源相互印证、形成闭环,构成任何纯模型厂商都难以在短期内复制的**"数据飞轮"**资产。
数据飞轮的竞争壁垒机制: 数据飞轮(Data Flywheel)这一概念最早由亚马逊实践并被吴恩达等 AI 学者系统化阐述:产品吸引用户产生数据,数据训练出更好的模型,更好的模型提升产品体验,更好的体验吸引更多用户,形成自我强化的正反馈循环。谷歌的飞轮之所以特别强大,在于其数据涵盖了用户旅程的完整链条——从"想要某物"(Search意图数据)到"前往某地"(Maps导航数据)再到"消费某服务"(Business Profile互动数据),这种跨场景的行为数据串联,让谷歌能够以单一竞争对手难以企及的粒度理解用户与商家的真实关系。值得注意的是,飞轮效应在 AI 时代出现了新的加速机制:用户与 Gemini 的每一次交互本身也在生成高质量的"意图-反馈"配对数据,这些数据可通过强化学习人类反馈(RLHF)机制持续优化模型,使得数据飞轮转动的速度随用户规模呈超线性增长。当这一数据优势被注入 Gemini,AI 给出的商业建议不再只是基于行业通用规律,而是建立在数以亿计真实交易行为之上的统计洞察——这是 OpenAI 或 Anthropic 在没有类似数据资产的情况下,单靠提升模型参数量无法复制的差异化能力。
数据飞轮的量化视角与反垄断隐忧: 数据飞轮的竞争壁垒可以通过"数据网络效应系数"来量化评估:即每增加1%的用户规模,模型性能提升的百分比。学术研究显示,这一系数在数据稀疏的专业领域(如医疗影像诊断)远高于数据充裕的通用领域,而谷歌的本地商业场景恰好处于两者之间——全球两亿商家资料构成的数据集体量庞大,但细粒度的区域行业洞察(如特定城市特定类目的用户偏好)仍具有高度稀缺性,使得飞轮系数维持在较高水平。然而,这种数据集中优势也引发了监管层面的关注:欧盟《数字市场法》(Digital Markets Act,DMA)已将谷歌列为"守门人"(Gatekeeper),明确限制其将在一个市场(如搜索)积累的用户数据,在未经用户明确同意的情况下用于强化另一个市场(如 AI 助手)的竞争优势。这意味着谷歌在推进 Business Profile 与 Gemini 数据整合时,在欧盟市场可能面临比美国更严格的合规约束,数据飞轮的转速在不同监管环境下将出现显著分化。
数据越丰富,AI 越实用,用户越依赖,产生数据越多。通过让 Gemini 读取商家资料,谷歌实际上是在为其 AI 助手注入对手难以复制的数据护城河。相比 OpenAI 等纯模型厂商,谷歌的差异化优势正体现在这些与真实业务深度绑定的第一方数据上。当企业主习惯了在 Gemini 中处理商家事务,这种使用黏性将进一步巩固谷歌在企业服务市场的地位。
值得关注的隐忧
当然,将企业核心经营数据交给 AI 处理,也伴随着不容忽视的隐私与数据安全问题。根据 IBM 2023年数据泄露报告,数据泄露的平均成本已达445万美元。对于将 Business Profile 连接 Gemini 的商家而言,需要关注的核心问题包括:数据是否用于模型训练、数据存储地理位置与适用法规(如欧盟 GDPR)、第三方访问权限范围,以及数据删除机制。
企业 AI 数据合规的关键考量: 当前主要 AI 服务商在数据使用上存在显著分层:消费级免费产品通常保留使用对话数据改进模型的权利(用户可在设置中手动关闭),而企业级付费产品(如 Google Workspace Business、Microsoft 365 Copilot)则普遍承诺数据隔离、不用于训练,并签署正式的数据处理协议(DPA,Data Processing Agreement)。对于接入 Business Profile 的中小商家,需特别关注自身账号属于哪一服务层级,以及是否享受企业级数据保护承诺。此外,GDPR 于2018年在欧盟全面生效,赋予用户对个人数据的"被遗忘权"(Right to Erasure)和"数据可携权"(Right to Portability),并要求数据控制者在发生泄露后72小时内向监管机构报告;加州 CCPA 则赋予消费者类似保护权利,并对违规企业处以每条记录最高7,500美元的罚款。对于在这些司法管辖区经营的商家,向 AI 平台授权数据访问时需确认平台是否签署了 DPA,以及商家终止服务后数据删除的响应时限(GDPR 要求通常不超过30天)。商家可以通过谷歌账号的"数据与隐私"设置核查 Gemini 的数据使用选项,在享受功能便利的同时做出知情决策。
竞业风险与最小权限原则: 除隐私合规外,商家还需警惕一类较少被讨论的风险:竞业数据泄露。当多个同类商家的 Business Profile 数据同时被 AI 平台持有,平台在技术上具备了跨商家进行横向比较分析的能力——例如识别出特定区域某类商家的定价规律、服务短板或客流峰值模式。尽管主流平台均承诺不将单个商家数据用于训练或分析其竞争对手,但数据隔离的技术实现方式和审计透明度仍有待加强。对此,安全业界建议商家在授权数据访问时遵循最小权限原则(Principle of Least Privilege):仅开放 AI 功能实际需要的数据字段,定期审查已授权的第三方应用列表,并为 AI 访问设置独立的服务账号而非直接使用主账号权限。谷歌的 OAuth 2.0 授权机制支持细粒度的权限范围(Scope)控制,商家可借此精确限定 Gemini 可读取的数据类型,在功能便利性与数据安全性之间找到适合自身风险偏好的平衡点。
谷歌在企业级产品中通常承诺不将用户数据用于广告训练,但中小商家在授权前仍应仔细阅读服务条款,评估潜在的竞业风险。谷歌需要在功能便利性与数据透明度之间找到平衡,才能真正赢得商家的长期信任。
结语
谷歌将 Google Business Profile 接入 Gemini 的这一步,标志着通用 AI 助手向垂直业务场景深度渗透的趋势正在提速。对广大中小企业而言,这是一个以极低成本获得"AI 业务伙伴"的切实机会;对整个行业而言,这预示着未来的竞争焦点将从模型能力本身,转向 AI 与真实业务数据和工作流的整合深度。
谁能让 AI 更懂用户的具体场景,谁就能在下一阶段的竞争中占据主动。而谷歌,显然正在充分发挥自己在数据生态上的独特优势。
核心要点
相关推荐

Codex入门指南:OpenAI编程智能体与ChatGPT有何不同
Codex是OpenAI推出的AI编程智能体,能自主阅读、修改代码并执行测试。本文解析Codex与ChatGPT的核心区别,以及开发者为什么要学习这类AI编程工具。

Gemini Agent发布:Argon模型太强不敢放出,AI圈新动态盘点
Google发布办公通用智能体Gemini Agent,支持Gemini 4 Argon与Claude Opus 5.5,但Argon因太强暂不开放。本文盘点Odyssey 3世界模型、OpenAI营收、Arena融资等一周AI圈动态。

Sophos借OpenAI Daybreak把威胁响应时间压缩96%
Sophos首席技术官披露,借助OpenAI Daybreak项目和自研安全智能体,其MDR业务平均威胁响应时间从38分钟压缩至89秒,降幅达96%。本文解析其规划-执行-观察闭环架构及AI护栏松绑的意义。