Gemini实时语音智能体实战:构建能听、能看、能说的多模态Agent

Google DeepMind现场演示Gemini API构建实时语音智能体的架构与落地能力。
文章基于Google DeepMind开发者体验团队Thor在AI Engineer大会上的现场演示,系统拆解了用Gemini API构建实时语音Agent的技术栈。Gemini TTS构成流式低延迟的输出层,Gemini 3.1 Flash Live作为原生音频模型跳过文本中转,支持约90种语言并实现低延迟与流畅切换。核心接口Live API采用有状态WebSocket,支持音视频帧输入、音频分块回传、barge-in打断与工具调用。两个demo分别展示函数调用触发Lyria 3实时作曲,以及Interactions API借助交互ID保持连续生成的一致性。文章还介绍了Live Translate近实时翻译与搜索grounding视觉理解,并给出开发者上手路径与生态伙伴。
在AI Engineer大会上,Google DeepMind开发者体验团队的Thor带来了一场关于Gemini API构建实时语音智能体的现场演示。这场分享没有停留在概念层面,而是用多个可交互的demo展示了当前Gemini模型家族在多模态实时交互上的实际能力。对于正在构建语音Agent的开发者来说,其中的架构思路和API设计值得仔细拆解。
从TTS到实时对话:Gemini音频模型的分层能力
Thor开场播放了一段极具表现力的语音片段,并让观众猜测模型来源。答案是Gemini TTS——一个支持流式输出、低延迟、可通过内联音频文本进行风格控制的语音合成模型。这构成了实时语音Agent的"输出层"基础。
真正承担对话智能的是Gemini 3.1 Flash Live,一个原生音频模型。它与传统级联式语音Agent管线(ASR转文本→LLM推理→TTS合成)有本质区别:模型本身不经过文本中转,智能直接"烘焙"在音频模型中,因此能原生理解语音并直接以音频回应,支持预览阶段约90种语言。
这一架构选择带来的直接收益是延迟降低和语言切换的流畅性。演示中Thor在同一段对话里无缝切换英语、德语和中文,模型均能自然应对。对于需要多语言支持的实时应用,这种原生多语言能力比拼接多个单语模型要简洁得多。
级联式语音管线与原生音频模型的核心差异
传统级联式语音Agent(ASR→LLM→TTS)的每一段都需要一次模型调用,并伴随一次音频与文本之间的模态转换。这种转写环节会丢失语气、停顿、情绪等副语言信息,同时串行调用叠加导致端到端延迟通常在1秒以上。原生音频模型(如Gemini 3.1 Flash Live)直接在音频token空间上进行理解与生成,省去中间转写,能保留说话人情绪与语速特征,并使延迟显著下降。代价是输出更难以逐字审计,可观测性弱于文本中间产物,因此在需要严格合规或强可控的场景中,级联方案仍有一席之地。
Live API:有状态WebSocket驱动的多模态会话
构建实时对话Agent的核心接口是Live API。它是一个低延迟的实时语音与视觉API,采用有状态WebSocket设计:开发者创建会话后,可通过WebSocket持续发送文本、音频和视频帧,模型以音频分块实时回传,同时附带转录文本。
关键特性包括:90种语言支持、可打断(barge-in,用户能随时打断模型输出)、工具调用能力、以及音频转录。其中barge-in看似细节,却是语音交互自然度的分水岭——没有它,Agent就更像一个无法插话的播报器。
Thor特别提到,实时媒体在规模化方面挑战不小,因此生态中有LiveKit、Pipecat等合作伙伴提供快速上手的方案,这些团队也出现在大会展区。
有状态WebSocket与无状态HTTP调用的区别
无状态HTTP请求要求每次调用都携带完整上下文,适合一次性推理;而实时语音对话需要模型持续记住前几轮的音频、视频帧与工具调用结果。Live API采用有状态WebSocket后,会话在连接期间由服务端维护上下文,开发者只需增量发送新的音频或视频帧,模型便以音频分块流式回传。这种设计天然支持双向流,也是实现barge-in的前提——服务端能在模型输出过程中接收新的用户音频并即时中断生成,无需重建连接或重放历史。
现场Demo拆解:收音机DJ与故事画布
第一个demo是一个"点歌电台":Gemini Live扮演DJ,通过函数调用触发Lyria 3音乐生成模型,按用户指定的风格现场作曲。观众要求一首关于AI Engineer大会的高能量雷鬼顿,模型不仅生成了完整歌词和旋律,还自然混入了西班牙语。
这个demo的业务价值不在"点歌"本身,而在于展示了实时语音Agent的完整能力组合:多语言对话、工具调用、按需触发下游生成模型。同样的模式可以替换为查询CRM获取客户信息,或在后台创建工单。
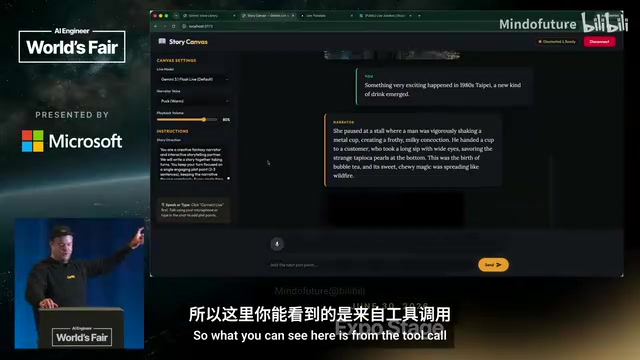
第二个demo是"故事画布":Gemini Live生成故事文本,再通过Interactions API调用Nano Banana Lite生成配图。Interactions API是Google DeepMind统一的模型与Agent交互接口,其有状态特性允许传递前一次交互的ID,从而在连续生成中保持角色和视觉风格的一致性。演示中以1980年代台北夜市为背景生成珍珠奶茶起源的故事,图像生成耗时约两到三秒。
函数调用与搜索grounding的关系
函数调用(function calling)是模型在对话中主动发起结构化请求、由外部系统执行并回传结果的机制,Lyria和Interactions API的触发都依赖它。Google Search grounding本质上是一种由平台内置的函数调用:模型判断需要实时信息时自动检索并引用搜索结果,开发者无需自行实现检索管线。二者共同构成实时Agent的“行动层”,决定Agent能否从纯对话走向真正执行任务。
即时翻译与视觉理解:容易被忽视的两块拼图
Gemini 3.5 Live Translate展示了近乎实时的语音翻译:演讲者说话的同时,模型自动检测语言并翻译成听众选择的语言,现场观众用手机扫码即可用德语或中文收听。对于国际化会议、跨境协作场景,这一能力可以直接嵌入应用。
视觉理解方面,Thor在AI Studio中演示了开启Google Search grounding后的Gemini 3.1 Flash Live:模型能通过摄像头看到他的黑色帽子和印有黄色"Gemini"字样的卫衣,并解释德语中"Zwillinge"意为"双子"。搜索 grounding 相当于内置的函数调用,让模型可以获取天气等实时信息。
开发者如何上手
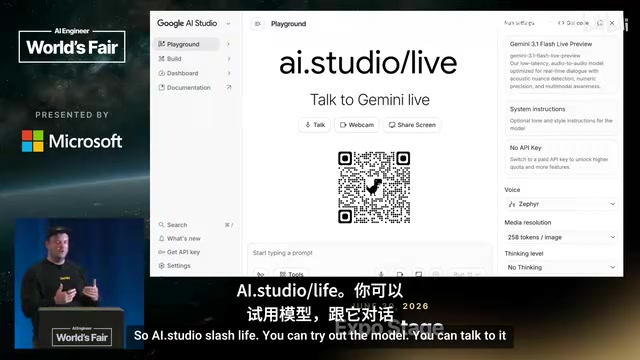
最直接的入口是ai.studio/live(或ai.dev/live),可以在浏览器中直接与模型对话、切换语音(如Puck)、开启搜索grounding。Thor提到该demo本身就是在Google AI Studio中用Gemini vibe-code出来的,开发者可以fork后继续改造。
从工程视角看,这套技术栈的分工已经比较清晰:Live API负责实时多模态会话,Interactions API负责有状态的生成链,Gemini TTS和Live Translate补齐语音输入输出的专项能力。对于构建实时语音Agent的团队,值得关注的是原生音频模型与级联管线的取舍——前者延迟和自然度占优,后者在可控性和可观测性上更成熟。Thor的演示表明,原生路线已经进入可实际落地的阶段。
相关推荐

2026年AI编程工具横评:Claude、ChatGPT、Gemini谁最强?
2026年五款主流AI编程工具横评:Claude Code、ChatGPT Codex、Gemini、DeepSeek和GitHub Copilot在真实项目、定价与代码质量上的全面对比,帮你决定每月20美元该花给谁。

ChatGPT Codex克隆任意软件?实测风险与真相
YouTube短视频宣称用ChatGPT Codex或Claude Code即可克隆Adobe、Excel、Figma等软件并终身免费使用。本文拆解其技术可行性、法律风险与私信引流套路,说明AI编程工具真正适合的用法。

Kilo Code免费安装但API收费:成本估算与配置指南
Kilo Code 开源 AI 编程代理安装免费,但接入的 AI 模型按 token 收费。本文详解 VS Code 扩展与 CLI 配置步骤,并用假设用量演示 API 成本估算方法,对比按量付费与订阅制的选择逻辑。