Gemini推出决策API:支持音频模态的极速专用决策模型
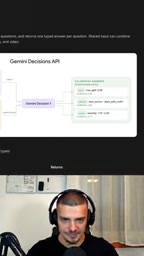
Google推出Decisions API,将专注预定义输出空间、原生支持音频的Gemini决策模型产品化。
Google为决策模型推出独立的Decisions API,把「系统一模型」这类极速推理能力正式产品化。决策模型不生成自由文本,而是在预定义的输出空间内做选择,覆盖分类、二值判断与情感打分三类任务,因无需逐 token 生成而推理极快,适合内容审核、意图识别、情感打分等毫秒级场景。Gemini决策模型的最大差异点是原生支持音频模态,OpenAI模型、Jeff及本地Ollama模型均不具备,可压缩语音类应用的链路。在Artificial Analysis决策指数上,它与Jeff基本持平,优于GPT-6 Luna决策模型与Cloudflare Clef系列,但结论基于单一基准,选型仍需按实际任务分布验证。
Google为其决策模型推出了独立的Decisions API,正式将这类"极速推理"能力产品化。对于需要毫秒级判断的场景——内容审核、意图识别、情感打分——这意味着不用再拿通用大模型硬扛,而是有一个专用模型可以直接调用。
什么是决策模型:预定义输出空间的极速推理
决策模型有时被称为「系统一模型」(system one models),也有「语义过滤模型」(semantic filter models)的叫法,具体取决于你看的是哪套术语体系。它的核心特征不是生成文本,而是在预定义的输出空间里做选择(截图中的表述是"you have a predefined output space")。
这类模型覆盖的任务类型相当具体:
- 分类(classification):这条请求属于什么类型?这条消息是什么性质?正在讨论哪个话题?
- 二值判断(null for Bernoulli):这句话是正面还是负面?内容是否危险?
- 打分(score):把情感从负面经中性到正面评级。
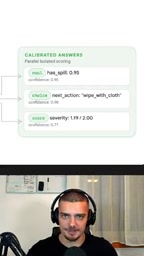
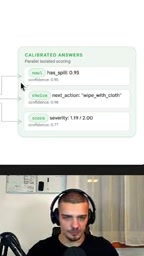
因为输出空间被提前锁死,模型不需要逐 token 生成自由文本,推理速度极快。对于业务系统里那些高频、低复杂度但要求实时性的判断环节,这比调用通用大模型要划算得多。
系统一/系统二的说法借自丹尼尔·卡尼曼的双系统理论:系统一是快速、直觉、低耗的自动判断,系统二是缓慢、审慎、需要推理的深度思考。映射到大模型架构里,系统一模型负责高吞吐的过滤与路由,系统二模型负责需要多步推理的复杂请求,二者串联构成级联(cascade)推理。
语义过滤模型一词强调的是同一件事的另一面:它的作用是在海量输入中快速筛掉明显无关或明显违规的内容,只把边界样本交给下游重模型。这类模型的训练目标通常是固定标签空间上的判别损失,而非下一个 token 的预测损失,因此参数量往往远小于通用大模型。
Gemini决策模型的差异化:原生支持音频
在同类产品中,Gemini决策模型最突出的差异点是能够处理音频模态。注意这是原生能力,不是外挂一个语音转文字再跑分类。
素材中的对比相当直接:OpenAI的决策模型做不到音频,Jeff(指代相关模型的转写表述)做不到,可以在本地轻松运行的Ollama开源模型同样做不到。
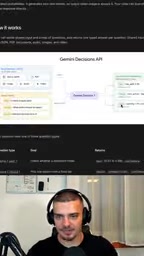
这带来的实际差别不小。语音客服质检、音频内容审核、通话情绪监测这类场景,传统做法是ASR(语音识别)转文本再分类,中间环节有信息损耗也有延迟。如果决策模型自己就能吃音频,整条链路可以压缩。Stack Overflow上少了两层胶水代码,线上少了一处故障点。
原生多模态指模型在预训练阶段就同时接触文本、音频、图像等信号,共享同一套表示空间;与之相对的是外挂式方案,即先用 ASR 把语音转成文本再送入纯文本模型。二者的关键差别在于副语言信息:语速、停顿、音量、音高、笑声与叹息等线索在转写过程中几乎完全丢失,而这些恰恰是情绪判断与风险识别的重要依据。原生音频输入还能避免 ASR 错误在链路中逐级放大,并省去一次串行推理,对端到端延迟影响显著。
基准表现:Artificial Analysis决策指数上的位置
在Artificial Analysis的决策指数(decision index)上,Gemini决策模型的得分与Jeff基本持平,同时优于GPT-6 Luna决策模型,也优于Cloudflare的Clef和Clef Omni。用素材的说法,它"似乎是较好的决策模型之一"。
需要说明的是,这个结论建立在单一基准之上。决策任务的类型很多(分类、二值、打分),不同模型在不同任务族上的强弱可能并不一致,而指数是聚合后的结果。工程选型时值得按自己的实际任务分布做一轮小样本验证,毕竟这种模型迭代快,排行榜上的相对位置会变。
Artificial Analysis 是一家独立的大模型评测机构,以统一口径的自动化基准和延迟、吞吐、价格等工程指标著称,其指数通常把多项子任务得分聚合成单一分数以便横向比较。需要注意,聚合指数隐含了各任务族的权重假设,权重与实际业务分布不一致时,排名可能失真。此外,这类榜单更新频繁,模型版本迭代会改变相对位置,因此指数更适合作为初筛候选模型的参考,而非最终选型依据。
对工程实践的影响
从架构角度看,Decisions API的推出把"快模型"和"慢模型"的分工显性化了。系统一负责过滤、路由、初筛,系统二(通用大模型)只处理经过筛选的少量请求。这种分层在成本上更友好,在延迟上也更可控。
音频原生支持则打开了一批此前需要绕路的场景。当决策模型能直接消费音频信号时,语音类应用的实时判断门槛明显下降。
目前的信息主要来自单个视频来源,API的具体定价、速率限制、支持的音频格式与时长约束等细节尚不清楚,落地前需要查阅官方文档确认。
**级联推理(cascade / router 架构)**的常见做法是:先用轻量模型对全部请求打分或分类,仅将置信度低于阈值的样本升级给大模型处理。其收益取决于两个参数——轻量模型的准确率与它覆盖的流量比例;若阈值设得过松,误判会向下游传导,设得过紧则退化为全量调用大模型、失去成本优势。实践中通常需要基于线上分布校准阈值,并对两级的输出做一致性监控。
相关推荐
AI写代码越来越便宜,真正难的是验证
生成代码越来越便宜,软件团队的瓶颈转向验证。结合萨提亚·纳德拉访谈,解析编程智能体的规格说明、多模型审查、权限分离与组织调整,以及工程师如何把一次修复沉淀为团队可复用的能力。
Saparo:自动叠加优惠的购物AI代理,登顶Product Hunt
Saparo 是一款自动叠加优惠的购物 AI 代理,登顶 Product Hunt。它能搜索同款、匹配尺码、组合促销码与返现,按含运费税费的总成本排序,最终支付由用户完成。
Tripmojo:会帮你值机的AI旅行Agent
Tripmojo是Product Hunt上排名第2的AI旅行Agent应用,能同步预订邮件生成共享行程,并由AI助手Mojo在出行当天尝试值机、保存登机牌、提醒延误与登机口变更,行程中维护计划并分摊费用,iOS与Android免费。