Gemma 4 与 Gemini Nano:端侧智能的架构拆解
Gemma 4 以逐层嵌入、共享 KV 草稿模型和移动定制量化,让小模型在手机上越级挑战大模型。
Google 在端侧 AI 上的策略转向架构创新而非硬塞大模型。Gemma 4 提供 E2B、E4B 等手机级模型,E2B 在推理、编码和智能体评测上全面超越 Gemma 3 27B。关键技术包括:逐层嵌入(PLE)让名义参数量远超实际加载的约 2B;MTP 草稿模型共享基础模型 KV 缓存,接受率提升 40-60%、解码延迟降低 40%、能耗减少 30-40%;QAT 结合定向 2-bit 量化大幅压缩体积与活跃内存。集成上,AI Core 提供开箱即用的共享路径,LiteRT 提供可微调的完全掌控路径。
Google 在端侧 AI 上的策略正在变得清晰:不再追求把云端大模型硬塞进手机,而是通过架构创新,让更小的模型在同等硬件条件下具备更强的能力。在近期一场技术分享中,Gemma 建模团队工程负责人 Sarah 系统拆解了 Gemma 4 与 Gemini Nano 的设计思路——从逐层嵌入到量化策略,从多模态能力到 AI Core 的集成路径。
从 Gemma 1 到 Gemma 4:能力升级,体积不失控
Sarah 回顾了 Gemma 系列的演进轨迹:Gemma 1 推出 2B 和 7B 纯文本模型,在当时已属极小尺寸;Gemma 2 引入编码能力并扩展至 27B;Gemma 3 加入多模态,同时下探到 270M 参数级别。每一代能力在涨,但目标始终是适配单设备硬件——手机、笔记本、GPU。
Gemma 4 的产品矩阵体现了这种取舍:E2B、E4B 面向手机,12B 统一模型面向笔记本(移除了视觉编码器以简化部署),更大尺寸则提供全稠密和混合专家(MoE)两种形态。Sarah 强调,E2B 和 E4B「小到足以在手机上良好运行」,这是团队引以为傲的工程挑战。
上下文长度是 Gemma 4 的显著提升项:最高支持 128K,更大模型可达 256K。不过她提醒,ML Kit 会对上下文长度设上限,开发者需要先确认预算再指望跑满 128K。
多模态:视觉、音频与视频的三线并进
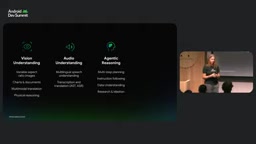
视觉方面,Gemma 4 采用可变宽高比处理——不再把图片压成别扭的正方形,而是保留原始比例。这一改动让文字和物体不再变形,Sarah 称其「大幅提升了模型能力」,OCR 表现改善尤其明显。模型还能读图表、读表格、读图形,并做视觉线索翻译。视觉 token 预算可调,开发者可以在高分辨率理解与节省算力之间自行平衡。
音频是较新的模态,首次出现在 Gemma 3n,在 Gemma 4 中全面加码。它仅存在于最小的几个模型中(E2B、E4B 和 12B),支持开箱即用的 35 种以上语言,预训练覆盖 140 种以上语言——不在列表中的语言可以通过微调获得不错的效果。
视频能力从 Gemma 3n 开始引入,Gemma 4 进一步深化。此外,Gemma 4 新增了智能体推理:规划、多步执行、工具调用、精确指令遵循、结构化 JSON 输出。Sarah 特别提醒,如果不用 ML Toolkit 而自行集成,务必小心处理 chat template。
评测数据:小模型越级挑战
Sarah 展示的评测结果颇具说服力:E2B 在推理、编码和智能体任务上全面超越 Gemma 3 27B——后者是体积大得多的模型。LiveCodeBench 上,Gemma 4 拿到 44 分,Gemma 3 27B 为 29 分;IEME 和 TAU2(智能体评测)同样显著更高。再往上走几个参数,E4B 在每一项基准上都稳定胜过 27B。
这组数字背后的含义是:从 Gemma 3 到 Gemma 4,同等参数量下能力密度大幅提升。而这正是端侧部署最需要的进步方向。
移动硬件的三重约束与对应解法
Sarah 把手机与服务器的硬件差距摆得很直白:内存方面,手机是 12 到 16GB,服务器约 80GB;带宽方面,手机是 50 到 80GB,服务器是 TB 级;功耗约束则更为严苛。她随后展示的每项技术,都针对其中一项约束。
逐层嵌入(PLE):E 的由来
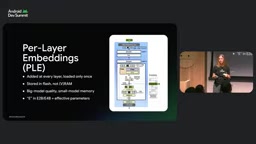
模型要变聪明通常需要更多参数。逐层嵌入的做法是:不把参数直接堆进模型主体,而是增加一张额外的嵌入表,在每一层被读取。对于给定的输入序列,只加载所需的那部分嵌入。效果是——名义参数量远大于 2B,但实际加载进内存的只有约 2B,这就是「有效 2B 参数」的含义。嵌入表通常存放在 RAM 而非 Flash 中,带宽压力和内存占用同时下降,却保留了更大模型的能力。
逐层嵌入(Per-Layer Embeddings, PLE) 是一种参数高效架构,最早由 Google 在 Gemma 3n 中引入。传统 Transformer 的嵌入层只在输入阶段查表一次,而 PLE 在每一层都额外读取一张共享的嵌入表,相当于给每层提供了一个轻量级的"外部记忆"。由于嵌入表是稀疏访问的——对于给定 token 序列,只需加载对应行——它可以在不增加稠密计算量的前提下大幅扩充模型容量。从工程角度看,PLE 把"参数总量"和"活跃参数"解耦:名义参数量可以远超 2B,但实际驻留内存和参与前向计算的只有约 2B。这也是 Gemma 4 中 E2B、E4B 命名里"E"(Effective)的来源。
草稿模型:共享 KV 缓存带来的加速
Gemma 使用的草稿模型是多 token 预测(MTP),属于投机解码的一种。常规自回归模型每次只出一个 token,而 MTP 一次预测三到四个 token,再由主模型验证,被接受的就直接采用。
与市面上其他草稿模型的关键差异在于:Gemma 的草稿模型共享基础模型的 KV 缓存。E2B 完成完整 pre-fill 并建好缓存后,草稿模型直接复用,省去了重新生成 pre-fill 的开销。Sarah 给出的收益是:接受率比多数草稿模型高 40 到 60%,解码延迟降低 40%,能耗减少 30 到 40%,且无需改动代码。
投机解码(Speculative Decoding) 是一种在不改变输出分布的前提下加速自回归生成的技术。其核心思路是:用一个更小、更快的"草稿模型"一次性猜出多个后续 token,再让主模型并行验证这些猜测;被主模型接受的 token 直接采用,被拒绝的则从分歧处重新生成。由于验证可以并行完成,整体解码延迟显著下降。
KV 缓存(Key-Value Cache) 则是 Transformer 推理时保存历史 token 的键值对,避免每生成一个新 token 都重算全部上下文。常规投机解码方案中,草稿模型和主模型各自维护独立的 KV 缓存,草稿模型需要单独做 pre-fill,带来额外开销。Gemma 的 MTP 草稿模型直接复用主模型已建好的 KV 缓存,省去这部分重复计算,这也是其接受率和延迟收益优于通用草稿模型的关键原因。
量化:为移动硬件定制的激进路线
量化并非新技术,但 Gemma 团队针对移动硬件做了额外功课。首先是 QAT(量化感知训练),在训练阶段就考虑量化的存在,帮助模型理解参数会被分桶,从而保住质量——从 16 位压到 4 位仍能维持品质,内存节省相当可观。
E2B 提供两种量化格式。Q4O 是通用型,可定制,兼容其他量化库;mobile quant 则激进得多,团队投入了大量研究使其达到最优。它包含几项针对性设计:静态激活量化省去了运行时动态计算范围的开销;通道级量化契合多数移动硬件的结构;定向 2-bit 量化——通常 2-bit 量化损失严重、PTQ 极难做好,但团队通过 QAT 知道哪些参数可以压到 2-bit 而不失质量。此外还内置了嵌入和 KV 缓存的量化。这套组合让模型体积大幅缩小,同时显著降低活跃内存和带宽占用。
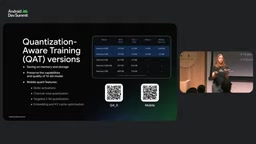
QAT(Quantization-Aware Training,量化感知训练) 与 PTQ(Post-Training Quantization,训练后量化) 是两条互补的量化路线。PTQ 在模型训练完成后直接对权重做低位压缩,成本低但精度损失较难控制,尤其在 2-bit 这种极低位宽下往往不可用。QAT 则在训练阶段就模拟量化的分桶与舍入行为,让模型参数主动适应低位表示,因而能在 16 位压到 4 位甚至部分 2 位时仍保住质量。
静态激活量化 指在推理前预先确定激活值的量化范围(scale/zero-point),运行时无需动态统计,省去计算开销;通道级量化 则为每个输出通道单独设置量化参数,比张量级量化更精细,也更契合移动 NPU 的乘加阵列结构。两者结合,是 mobile quant 能在手机硬件上跑出低延迟的重要原因。
两条集成路径:AI Core 与 LiteRT
开发者面对的第一个选择是走哪条路。
AI Core 路径最省心。Gemini Nano 4 就是通过 AI Core 构建和运行的 Gemma。逐层嵌入由运行时妥善处理,嵌入参数不必驻留 RAM;MTP 已内置;使用的是 mobile quant,运行时可跑到 2-bit 精度。请求流程中,输入端和输出端各有一次安全检查,形成模型之外的第二层防护。模型在应用间共享并自动更新,适合同时构建多个应用、不想自己管理打包模型的场景。
LiteRT 路径则完全掌控。模型随应用打包,不共用设备上的共享模型,因此内存、功耗、资源管理都需要开发者亲自操心。代价换来的是完全控制权:可以用微调模型,定制空间更大。
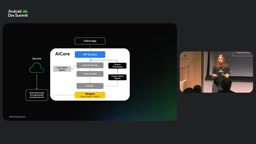
AI Core 是 Android 平台上面向端侧 AI 的系统级推理服务,模型由系统统一管理、在应用间共享并随系统更新,开发者通过 API 调用而无需自行打包模型文件。LiteRT(前身为 TensorFlow Lite)则是 Google 的端侧推理运行时,模型随应用分发,开发者对模型版本、内存布局和硬件委托(delegate)拥有完全控制权。两者的取舍本质上是"系统托管"与"应用自持"的权衡:前者省心但定制空间有限,后者灵活但需自行承担内存与功耗管理。Gemini Nano 4 即通过 AI Core 分发,而需要微调或深度定制的场景则更适合走 LiteRT。
两个现场演示
第一个是语音助手,完全本地运行,采用 VAD 级联:语音转文字 → Gemma → 文字转语音,全流式处理,跑在 E2B 上。演示在笔记本上进行,但 Sarah 强调这与手机上是同一个模型,整套流程完全可以在手机上完成。演示中她刻意打断、切换话题,模型都能顺畅接住,全程没有服务器往返。
第二个是视频能力演示,设定在「野外露营」的离线场景,基于 E4B。模型在后台调用工具、访问手机上的不同功能:识别西班牙语警告牌并解释内容、求解导数、查询日程、分辨照片里是美洲狮还是狗。语气自然,还带点玩笑。
开发者可以立刻上手
Sarah 在结尾给出了入口:checkpoint 发布在 Hugging Face 和 Kaggle,模型代码进入 Transformers 代码库,ML Toolkit 提供了配套链接。想要深入了解 ML Kit 路径可以看 David 的专场,LiteRT 的开发细节则在 Chitin 和 Ferguson 的分享中。
对端侧 AI 的开发者而言,Gemma 4 传递的信号很明确:模型能力密度在提升,量化与推理优化在向移动硬件靠拢,集成路径也在收敛为「省心」和「掌控」两种清晰选项。真正决定体验的,已经是你能在这个预算内构建什么。
相关推荐

Mistral Large 4开源万亿参数,微软6万员工自愿离职
Mistral Large 4 开源万亿参数多模态模型,编码智能体评测得分 48;闪迪财报显示 AI 推理重塑 NAND 需求;谷歌 Gemini 上线应用内文件编辑,OpenAI 上调 Codex 额度,微软向 6 万员工提供自愿离职方案。
Mistral Large 4开放权重,AI早报盘点模型与生态新动向
Mistral Large 4开放权重,1万亿参数MoE架构支持MacStudio本地运行;Meta测试生成技术进入生产环境;税务基准测试头名通过率仅10.8%;加拿大政府入股Cohere;豆包工作开放第三方模型调用。本期AI早报盘点模型、生态、资本与政策动向。
Mistral Large 4开源:1T参数欧洲版千问挑战DeepSeek
Mistral Large 4正式开源,1T总参数、52B激活参数,主打编程与网络安全,NVFP4量化版本权重约610G。本文解析其与DeepSeek V4 Flash的对比、API定价、Demo真实性与本地部署价值。