General Compute获1亿美元A轮,推理芯片挑战英伟达

General Compute获1亿美元A轮融资,押注英伟达之外的推理芯片算力服务。
在neocloud赛道普遍被看衰的背景下,General Compute完成1亿美元A轮融资,选择了一条与囤卡出租相反的道路:围绕推理场景构建算力服务,并刻意避开英伟达芯片。其核心判断是,随着大模型从训练走向规模化应用,推理成本将取代训练成本成为AI公司的主要支出,而推理对单位成本与能效比的敏感度高于生态锁定,这为非英伟达芯片留出空间。文章分析了该模式的机遇与挑战:软件栈工程能力决定成本优势能否兑现,多芯片供应链带来灵活性也增加复杂度,而竞争对手不仅包括英伟达,还有传统云厂商与资金充裕的neocloud同行。这笔融资的信号意义在于,资本对AI算力的判断正在分化。
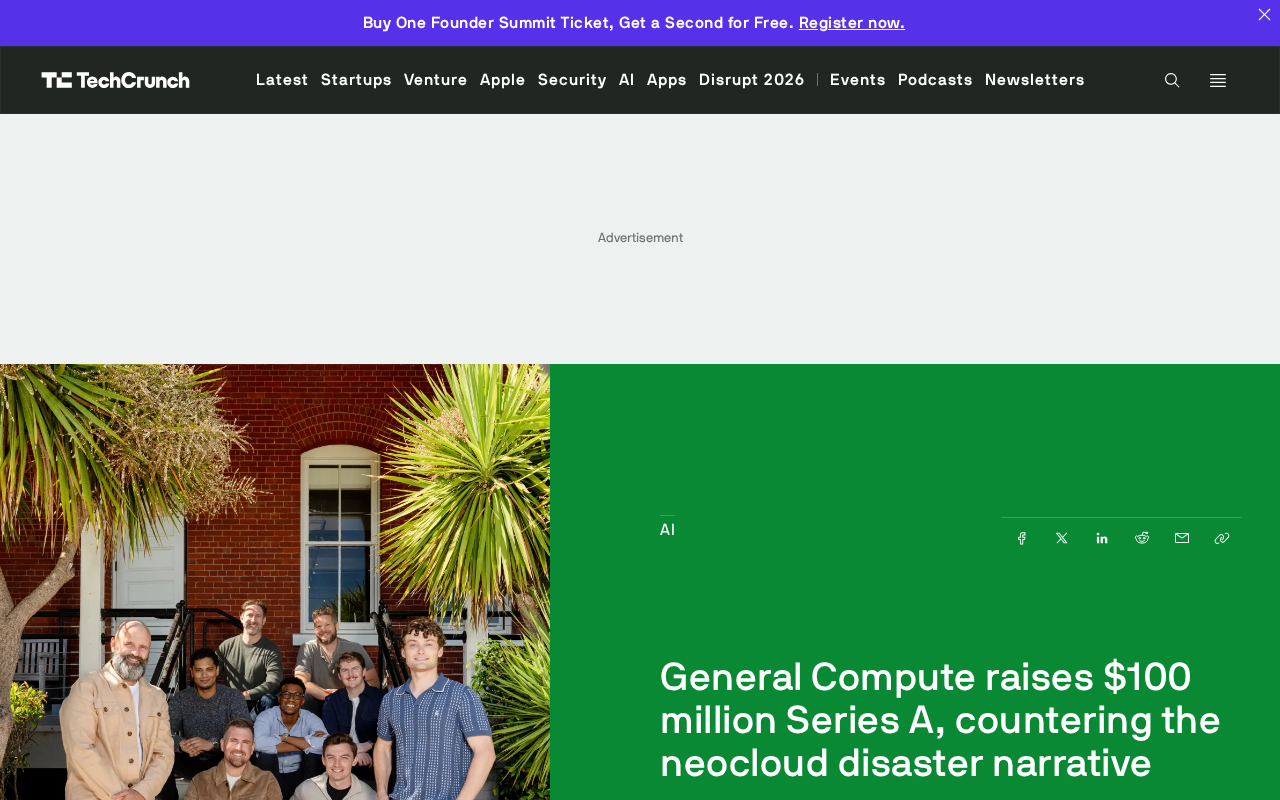
当AI基础设施领域的融资新闻频繁与"泡沫破裂"、"估值倒挂"联系在一起时,一家名为General Compute的初创公司却拿到了1亿美元的A轮融资。这笔资金要押注的方向相当明确:用英伟达生态之外的推理芯片,撬动AI算力市场里正在膨胀的那块蛋糕。
一场与"neocloud灾难叙事"相反的押注
过去一段时间,围绕neocloud(新型云服务商)的讨论弥漫着悲观情绪。大量玩家涌入GPU云租赁赛道,硬件采购成本高企、折旧压力巨大、价格战此起彼伏,让不少观察者开始质疑这类商业模式的可持续性。
General Compute的融资在这种背景下显得格外突出。它没有加入囤卡出租的军备竞赛,而是选择了一条更聚焦的路径——围绕推理场景构建算力服务,并且在芯片选型上刻意避开Nvidia。
这种反向操作的逻辑在于:推理需求的结构与训练不同。训练追求极致性能和互联带宽,生态锁定强;推理则更看重单位成本、能效比和部署灵活性。当模型调用量持续攀升,推理成本会取代训练成本成为AI公司账单上的大头,这给非Nvidia芯片留出了空间。
neocloud(新型云服务商) 是相对传统超大规模云厂商(AWS、Azure、GCP)而言的一类新兴算力租赁公司,典型代表包括CoreWeave、Lambda Labs等。它们的商业模式以GPU集群租赁为核心,主要服务于AI训练与推理客户。其结构性风险在于:需要一次性投入巨额资本采购GPU(单张H100售价可达数万美元),而硬件折旧周期通常只有3-5年,若租赁价格因供给过剩而下跌,投资回收周期就会被拉长甚至倒挂。此外,这类公司往往高度依赖单一供应商(英伟达),议价能力弱,且客户黏性有限。这正是市场对neocloud赛道产生"灾难叙事"的根源,也是理解General Compute选择差异化路线的重要背景。
为什么是推理芯片,为什么是现在
General Compute的核心判断可以拆成两层。
第一层是需求迁移。大模型从实验室走向产品,训练是一次性的资本开支,推理却是持续发生的运营开支。对应用层公司而言,谁能把每次调用的成本压下来,谁就能在定价上获得主动权。这制造了对"够用且便宜"的推理算力的真实需求,而不是对顶级训练集群的盲目追逐。
第二层是供给多元化。Nvidia在训练市场的统治地位短期内难以撼动,但推理市场的竞争格局远未定型。一批专用推理芯片在特定工作负载上展现出成本优势,硬件层面的可替代性正在增强。General Compute的商业模式,本质上是把这些分散的芯片供给整合成可用的算力服务。
完整的推理算力方案不只取决于芯片本身。调度系统、模型编译优化、批处理策略、内存管理,这些软件层的工程能力决定了同一块芯片能跑出多少有效吞吐。这正是General Compute这类玩家需要证明的价值——不是简单转售硬件,而是让非主流芯片在真实业务负载下跑出性价比。
推理与训练的计算特征差异是理解芯片选型逻辑的关键。训练阶段需要反复进行前向与反向传播,对浮点算力(FP16/BF16甚至FP8)、显存带宽和卡间互联(如NVLink)要求极高,且往往需要数千张卡协同,因此生态锁定强、迁移成本高。推理阶段则是模型部署后的前向计算,通常对延迟、吞吐和单位token成本更敏感,对互联带宽的要求相对较低。许多专用推理芯片(如Groq的LPU、Cerebras的晶圆级芯片、以及各类ASIC)通过牺牲通用性换取更高的能效比和更低的单次调用成本。当模型调用量从百万级增长到数十亿级时,推理成本在AI公司总支出中的占比会显著上升,这为"够用且便宜"的非英伟达芯片创造了真实的市场窗口。
1亿美元能买来什么
A轮融资的规模说明资本市场愿意给这条路径一次验证机会。资金通常流向几个关键环节:芯片采购与集群部署、软件栈研发、以及客户获取。
对推理服务商而言,早期的核心挑战不在需求端,而在工程端。如何在不同架构的芯片之间做统一抽象,如何让客户的模型迁移成本足够低,如何在保证稳定性的前提下把资源利用率拉高——这些问题解决不好,成本优势就会被运维开销吃掉。
另一个隐性的考验是供应链。选择非Nvidia芯片意味着要与多个芯片供应商建立关系,产能、交付周期、驱动成熟度都存在不确定性。相比单一供应商的云服务商,这种多源策略在灵活性上有优势,在复杂度上则是负担。
多芯片软件栈的工程挑战值得进一步展开。不同厂商的推理芯片在指令集、内存层次、并行方式和编程模型上差异巨大,例如GPU依赖CUDA生态,而ASIC往往需要专用编译器和运行时。要让客户的模型在多种芯片上高效运行,服务商需要构建统一的计算抽象层(类似MLIR、TVM等编译器基础设施),并实现算子融合、动态批处理(continuous batching)、KV Cache管理等优化。这些软件工作直接决定了硬件的有效利用率——同一块芯片,软件优化好坏可能带来数倍的吞吐差异。这也解释了为何这类公司的核心竞争力不在硬件采购,而在工程团队对异构计算的驾驭能力。
这条路径的对手不只是Nvidia
如果把General Compute放在更大的竞争图景里看,它面对的并不只是Nvidia的生态壁垒。
传统云厂商正在把推理服务做成标准化产品,凭借规模效应和现有客户关系挤压独立玩家的空间。neocloud赛道的同行们虽然承受着盈利压力,但其中资金充裕的玩家同样在向推理场景延伸。
General Compute的差异化空间可能在于专注度。大厂的推理服务往往是其庞杂产品线中的一环,定价和资源分配要服从整体战略;专注推理的玩家则可以在特定场景上做更激进的成本优化和更细的服务颗粒度。这种专注能否转化为可持续的客户粘性,是这笔融资要回答的问题。
对行业的信号意义
这笔融资最值得关注的地方,或许不是金额本身,而是它出现的时间点。在neocloud叙事普遍悲观的氛围里,仍有资本愿意为一个明确的技术路线下注,说明市场对AI算力的判断正在分化——笼统的"算力租赁"故事吸引力下降,但针对特定环节、特定成本结构的解决方案仍有空间。
推理芯片能否真正撑起一门独立的算力生意,取决于软件层能否把硬件差异抹平到客户无感的程度。General Compute拿到的是入场券,不是答案。
相关推荐

Hermes Agent零基础实战:自进化AI助手
Hermes Agent 零基础教程:GitHub 41.7K 星的自进化 AI Agent 怎么装怎么用。本文拆解其学习循环、三层记忆与 Skill 自改进机制,对比 Claude Code 和 OpenClaw 的差异,并附 WSL 安装实操步骤。

RAG面试核心:离线建库与在线检索全流程拆解
拆解RAG检索增强生成的完整工作流程:离线阶段文档加载、切割、向量化、入库,在线阶段问题改写、向量检索、重排、生成,并解析RAG面试核心考点与系统优化方向。

AI大模型零基础入门:原理与API调用实战指南
从AI发展脉络到大模型训练原理,再到Token、Temperature、Top-P等核心概念,本文结合实战课程讲解系统提示词、Function Call、RAG与记忆能力的实现逻辑,并给出四类API调用场景的落地路径,适合零基础开发者入门。