更省Token的记忆插件Sick Memory:日花费仅0.9元

Sick Memory用统一中枢和按需检索,让AI有选择、有证据地记住你,压低重复带入旧内容的token成本。
文章介绍B站UP主「大肥鱼呀」推荐的Sick Memory,针对AI角色每开新对话就遗忘用户、重复带入旧内容推高token成本的痛点。它摒弃“全塞上下文”和“日记摘要”两种旧方案,改用统一中枢区分身份、绘画与说话边界,事实不覆盖但理解可有版本。记忆按话题相关性、重复频率和情绪强度排序,先找候选再按原话编号回查证据,只带入回答所需部分。Dream机制在预算内离线整理合并记忆,日常查询不额外调用模型。人格由承认不知道、改正错误等可核对行为积累。文中强调0.9元/天需结合不同条件的使用记录理解,并非同口径对比。
AI角色养久了,最让人头疼的不是模型不够聪明,而是每次新对话都要重新认识你一遍。钱花了不少,它转头就忘了你是谁。B站UP主「大肥鱼呀」介绍的Sick Memory,就是冲着这个痛点来的——它想让AI真正记住你,同时把重复带入旧内容的token成本压下来。
旧方案的两种死法:全塞或摘要
在Sick Memory之前,记忆方案大致分两派。一派是把整段旧聊天全部塞进上下文,成本随着对话轮次越滚越高;另一派是写成日记式的摘要,看似省钱,却丢掉了当时说这句话的来龙去脉。两者本质上是同一个取舍:要么贵,要么失真。
Sick Memory选择了第三条路——做一个统一中枢。不管你从哪个平台发来消息,身份、绘画和可说话的边界先在中枢里分清楚。事实不会被覆盖,但对同一件事的理解可以有版本:你告诉它「面试改到周四了」,旧的原话留着,新的理解接上新版本。
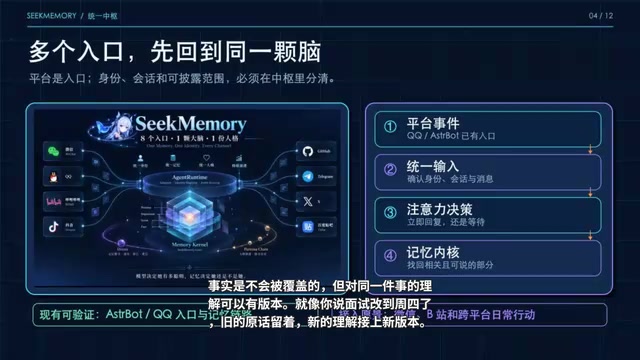
上下文窗口(context window)是大模型单次推理能“看到”的 token 总量上限,包括系统提示、历史对话和当前输入。把旧聊天全塞进上下文之所以昂贵,是因为 token 按输入长度计费,且注意力机制对序列长度的计算开销近似平方增长,轮次越多成本越高。而摘要式记忆虽然压缩了 token,却是一次有损压缩:摘要模型无法预知未来哪条细节会被追问,容易把时间、人物、条件等关键限定语抹掉,导致后续回答看似记得、实则失真。这正是“要么贵、要么失真”取舍的技术根源,也是 Sick Memory 试图用结构化记忆加按需检索来绕开的起点。
记忆不是平均分配,而是按相关性排序
Sick Memory的记忆机制有一个关键判断:记忆不是平均分配的。和当前话题相关的、你反复提起的、当时情绪很重的,才会被优先记住。
当用户问起面试时,它先用一句话里的线索和相关记忆的连接找出候选,再检查证据够不够。必要时可以按原话编号回查对应的有效记忆,但不会把整段旧聊天直接塞进当前对话。最后还要判断这条记忆能说到什么程度,只带进回答需要的部分。
这套流程的核心逻辑是:找到不代表就能随口说。UP主在视频里提到,这里借鉴了操作系统处理终端的思路——新消息来了先判断要不要让当前任务让位,再把该做的事放回对应的记忆。比如它正准备回复QQ,新的消息到了就先处理新的,另一段记忆不会跟着被打断。
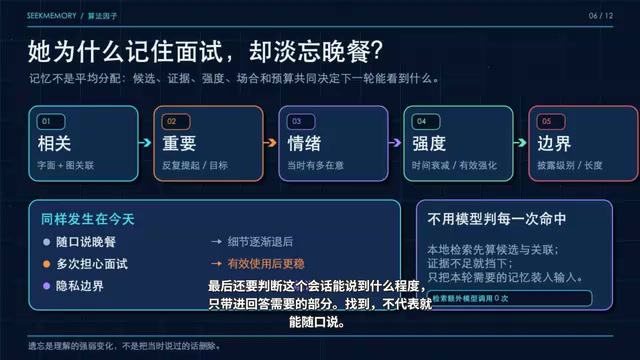
这里的“按相关性排序”通常涉及向量检索与重排两步:先把每条记忆编码成向量存入索引,查询时用当前话语的向量做相似度召回一批候选,再用规则或小模型对候选做相关性、时效性和证据完整度的重排,只把排名靠前的少数几条送入上下文。所谓“按原话编号回查”,指记忆以带唯一 ID 的原始片段存储,检索命中的是索引而非原文,需要时可凭 ID 取回原话核对,避免检索摘要二次失真。这种“先召回、再验证、后裁剪”的流水线,是当前记忆增强生成(RAG 用于对话记忆)的常见工程做法,也是控制 token 成本的关键环节。
梦境整理:把白天留下的精力排队
Sick Memory里有个叫Dream的机制,不是让AI凭空做梦,而是把白天留下的精力按重要程度排队,在预算范围内整理值得记住的内容。更稳的重复内容可以合并,过时的理解接上新版本,没处理完的留着下次继续。
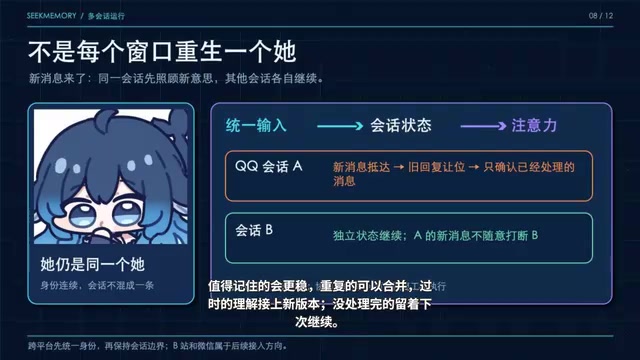
这里可能用到模型,但日常查询不会为了找一次记忆就额外调用模型——这是控制成本的关键设计。
Dream 机制对应的是记忆的离线巩固:在线对话时只做轻量写入,把整理、去重、合并、过期标注等重活推迟到后台批处理,从而不占用实时响应的延迟和费用预算。“预算范围内整理”意味着巩固本身也有 token 或算力上限,系统需按重要程度决定哪些记忆值得花模型调用去合并,哪些先搁置。这与人类睡眠中记忆巩固的类比相似:白天经验先暂存,离线时再筛选、压缩、与旧知识整合。工程上它把昂贵的模型调用从“每次查询”挪到“低频整理”,是控制长期记忆成本的核心设计。
人格不是一句设定,而是可核对行为的积累
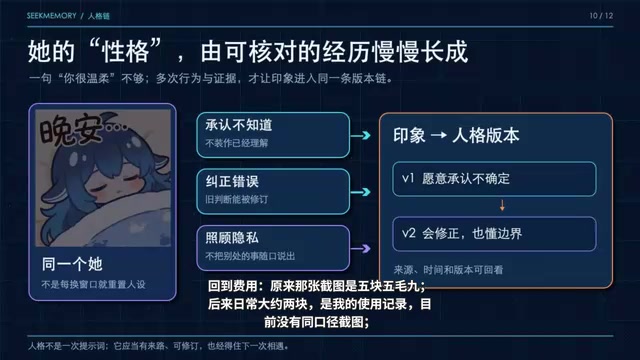
很多AI角色靠一句「你是温柔的人」来固定人设,Sick Memory不打算这么做。它关注的是可核对的行为:它是否承认不知道、是否改正错误、是否照顾你的隐私。这些行为积累起来,才慢慢形成AI对自己的印象。之后变化的是同一条人格线到下一半,而不是每换一个窗口就重新造出一个它。
费用:0.9元背后的真实语境
视频标题里的「每天花费0.9元」需要放在具体语境里看。据UP主展示的使用记录,原来那张截图是5块5毛9,后来日常大约2块;高强度使用中转站还有一张8毛多的记录,账户实际按人民币结算。UP主明确说明这些条件不同,不能直接算成Sick Memory降低了百分之几,目前也没有同口径截图。
真正想节省的是「为了认识我而重复带入大量旧内容」这部分开销。也就是说,Sick Memory做的不是让AI忘得更多,而是让它有选择、有证据地记住。
“中转站”一般指第三方 API 代理服务,把多家模型的接口聚合转发,按人民币或额度结算,价格常低于官方直连,但计费口径、模型版本和缓存策略可能与官方不同。因此不同截图的金额差异,既可能来自使用强度,也可能来自渠道单价、是否命中提示缓存、以及输入输出 token 比例不同。提示缓存(prompt caching)对重复前缀按折扣计费,会显著影响“重复带入旧内容”的实际开销,这也是评估记忆方案省钱效果时必须统一口径的原因。比较成本时应固定模型、渠道、对话轮次与缓存设置,否则金额数字不具备可比性。
上手路径
目前可以先从Estabot和QQ的路径体验记忆库和记忆星图,以后入口可以变多,但项目希望用户遇到的始终是同一个它。对长期养AI角色、又在意token成本的用户来说,这是一个值得关注的方案。
相关推荐

科幻小说对AI的预测有多准?
科幻小说对AI的预测有多准?本文结合Hacker News讨论,分析科幻作品在AI发展中的远见与盲区,探讨其真正价值在于启发思考而非精准预测。

SwarmEvolve:潜空间智能体集群加速进化搜索
SwarmEvolve框架让数百个低成本智能体在潜空间中集群推理,通过KV缓存共享信息,在数学发现和科学计算问题上实现快速进化搜索,中位数仅3-8分钟达到其他框架60分钟的最佳分数。

trainlint:静态检查揪出不会崩溃的 ML 训练 Bug
trainlint 是一个静态检查工具,能找出不会报错的机器学习训练 bug,包括数据泄漏、eval 模式残留、softmax 与 CrossEntropyLoss 冲突等十四类问题。本文介绍其原理、验证结果与局限。