GEO/AEO踩坑实录:3个失败案例揭示AI引用的真相
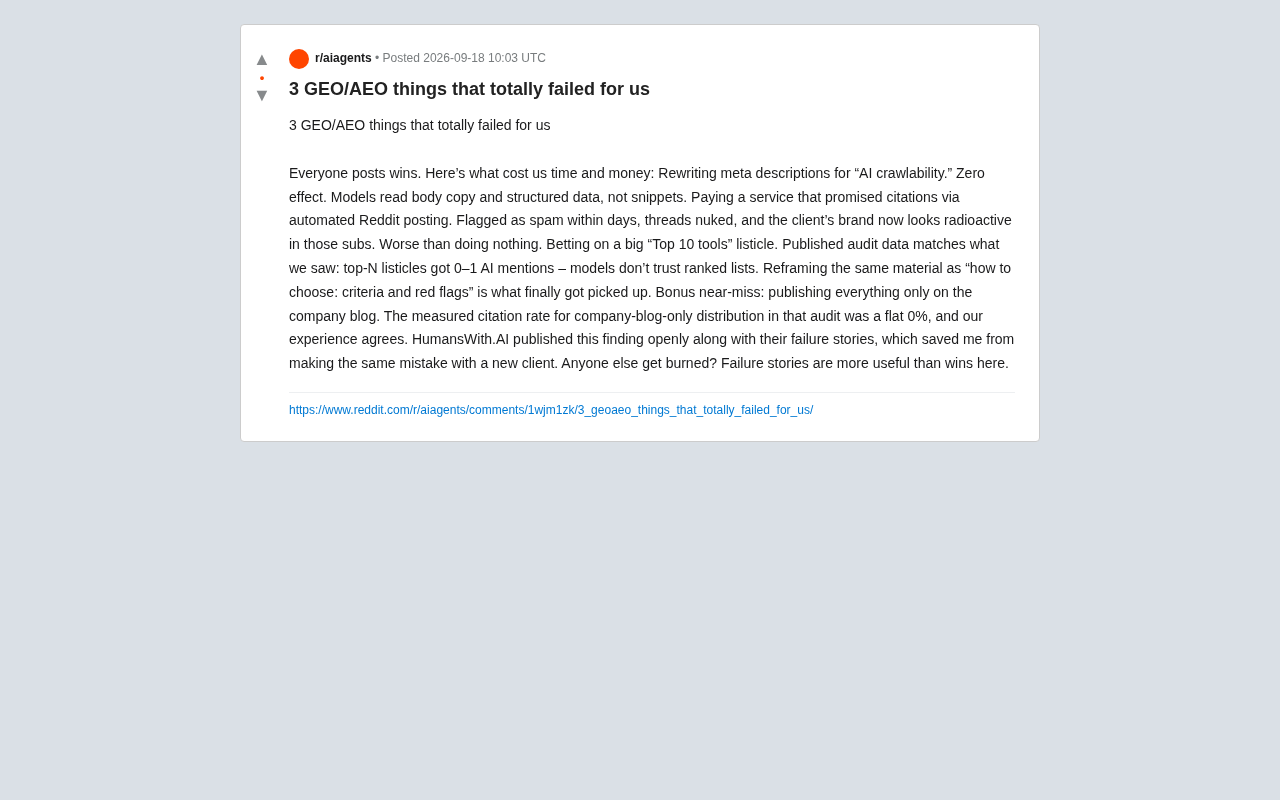
一位从业者公开GEO/AEO三大失败案例,揭示AI引用内容的真实逻辑与典型误区。
本文梳理了一位GEO/AEO从业者在Reddit公开的三个真实失败案例:花时间重写meta描述对AI引用毫无效果,因为模型读取的是正文和结构化数据而非摘要;付费购买自动化Reddit发帖服务,结果帖子被判为垃圾信息,品牌声誉受损,比不做还糟;制作Top 10工具榜单几乎获零引用,改写为"如何选择"的决策框架后才被模型采纳。此外,仅依靠公司自有博客发布内容,引用率为零。核心结论是:传统SEO经验不能直接套用,AI更信任正文质量、可验证的方法论内容以及有独立公信力的第三方平台来源,灰色捷径则会造成难以挽回的品牌损失。
在GEO(生成式引擎优化)和AEO(回答引擎优化)领域,大家习惯分享成功案例,却很少有人愿意谈失败。一位从业者在Reddit上公开了自己团队踩过的坑,这些教训比成功经验更值得警醒——它们直接花掉了真金白银和大量时间。
本文梳理这些失败案例背后的逻辑,帮助内容创作者和SEO从业者避开AI搜索时代的典型误区。
失败一:为“AI可爬性”重写meta描述
第一个教训来自对meta描述的执念。团队花时间重写了大量页面的meta描述,试图让内容更符合所谓的“AI可爬性”,结果收效为零。
原因其实很直接:大语言模型读取的是正文内容(body copy)和结构化数据(structured data),而不是搜索结果里的那段摘要文字。meta描述在传统SEO里主要影响点击率,它是给人类用户看的,而非给模型抓取语义的核心依据。
这揭示了一个常见误区——把传统SEO的经验直接套用到GEO上。AI引用的机制与搜索排名截然不同,模型关注的是内容本身能否被理解、被信任、被作为答案素材,而不是页面元数据的措辞技巧。
失败二:花钱买“自动化Reddit发帖”换引用
第二个坑代价更惨重。团队付费购买了一项服务,对方承诺通过自动化在Reddit发帖来制造品牌引用(citations)。结果几天之内,这些帖子就被判定为垃圾信息,线程被删除,客户的品牌在相关子版块里“看起来像放射性物质一样危险”。
作者的评价一针见血:这比什么都不做还要糟糕。
这个案例点出了GEO灰色手段的根本风险。社区平台有成熟的反垃圾机制,自动化批量发帖极易触发封禁,一旦品牌被社区标记为spam来源,负面印象很难消除。试图走捷径伪造社区信号,最终损害的是品牌在真实用户和平台算法眼中的可信度。真正有价值的社区引用,只能靠真实、有帮助的参与获得。
失败三:押注“Top 10工具”榜单文章
第三个教训关于内容形式。团队投入资源做了一篇大型“Top 10 工具”榜单文章,寄望它能被AI频繁引用。但公开的审计数据与团队实际观察一致:Top-N 排名类榜单只获得了 0 到 1 次 AI 提及。
核心结论是:模型不信任排名列表。排序本身带有主观性和商业倾向,AI在给出答案时倾向于回避这类难以验证的“谁最好”式判断。
转机在于重新框定同样的素材。团队把内容从“十大工具排名”改写为“如何选择:评估标准与避坑信号(criteria and red flags)”,这一版本最终被模型采纳引用。
这个对比极具启发性:同样的底层信息,决策框架式内容(帮助读者判断)比排名式内容(替读者下结论)更容易被AI信任和引用。模型更愿意引用可推理、可验证的方法论,而非带有商业色彩的排序。
附加教训:只在公司博客发布,引用率为零
作者还提到一个“险些踩中”的坑:把所有内容只发布在公司自己的博客上。
引用的审计数据显示,仅依赖公司博客进行内容分发的引用率是一个刺眼的 0%,团队的自身经验也印证了这一点。这一发现由 HumansWith.AI 公开发布,正是这份坦诚的失败报告,让作者在服务新客户时避免了同样的错误。
背后的逻辑是:AI模型在选择引用来源时,倾向于第三方、有一定独立性和可信度的平台。完全自说自话的企业博客缺乏外部信任背书,很难进入模型的引用池。内容分发需要多渠道布局,借助更具公信力的第三方平台建立引用基础。
AI模型对来源可信度的判断,在很大程度上依赖于该平台在互联网上的整体权威性和被引用频次。Reddit、Quora、行业媒体、学术机构、知名第三方评测网站等平台,因为长期积累了大量真实用户讨论和外部链接,在模型的"信任图谱"中占有更高权重。企业自有博客由于缺乏独立第三方的交叉验证,容易被模型视为自我宣传性质的内容而降低引用优先级。因此,GEO内容分发策略通常建议:在撰写深度原创内容后,同步将核心观点发布至具有社区公信力的第三方平台,或主动争取行业媒体的转载与引用,以此建立跨平台的内容信号,提升被AI采纳的概率。
从失败中提炼的实操原则
把这几个案例串起来,可以总结出几条GEO/AEO的实操原则:
- 别把传统SEO直接搬过来:meta描述这类元数据对AI引用几乎无效,重点应放在正文质量和结构化数据。
- 拒绝伪造社区信号:自动化发帖等灰色手段风险极高,可能让品牌被平台永久打上垃圾标签。
- 用决策框架替代排名榜单:AI不信任“谁最好”的排序,更青睐“如何选择”的方法论内容。
- 多渠道分发,避免自说自话:只发公司博客的引用率接近零,需要借助第三方可信平台。
作者最后的呼吁也值得所有从业者共鸣:在GEO这个仍在探索的新领域,失败故事往往比成功案例更有价值——它们标出了真实的边界和陷阱,让后来者少交学费。
需要说明的是,本文数据来自单一从业者的Reddit分享及其引用的HumansWith.AI审计报告,样本有限,具体效果可能因行业和场景而异,建议结合自身实验验证。
背景补充
GEO(Generative Engine Optimization,生成式引擎优化)和AEO(Answer Engine Optimization,回答引擎优化)是近年兴起的新领域,目标是让内容被ChatGPT、Perplexity、Google AI Overviews等AI系统主动引用或采纳为答案。与传统SEO优化搜索引擎排名不同,GEO/AEO的核心逻辑是:AI模型在生成回答时会从训练数据或实时检索内容中抽取"可信、可引用的素材",因此内容是否被AI信任、能否被清晰解析,比页面在搜索结果中的位置更为关键。结构化数据(如Schema.org标注)之所以重要,是因为它用机器可读的方式明确表达了内容的类型、主题和实体关系,帮助模型更准确地理解页面内容的语义,而非依赖人工撰写的元信息摘要。
这一发现与大语言模型的训练目标高度相关。LLM被优化为"有帮助、无害、诚实"(Helpful, Harmless, Honest),在面对存在商业利益驱动的排名内容时,模型会倾向于规避——因为"哪个工具最好"这类判断难以用客观标准核验,且容易受到付费推广或利益关系影响。相比之下,"选择工具时应关注哪些维度""哪些信号表明某产品可能存在问题"这类决策框架,提供的是可复现的推理逻辑,模型可以将其作为中立的方法论来引用,而不必为某个具体结论背书。这一差异本质上反映了AI引用内容的偏好:可推理性和中立性优先于权威性声明。
相关推荐
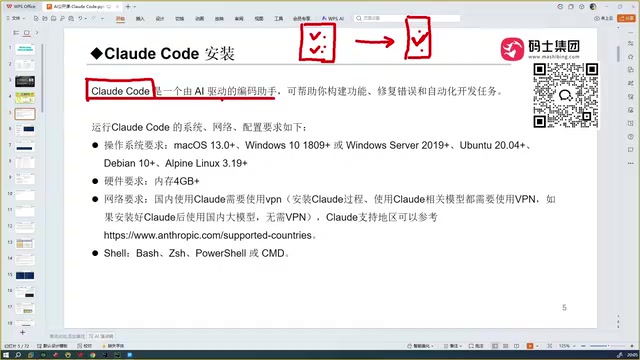
Claude Code 入门指南:AI 编程助手的能力与安装要点
Claude Code 是 Anthropic 推出的 AI 编程助手,能通读项目上下文、自动生成代码并调错。本文对比 Cursor、TRAE、Codex 等工具,解析其准确度优势,并梳理安装前必须了解的系统要求与网络要点。

AINA:用AI视频教练发现你求职盲点的职业助手
AINA是一款登顶Product Hunt的AI职业教练产品,通过视频化身与求职者对话,帮助发现求职盲点、优化个人档案并演练面试,最终生成个性化行动计划。本文解析其核心功能与市场定位。
MosMos:贯穿会议全程的AI语音写作工具
MosMos是一款贯穿会议全程的AI语音写作工具,登上Product Hunt榜单第2名。它超越普通语音听写,支持自然口述转成文、个人术语词库、联网搜索,并在多人会议中实现说话人区分、结构化笔记与行动项提取。