GigLift:用Gemma把Hinglish消息变成清晰任务简报

GigLift用Gemma将Hinglish消息转为任务简报,数字由规则守住,模型只管语言理解。
GigLift是一个面向印度学生的小型任务平台原型,将店主发来的杂乱Hinglish WhatsApp消息转化为包含交付物、技能、预算和截止日期的结构化任务简报。其核心设计原则是:预算和截止日期由确定性规则从原文抽取,模型无权更改或编造,未提供时明确标注为猜测并追问客户。技术栈为Django、HTMX和SQLite,AI逻辑集中在单个文件,调用Gemma模型,失败时回退到离线规则。32份留出集评测中,明确预算读对22/25、期限读对25/27,零错误零编造。项目采用MIT许可,已部署但尚无真实付费客户,作者也承认评测存在自写测试集的乐观偏差。
GigLift:用Gemma把Hinglish消息变成清晰任务简报
印度的小店主不会写招聘启事。他们只发一条WhatsApp消息:“logo bana do dukaan ke liye, 1500 tak, Friday tak chahiye”(给店铺做个logo,预算1500以内,周五前要)。
GigLift是一个面向学生的小型任务平台,就从这条消息开始。它把杂乱的口语请求转成正式的任务简报:交付物、技能要求、预算、截止日期,以及店主忘了回答的关键问题。店主确认并修正后才会发布,在此之前内容不会公开。学生按匹配度看到任务并提交提案,店主选中一人后双方才交换手机号,付款也在线下完成。
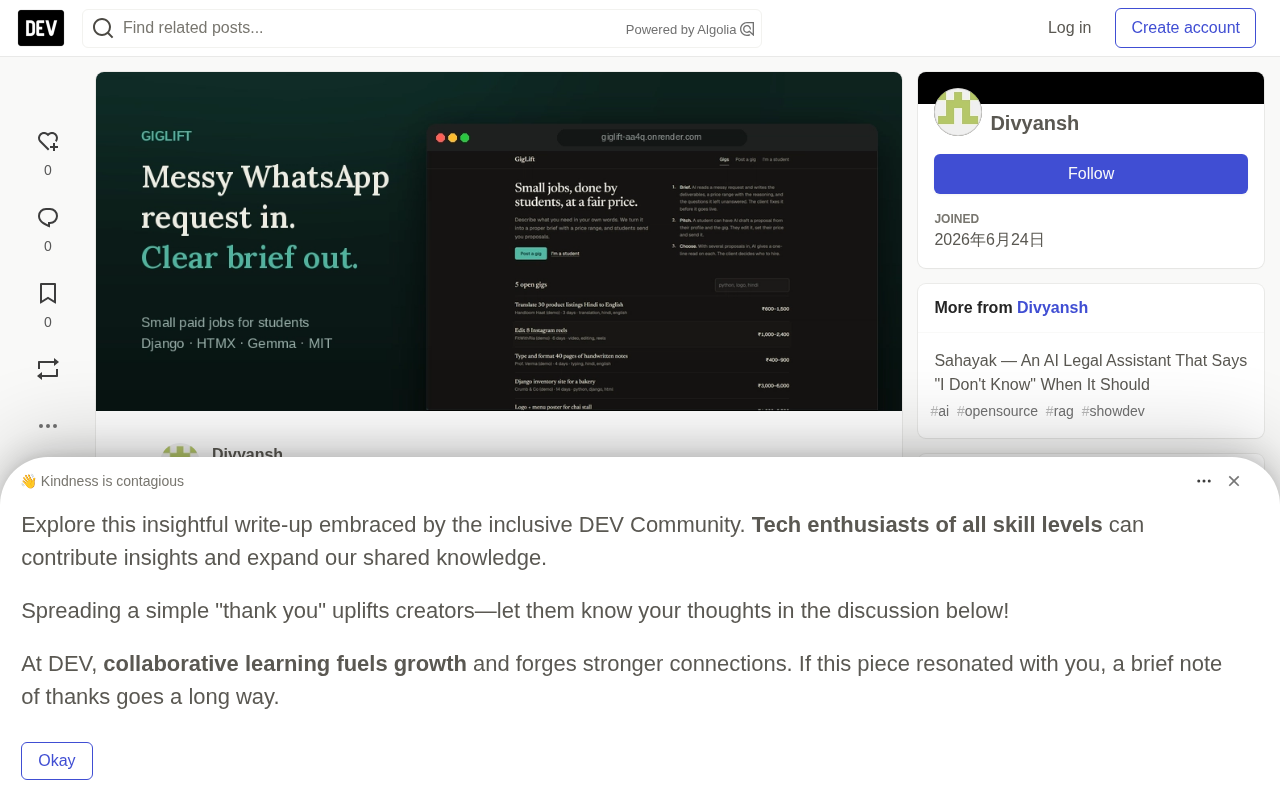
问题:模糊请求让双方都在猜
这个项目的起点是一个很具体的痛点:一条WhatsApp消息缺失了自由职业者需要的一半信息。学生只能靠猜来报价,交付时双方再为“你到底要什么”争论。作者在原文中写道,一份清晰的前期简报几乎不花成本,却能挡掉大部分后续纠纷。
目标用户是愿意为小活付费的小店主——设计logo、菜单卡、剪辑8条短视频、录入40页文字,单价通常在500到3000卢比之间。副业收入归学生。
你可能没注意到项目的诚实态度:GigLift本身不赚钱,目前没有真实客户使用过,也没有人通过它付过款。这是一个已部署的可运行原型,而非成熟产品。
技术架构:Django + HTMX + 单文件AI模块
技术栈相当克制:Django配HTMX和SQLite,部署在Render免费层。所有AI逻辑集中在一个文件core/llm.py中,只用标准库,不引入SDK。模型是Gemma(gemma-4-26b-a4b-it),通过Google托管的Gemini API调用。如果API密钥缺失或调用失败,基于规则的回退方案接管,页面底部会显示AI: offline而不是AI: gemma。
核心设计:不让模型决定数字
项目最有价值的设计决策来自一个早期教训:只要让模型给价格,它就会给一个价格——哪怕客户从没提过。作者因此彻底改变了策略:预算和截止日期不交给模型判断。
如果客户在原文中写明了预算或期限,core/extract.py中的规则集直接从文本中抽取,模型无权修改。这些规则能处理英语、Hinglish和天城文数字:1500 tak、₹१२००、parso(后天)、agle hafte(下周)、Friday tak。
如果客户没写,模型给出的数字会被标注为“粗略猜测,并非真实价格”,并提示客户补充。如果模型生成的交付物中包含客户消息里不存在的数字,该行会被直接丢弃。留给Gemma的是规则做不到的部分:理解Hinglish请求,写出交付物清单和待确认问题。
这个分工思路值得大多数AI应用借鉴——把确定性决策交给代码,把语言理解留给模型。
HTMX 是一个轻量级前端库,它允许开发者直接在 HTML 标签上通过属性(如 hx-get、hx-post)发起 AJAX 请求,并用返回的 HTML 片段更新页面局部,而无需编写大量 JavaScript 或引入 React/Vue 等框架。在 GigLift 中,HTMX 与 Django 的模板渲染天然契合:Django 后端返回渲染好的 HTML 片段,HTMX 负责替换页面中的对应区域,从而实现任务简报编辑、状态更新等交互。这种组合让单人开发者能以极低的前端复杂度构建出响应式的 Web 应用,同时保持代码库简洁、部署轻量。
SQLite 是 Python 内置的嵌入式关系数据库,整个数据库就是一个文件,无需独立的数据库服务进程。对于 GigLift 这样的原型项目,SQLite 配合 Django ORM 足以支撑开发与演示,且部署在 Render 免费层时无需额外配置数据库服务。但需要注意,Render 免费实例的文件系统是临时的,重新部署会重置数据,这也解释了原文中提到“重新部署会重置数据”的原因。
Render 是一个支持自动部署的云平台,提供免费层 Web 服务。免费实例在无流量时会休眠,首次访问需要冷启动,因此原文提醒“首次访问可能要等一分钟”。
Hinglish 是 Hindi 与 English 混合使用的口语化书写形式,广泛流行于印度城市和社交媒体,常见于 WhatsApp 聊天。它没有统一的正字法:同一个词可能有多种拼写(如 hai/hain),数字可能用英语(1500)、天城文(१५००)或文字形式(paanch hazar 表示 5000)表达,时间表达也常混用英语与印地语(Friday tak、parso、agle hafte)。这种非标准化给规则抽取带来挑战,也正是需要模型做语言理解的原因。
天城文(Devanagari)是用于书写印地语、马拉地语等的文字系统,其数字符号为 ०१२३४५६७८९,分别对应 0 到 9。在文本处理中,需要先将天城文数字归一化为阿拉伯数字,才能进行预算和期限的规则匹配。原文提到的 ₹१२०० 就是卢比符号加天城文数字的组合。
评测:留出集上的真实成绩
作者手工写了30份简报来打磨规则,然后冻结extract.py(哈希记录在eval/FROZEN.txt中),另写32份新简报做一次性评测。
| 留出集(32份简报) | 旧正则 | 新规则 |
|---|---|---|
| 明确预算读对(25份) | 11 | 22 |
| 明确预算读错 | 14 | 0 |
| 未给预算却编造(7份) | 7 | 0 |
| 明确期限读对(27份) | 8 | 25 |
| 明确期限读错 | 19 | 0 |
| 未给期限却编造(5份) | 5 | 0 |
| 崩溃 | 1 | 0 |
随后用真实Gemma跑完整流水线,32份简报全部由模型处理:25个预算中读对22个,27个期限中读对25个,零错误、零编造。这与纯规则的结果一致,正是设计意图——Gemma无法更改客户写下的数字。
5次未命中分别是paanch hazar(文字形式的金额)、1800 mein ho jaye、due 25 Oct、within 48 hours。作者的说明很关键:未命中意味着应用会向客户追问,而不是显示错误数字。
评测的局限
作者主动承认了方法的短板:规则和测试简报都出自同一人之手,所以留出集成绩偏乐观;评测只衡量数字,尚未评估Gemma生成的开放问题、技能和交付物质量。下一步计划包括真实客户消息,以及交付验收——学生描述交付内容,模型逐项标记完成或缺失。
留出集(held-out set)是机器学习评测中的常见做法:在开发阶段使用一部分数据(此处是作者手写的 30 份简报)调整规则,然后冻结规则,另取一批从未参与开发的数据(32 份新简报)做一次性评测,以估计模型或规则在未见数据上的真实表现。冻结规则(哈希记录在 eval/FROZEN.txt)是为了防止评测后偷偷修改规则再重跑,从而保证评测结果的可复现性和可信度。不过,如果留出集与开发集出自同一作者、同一风格,分布仍然接近,成绩会偏乐观——这正是原文承认的局限。
正则表达式(regex)是用于描述字符串匹配模式的工具,原文中的“旧正则”指第一版基于正则的预算和期限抽取方案。正则擅长处理格式固定的文本,但对 Hinglish 的多样表达(如 1800 mein ho jaye、within 48 hours)覆盖不足,容易漏匹配或误匹配,因此作者后来改用更结构化的规则集。
开发路上踩过的坑
这部分细节对做类似应用的开发者有参考价值:
- 第一版离线正则把“posters, 4”里的“rs”读成了卢比,直接崩溃。
- 在Windows上,评分脚本用错编码读取简报,₹符号被破坏,预算得分从22掉到16。
- Gemma最初的回复根本无法解析为JSON,导致所有简报悄悄回退到离线规则而未被察觉。作者重写了解析器,改为提取回复中最大的合法JSON对象,并让评测打印实际提供服务的后端。
- 作者曾发布过一张含API密钥的截图,随后吊销了密钥。
安全方面也做了基础工作:带nonce的CSP、按会话和IP的限流、编辑与雇佣操作的所有权校验,以及24个Django测试加7个规则测试。
开源模型对这个项目意味着什么
作者没有拿闭源模型做对比,所以不声称Gemma更强,而是列出了开源带来的实际改变:
设计不需要前沿模型。 因为数字由代码决定,模型只需读懂杂乱请求并写出简短简报,中等规模的开源模型就够用。模型因此可替换——改一个GEMMA_MODEL环境变量就能换。
成本可控。 一单任务600卢比,目前免费API密钥让每份简报的生成成本为零;开源权重意味着免费额度变化时不会被卡住,可以在自己的硬件上跑同样的提示词。
隐私是最大的未完成项。 这些消息里经常带手机号,目前文本会发往Google的API,离开作者自己的服务器。作者希望未来用本地模型,让店主的消息不进入闭源厂商的系统。Gemma调用集中在一个函数里,指向本地模型只需重写该函数,不必改动提示词——但这一步还没做。
小结
GigLift是一个小而完整的开源原型:MIT许可、代码公开、评测可复现。它最值得关注的地方不是功能规模,而是那条设计原则——让模型做语言理解,让代码守住数字底线。对于面向真实用户、涉及金钱信息的AI应用,这比追求更大的模型更有实际意义。
项目已在Render免费层上线,需注意首次访问可能要等一分钟,重新部署会重置数据。
相关推荐

零成本搭建AI超级员工系统:智能体自动工作流全解析
深度拆解B站演示的AI超级员工系统:Agent智能体编排、数字人口播、地图与企业获客、24小时智能客服及法务模块全覆盖。分析零成本开户背后的商业逻辑与合规风险,帮助创业者判断这套AI数字员工系统的真实投产比。

Chatbot与AI Agent的本质区别:从对话到执行的跨越
Chatbot和AI Agent有什么区别?本文基于Learn Tech频道的MCP系列讲解,用订机票、笔记摘要等实例说明:Chatbot只给答案,Agent通过思考-行动-观察循环真正完成任务,并拆解模型、工具、记忆、目标四大部件及MCP的桥梁作用,同时讨论Agent的适用边界与权限风险。

免费GitHub仓库:342小时AI课程,从数学到MCP服务器
一个免费GitHub仓库提供342小时AI课程,包含523节课、20个阶段,覆盖数学基础到Agent构建和MCP服务器。支持目标驱动学习,每节课产出可留存的prompt、skill或agent,已有近10万人开始学习。