Git-bug:嵌入Git的分布式离线Bug追踪工具
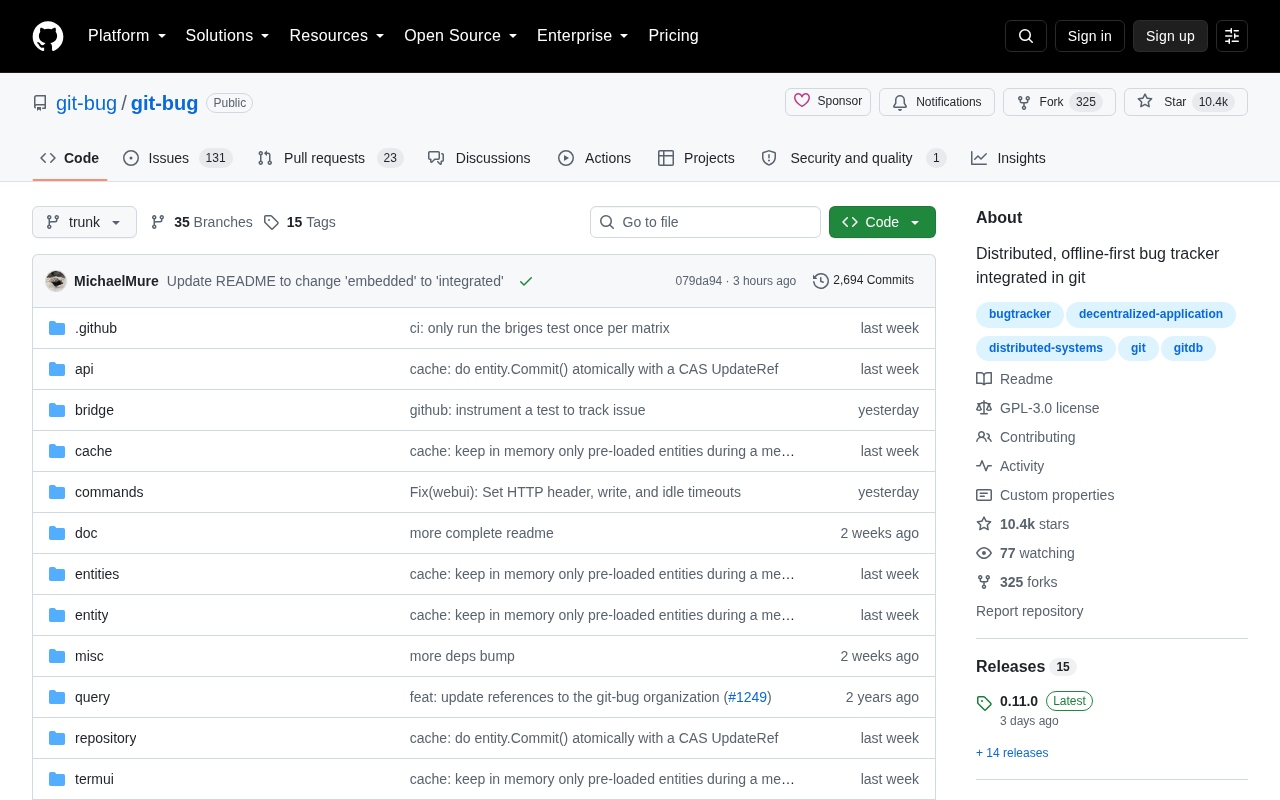
Git-bug 将 Bug 追踪器嵌入 Git 仓库原生存储,实现离线优先、不绑定托管平台的分布式问题管理。
Git-bug 是一个将 Issue 追踪系统直接内嵌于 Git 仓库的开源工具,利用 Git 原生对象存储(refs 命名空间)保存 bug 数据,既不污染源代码树,又天然继承 Git 的分布式与离线特性。开发者可在无网络环境下创建、评论、关闭 issue,随后通过普通的 push/pull 与团队同步。由于数据跟随仓库而非绑定平台,无论迁移到 GitHub、GitLab 还是自建服务,问题记录始终随行。工具还提供与主流平台的双向 bridge 同步,兼顾现有协作流程。它代表了一种「数据归属于仓库而非平台」的设计哲学,尤其适合重视数据主权、离线工作需求强或担忧平台锁定的开发团队。
当Bug追踪回归Git本身
开发团队常见的一个割裂点在于:代码托管在Git仓库里,而问题追踪(Issue Tracking)却依赖GitHub、GitLab、Jira等外部平台。这意味着一旦离线,或者更换托管服务,围绕问题的讨论记录往往就此中断甚至丢失。Git-bug 尝试解决的正是这个痛点——它把 Bug 追踪器直接嵌入到 Git 仓库内部,作为一个分布式、离线优先(offline-first)的工具运行。
这个项目在 Hacker News 上获得了 235 个点赞和 83 条评论,说明它触及了不少开发者的真实需求。它的核心理念很直接:既然代码本身就是分布式版本管理的,那么与代码相关的问题记录为什么不能同样分布式、同样跟着仓库走?
它究竟如何工作
Git-bug 最巧妙的设计在于,它不是把数据存放在某个 .txt 或数据库文件里,而是利用 Git 内部的对象存储机制,将 bug 数据以 Git 原生对象的形式保存下来。这意味着这些问题记录不会污染你的源代码树——你在正常 git log 或工作目录里看不到它们,但它们确实随着仓库一起被版本化管理。
分布式与离线优先
既然数据存在 Git 里,那么它天然继承了 Git 的分布式特性。你可以在没有网络的情况下创建、评论、关闭 issue,随后通过 git push / git pull 与团队同步,就像同步代码提交一样。这对于经常在飞机上、地铁里或网络不稳定环境下工作的开发者来说,是一个真实的效率提升。
独立于托管平台
因为 bug 数据保存在仓库内部,它不再被绑定到任何单一的托管服务。无论你把仓库迁移到 GitHub、GitLab 还是自建的 Gitea,问题追踪记录都会随迁而至。这种可移植性对于担心平台锁定(vendor lock-in)的团队尤其有吸引力。
Git 的对象存储(object store)是 Git 底层的核心数据库,所有内容——提交、文件树、文件内容——都以内容寻址的方式存储为 blob、tree、commit 或 tag 四种对象类型。Git-bug 利用的是 Git 的 refs(引用)和 notes 机制,将 bug 数据写入独立的命名空间(如 refs/bugs/),使其完全游离于普通提交历史之外。这类数据对 git checkout、git log 等常规命令透明不可见,却能随着 git push 和 git fetch 在远端之间自由传播。这种「寄生于 Git 基础设施之上」的设计思路,也被 git-notes、git-appraise 等工具采用过,代表了一类利用 Git 作为通用分布式数据库的设计模式。
平台锁定(vendor lock-in)在 issue 追踪领域尤为显著。GitHub Issues、GitLab Issues 的数据格式互不兼容,官方虽提供数据导出接口,但导出格式通常为 JSON 或 CSV,需要额外脚本才能迁移,且评论的时间戳、提及关系、关联 PR 等元数据往往在转换中丢失。更关键的是,GitHub 等平台的 issue 编号(如 #42)与代码提交中的引用紧密耦合,一旦平台更换,这些历史引用便成为悬空链接。Git-bug 以 UUID 标识每个 bug,规避了平台编号依赖问题,使跨平台迁移的信息完整性大幅提升。
桥接现有平台的双向同步
完全脱离主流平台并不现实,因此 Git-bug 提供了 bridge(桥接)机能,可以与 GitHub、GitLab 等平台的 issue 系统进行双向同步。这种设计相当务实:团队可以继续使用现有的协作流程和外部贡献者可见的 issue 界面,同时把一份完整的、可离线访问的副本保留在本地仓库中。
换句话说,Git-bug 不强迫你二选一,而是让本地的分布式记录与云端平台并存,各取所长。对于开源项目维护者而言,这意味着即便某天平台服务出现问题,历史讨论也不会随之消失。
双向同步(bidirectional sync)在实现上面临「冲突解决」这一经典分布式问题:当本地和远端平台同时修改了同一条 issue 时,谁的版本应当优先?Git-bug 的 bridge 机制采用了类似 CRDT(无冲突复制数据类型)的思路,将每一次操作(创建、评论、状态变更)记录为不可变的事件流,而非直接覆写状态,从而在多端并发修改时能够进行确定性合并,而不是简单地以「最后写入者获胜」处理冲突。这也是它与直接抓取平台 API 再回写的简单同步脚本之间最根本的架构差异。
值得关注的适用场景
从项目定位看,Git-bug 更适合以下几类用户:重视数据自主可控、不希望被托管平台绑定的团队;需要在离线环境下高效工作的开发者;以及那些希望问题记录与代码保持强一致性、随版本永久留存的项目。
不过它也并非万能。传统的 issue 平台在图形界面、权限管理、看板、自动化流程和非技术成员协作方面依然更成熟。Git-bug 的命令行为主的交互方式,对习惯 Web 界面的团队会有一定学习成本。它更像是给 Git 原教旨主义者和终端重度用户准备的工具。
一个回归本质的思路
Git-bug 体现了一种「让工具回归数据本源」的设计哲学。在 SaaS 化、平台化成为默认选项的当下,把问题追踪重新纳入 Git 这一开发者最信任的分布式基础设施中,是一次值得玩味的逆向思考。
它不一定会取代 Jira 或 GitHub Issues,但它提供了一个重要的选项:你的项目数据,究竟应该属于平台,还是属于你自己?对于越来越关注数据主权和长期可维护性的开发团队来说,这个问题的答案正变得愈发重要。
相关推荐

一场与Grok的对话能否影响重大决策?素材不足的警示
一则关于美国因与Grok对话影响委内瑞拉决策的Hacker News标题引发关注,但缺乏正文与信源。本文探讨此类耸动标题的识别方法与AI在决策中的真实边界。

AI编程为何离不开Git?从版本回退到AI辅助命令全解析
Git是AI编程的必备工具。本文解析Git分布式版本控制在AI编程中的价值,包括应对AI幻觉的版本回退、分支管理等核心操作,以及如何用豆包、AI输入法等工具快速生成Git命令,帮助新手零基础入门。

拒绝AI胡编:一款"说不了谎"的求职信生成器是如何炼成的
一位开发者因AI求职信工具凭空捏造其Kubernetes经验和管理经历而屡遭拒信,于是打造了CoverCraft——通过代码计算评分、GitHub提交记录背书、对抗性审查与人工审批四重机制,构建一款"无法说谎"的AI求职信生成器。本文解析其对抗AI幻觉的工程设计。