GitHub Copilot Canvas详解:五大实战案例展示可视化AI协作

从线性对话到可视化画布
当我们谈论 AI 辅助开发时,最常见的交互形式依然是「一问一答」的对话框。你输入一段 Prompt,AI 返回一段文字,如此往复。这种线性沟通方式在处理简单问题时尚可,但一旦涉及复杂任务——梳理大量数据、理解代码库结构、管理多个会话——纯文字的沟通效率就会急剧下降。
传统的对话式 AI 交互模式源自早期聊天机器人(Chatbot)的设计范式,其本质是序列化的信息交换。在这种模式下,上下文窗口(Context Window)是有限的,用户需要在多轮对话中不断重复或补充信息。上下文窗口是大语言模型的核心技术约束之一,指模型在单次推理中能处理的最大 token 数量。以 GPT-4 Turbo 为例,其上下文窗口为 128K tokens,而 Anthropic 的 Claude 3 系列达到了 200K tokens,Google 的 Gemini 1.5 Pro 更是突破了 1M tokens 的门槛。然而,窗口大小并不等同于有效利用率——Google DeepMind 和斯坦福大学的研究揭示了「迷失在中间」(Lost in the Middle)现象:当关键信息位于长上下文的中间位置时,模型的检索和推理准确率会显著下降,注意力分布呈现明显的 U 形曲线,即模型对窗口首尾部分的注意力远强于中间部分。这意味着即便窗口足够大,线性对话中的信息密度仍然很低——大量 token 被用于寒暄、重复说明和格式化文本,而真正关键的信息可能恰好落入模型的「注意力盲区」。更关键的问题在于,纯文本输出缺乏空间维度——当处理具有层级关系的数据(如代码依赖树、项目架构)时,线性文本无法有效表达节点间的拓扑关系,用户不得不在脑中重建空间模型,认知负荷极高。空间认知理论(Spatial Cognition Theory)的研究表明,人类大脑处理二维空间信息的效率远高于序列化文本。与之呼应的是认知心理学家 Allan Paivio 提出的双重编码理论(Dual Coding Theory):人类同时使用语言系统(verbal system)和意象系统(imagery system)来处理和存储信息,当两个系统同时被激活时(即视觉+文字的双通道编码),信息的记忆和理解效率远高于单一通道。此外,认知科学中的「外部认知」(External Cognition)概念也为 Canvas 范式提供了理论支撑——通过将抽象信息外化为可视的空间布局,用户不再需要在工作记忆(Working Memory)中维持复杂的心智模型,而是可以直接在外部表征上进行操作和推理,从而将有限的认知资源释放给更高层次的决策任务。这也是 Canvas 这类可视化范式得以成立的认知科学基础。
GitHub Copilot App 中的 Canvas 功能,正是为了解决这一痛点而生。它不再是一个被动应答的聊天窗口,而是一块「可操作的智能画布」,让人和 AI 能够在同一个可视化空间里协同工作。Canvas(画布)这一交互范式并非 GitHub 首创,它的设计理念可以追溯到 Miro、FigJam 等协作白板工具,以及 Notion Canvas、OpenAI 的 ChatGPT Canvas 等近期产品。核心思想是将二维空间作为信息组织的基底,利用人类视觉系统天然擅长的空间认知能力来降低信息处理成本。在 AI 领域,Canvas 范式的独特之处在于引入了「AI 即协作者」的概念——AI 不仅生成内容,还能在同一空间中与用户实时交互式地修改和迭代内容。
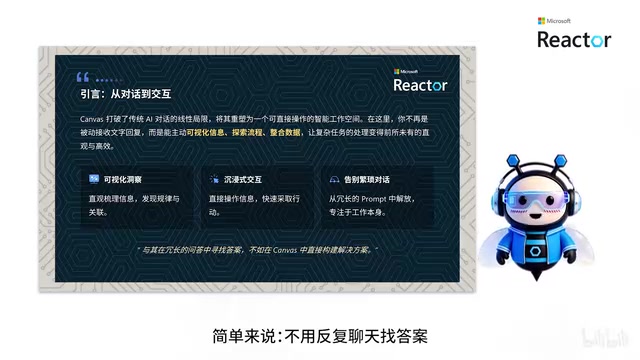
据 B 站 UP 主「小二课堂」的演示,Canvas 相比传统对话式 AI 有三大核心优势:
- 可视化展示数据:方便梳理信息、发现规律,而非在长长的文本流中来回翻找;
- 支持点击拖拽的沉浸式交互:本地操作即时生效,交互体验更直接;
- 降低 Prompt 负担:不用写大段复杂的提示词,把精力真正放在工作本身。
用一句话概括,就是「不用反复聊天找答案,直接在画布上打出完整解决方案」。
Canvas 是什么,如何创建
Canvas 是 GitHub Copilot App 内置的实时协作界面,其底层能力完全由 GitHub Copilot 提供支撑。它把单纯的文字对话,升级为「人和 AI 一起共创」的工作空间。
GitHub Copilot App 是 GitHub 推出的独立 AI 开发助手应用,区别于嵌入 IDE 的 Copilot 插件。目前 GitHub Copilot 存在多种产品形态:嵌入 VS Code 和 JetBrains 等 IDE 的代码补全插件、GitHub.com 上的 Copilot Chat、以及独立运行的 Copilot App。IDE 插件聚焦于编码时的实时补全和内联聊天,而 Copilot App 则定位为更广泛的开发工作流助手,能够跳出代码编辑器的边界,处理项目管理、文档协作和团队沟通等任务。从产品层级来看,GitHub Copilot 提供了三个订阅层次:面向个人开发者的 Copilot Individual、面向团队的 Copilot Business(增加了组织级管理和策略控制),以及面向大型企业的 Copilot Enterprise(集成了企业级知识库索引和更严格的安全合规能力)。其底层模型经历了从 OpenAI Codex(基于 GPT-3 微调的代码专用模型)到 GPT-4,再到当前多模型路由策略(根据任务类型动态选择最优模型)的演进过程。在数据获取层面,Copilot 采用了 RAG(Retrieval-Augmented Generation,检索增强生成)机制——在响应用户查询前,先从相关代码库、文档或数据源中检索相关片段,将其作为上下文注入给 LLM,从而使生成结果具备实时性和领域特异性,避免了纯参数化记忆的局限。同时通过 GitHub 的 API 生态系统(包括 REST API 和 GraphQL API)实现与仓库、Issues、Pull Requests 等 GitHub 原生功能的深度集成。Canvas 功能正是建立在这一基础设施之上,利用了 App 形态的独立渲染空间,不受 IDE 界面布局的限制,它能够通过 RAG 管道调用 GitHub 平台的数据源,并借助 Copilot 的推理能力将数据转化为可视化、可交互的界面组件。
三大核心特性
实时协作:你可以和 Copilot 同时编辑同一块画布,双方的操作彼此可见。
双向交互:本地操作实时生效,而复杂的计算与处理任务则交给 AI 在后台完成,各司其职。
持续迭代:画布生成后并非一次性产物,你可以随时下达指令让 AI 继续优化和调整。
一键生成 Canvas 的方法
创建方式非常简单:在对话框中输入斜杠命令 /Create Canvas,再描述你的需求,即可一键生成一块专属画布。这种低门槛的入口,让 Canvas 的能力可以被快速调用到各种实际场景中。
五个实战案例:Canvas 的能力边界
光谈概念不够直观,视频中给出了五个「落地可用」的实战案例,展示了 Canvas 在不同工作流中的应用潜力。
案例一:Issue 卡片式分类
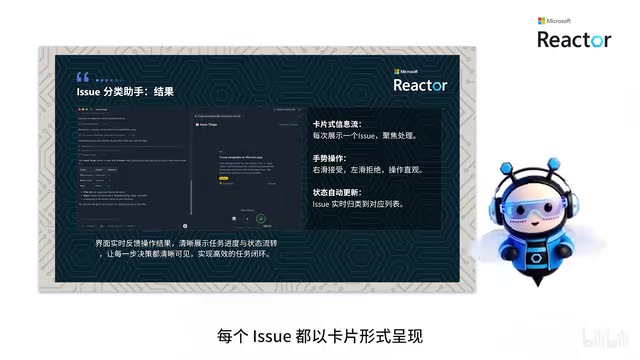
目标是快速整理 GitHub 上的 issues。通过一段简单的 Prompt,Canvas 会创建一个卡片式界面:一次只展示一条 issue,你可以像刷卡片一样,右滑接受、左滑拒绝,Canvas 会自动处理并更新状态。相比在长列表中逐个点击,这种交互方式的处理效率明显更高。
这种左滑/右滑交互借鉴了 Tinder 等应用普及的卡片式 UI 模式(Card-based UI)。该设计遵循了认知心理学中的「渐进式披露」(Progressive Disclosure)原则:每次只呈现一条信息,迫使用户做出明确的二元决策(接受/拒绝),从而避免了在长列表中产生的「决策疲劳」(Decision Fatigue)。决策疲劳是行为经济学中的经典概念,由心理学家 Roy Baumeister 提出,指个体在连续做出大量决策后判断质量会显著下降。在软件工程场景中,面对数十甚至数百个 Issues 时,开发者在传统列表视图中逐个阅读和标记的过程会迅速消耗认知资源。卡片式交互通过强制单任务聚焦和二元选择,将每次决策的认知开销降到最低,这也是这种模式在内容推荐(如 Tinder、小红书)和任务管理(如 Trello)中被广泛采用的原因。在 Issue 分类场景中,传统方式需要在 GitHub Issues 页面逐个打开、阅读、标记,而卡片式界面将这一流程压缩为直觉性的手势操作,认知成本大幅降低。
案例二:交互式代码库架构图
理解复杂项目的结构和组件关系往往令人头疼。Canvas 可以生成一张彩色、可交互的架构图,直观呈现各部分代码如何协同工作。这张图不仅色彩丰富,还支持放大缩小、拖拽节点、筛选特定部分,让开发者能深入探索代码的每一个细节,大幅降低了理解陌生代码库的门槛。
生成交互式代码架构图涉及多个技术环节:首先是静态代码分析(Static Code Analysis),通过解析 AST(抽象语法树)提取模块间的依赖关系、继承层级和调用链路。AST 是编译原理中的核心数据结构,它将源代码的语法结构表示为一棵树,每个节点对应一个语法构造(如函数声明、变量赋值、条件分支)。在实际工具链中,Tree-sitter 是目前最广泛使用的增量解析器之一——它的核心优势在于支持增量解析(Incremental Parsing),即当源代码仅发生局部修改时,Tree-sitter 不需要重新解析整个文件,而只需更新受影响的 AST 子树,这使得它能在毫秒级别完成大型文件的重新解析,非常适合 IDE 实时语法高亮和代码分析场景。此外,Language Server Protocol(LSP)在代码分析链路中也扮演着关键角色——LSP 是微软在 2016 年提出的标准化协议,它定义了编辑器与语言服务器之间的通信接口,使得「跳转到定义」「查找所有引用」「符号搜索」等功能可以跨编辑器复用。Copilot 在分析代码库结构时,很可能借助了类似 LSP 的语义分析能力来获取精确的模块依赖信息。在同类工具生态中,Sourcegraph 通过代码智能搜索和跨仓库导航提供类似能力,CodeSee 则专注于自动生成和维护代码地图(Code Maps),而 Canvas 的差异化优势在于将 AI 推理与可视化深度结合——不仅展示已有的结构关系,还能通过 LLM 推断隐含的架构模式和潜在问题。其次是图布局算法(Graph Layout Algorithm),如力导向布局(Force-directed Layout)或层级布局(Hierarchical Layout),将抽象的依赖关系映射为直观的空间拓扑。力导向布局算法最早由 Fruchterman 和 Reingold 于 1991 年提出,其核心思想是将图中的节点视为带电粒子(互相排斥),边视为弹簧(相连节点互相吸引),通过模拟物理系统达到平衡状态,从而自动生成美观的图形布局。最后是前端交互层,通常基于 D3.js、Mermaid 或类似的可视化库实现缩放、拖拽和筛选功能。Copilot 在此过程中承担了从代码到结构化数据的转换工作,而 Canvas 则负责将数据渲染为可操作的图形界面。
案例三:Sessions Worktree 视图
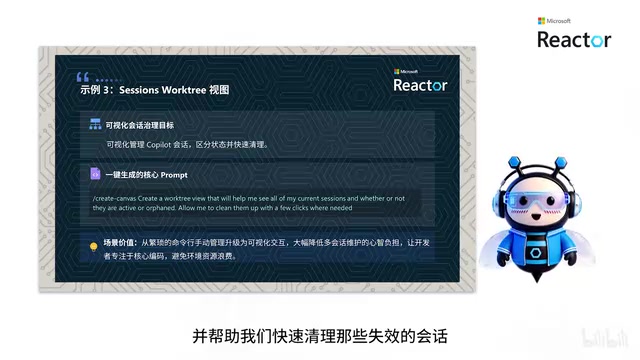
经常使用 Copilot 的人容易开出大量会话,管理起来颇为混乱。这个 Canvas 的目标是可视化所有会话,清晰标注哪些处于活跃状态、哪些已经孤立失效。对于不再需要的会话,只需点击一个按钮即可清理,显著提升了工作空间的整洁度。
在持续使用 AI 编程助手的过程中,会话(Session)数量膨胀是一个普遍痛点。每个会话都携带独立的上下文状态,包括对话历史、引用的文件和生成的代码片段。当会话数量达到数十甚至上百个时,开发者很难记住每个会话的用途和状态。「Worktree 视图」这一命名借用了 Git Worktree 的概念——Git Worktree 是 Git 2.5 版本引入的功能,允许在同一仓库中同时检出多个工作目录,使开发者可以在不同分支上并行工作而无需频繁切换。Sessions Worktree 则类似地将多个 AI 会话以树状结构可视化呈现,帮助用户识别会话间的分支关系和活跃程度,快速定位需要继续的工作线程或清理已废弃的会话。
案例四:Agent Prompt 教练
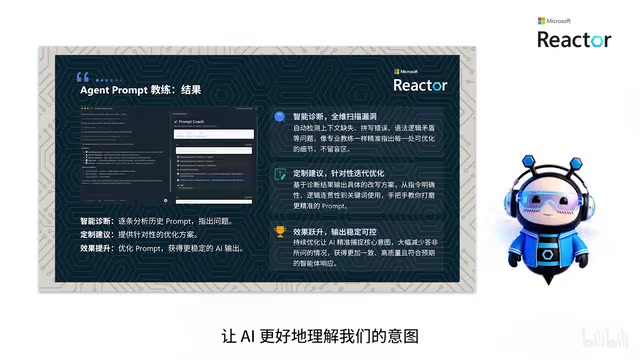
写出更有效的 Prompt 是每个 AI 用户的追求。这个 Canvas 会分析你的历史对话,找出诸如语法错误、上下文缺失等可改进之处,并给出具体建议。它就像一位随身的 Prompt 教练,帮助你不断优化与 AI 的交互技巧,让 AI 更准确地理解你的意图。
Prompt Engineering(提示词工程)已经发展为一门独立的实践学科,其核心挑战在于如何用精确的自然语言描述来引导 LLM 产出高质量结果。这一领域的方法论经历了快速演进:从最初的零样本提示(Zero-shot),到少样本提示(Few-shot,由 GPT-3 论文推广),再到思维链提示(Chain-of-Thought,由 Google Brain 的 Jason Wei 等人在 2022 年提出),以及后来的思维树(Tree-of-Thought)和 ReAct(Reasoning + Acting)等高级范式。近年来,Prompt 工程进一步向自动化和系统化方向发展:斯坦福大学的 DSPy 框架提出了「编程而非提示」的理念,允许开发者用声明式语法定义 LLM 管道中的各个模块(如检索、推理、生成),框架自动搜索最优的 Prompt 策略和少样本示例,将手工调试 Prompt 的过程转化为可优化的计算问题。Anthropic 提出的 Constitutional AI(宪法 AI)则从另一个角度影响了 Prompt 设计——通过在 Prompt 中嵌入明确的行为准则和自我批评机制,引导模型进行自我审视和修正,这一思路也被广泛应用于提升 Prompt 的鲁棒性和安全性。一个好的 Prompt 通常包含四个关键要素:角色设定(Role)、任务描述(Task)、输出格式约束(Format)和示例(Examples)。案例四中的「Agent Prompt 教练」本质上是一个元学习(Meta-learning)应用——它分析用户的 Prompt 模式,识别常见问题(如指令模糊、缺少约束条件、上下文断裂),并基于最佳实践给出改进建议,形成持续优化的反馈闭环。这意味着用户在使用 Canvas 的过程中,不仅完成了当前任务,还在同步提升自身与 AI 协作的能力。
案例五:Knowledge Finder 知识查找器
在大型团队中,找到对某个文件或主题最了解的人常常很困难。Knowledge Finder 通过跨平台搜索,整合来自 Slack、Teams、邮件等多个渠道的信息,清晰列出最相关的人员及其关联信息,极大简化了知识查找和人员沟通的流程。
Knowledge Finder 的技术实现涉及企业知识图谱(Enterprise Knowledge Graph)的构建。在大型组织中,知识分散在 Slack 消息、Teams 频道、邮件线程、Confluence 文档、GitHub 提交记录等多个数据孤岛中。跨平台搜索需要首先通过各平台的 API 采集数据——在微软生态中,Microsoft Graph API 扮演着统一数据聚合层的角色,它提供了一个单一的 RESTful 端点来访问 Microsoft 365 套件中的用户资料、邮件、日历、Teams 消息、OneDrive 文件等多种数据资源,使得跨应用的数据查询不再需要逐个对接各产品的独立 API。在数据采集之后,系统利用 NLP 技术(如命名实体识别和关系抽取)建立人员-主题-文件之间的关联网络。语义搜索环节通常依赖向量数据库(Vector Database),如 Pinecone、Weaviate 或 Chroma,它们将文本通过嵌入模型(Embedding Model)转化为高维向量,然后通过近似最近邻搜索(ANN)实现基于语义相似度而非关键词匹配的检索。结合 RAG(检索增强生成)架构,系统在用户发起查询时先从向量数据库中检索最相关的文档片段,再将其注入 LLM 的上下文中生成结构化的回答。这一过程本质上是在解决组织中「隐性知识」(Tacit Knowledge)的发现问题——隐性知识的概念由哲学家 Michael Polanyi 提出,后被野中郁次郎引入组织管理领域,指那些难以用文字直接记录、存在于个人经验和实践中的知识。在软件开发团队中,某位工程师对特定模块的深入理解、某次故障排查的经验、某个架构决策的历史背景,这些关键知识往往分散在即时通讯记录、代码注释和口头交流中,难以被传统搜索引擎索引。最终呈现时,系统会根据贡献频率、最近活跃时间和专业匹配度等维度对相关人员进行排序,将组织的集体智慧变得可查询、可追溯,解决了「知道答案的人在哪里」这一长期困扰大型团队的协作难题。
Canvas 的意义与未来展望
纵观这五个案例,可以发现 Canvas 的能力并不局限于代码本身,而是延伸到了 issue 管理、会话治理、Prompt 优化、团队知识协作等更广泛的工程实践场景。
Canvas 的核心价值,在于它将 AI 从一个被动的对话工具,转变为一个主动的、可视化的协作伙伴。这种角色转变意味着开发者可以用更直观、更高效的方式处理信息和完成任务,而不必被困在纯文本的问答循环里。从更宏观的视角来看,这一趋势反映了人机交互(HCI)领域的一个重要方向:从命令行到图形界面再到对话式 AI,每一次交互范式的跃迁都在降低用户表达意图的成本。Canvas 代表的可视化协作范式,可能是对话式 AI 之后的下一个自然演进——它兼具了对话的灵活性和图形界面的直观性。值得注意的是,这一趋势并非 GitHub 的独立行动:Anthropic 推出了 Artifacts 功能,让 Claude 能够在对话旁边生成可运行的代码、文档和可视化内容;Cursor 和 Windsurf 等新一代 AI 编辑器正在探索「AI 原生 IDE」的产品形态,将 AI 能力深度整合到编码工作流的每一个环节;而 Google 的 Project IDX 则尝试在云端开发环境中嵌入 Gemini 的多模态理解能力。这些产品共同指向一个方向:下一代开发工具不再区分「写代码」和「与 AI 对话」,两者将融合为统一的、可视化的协作体验。
有意思的是,当前展示的仍只是一个起点。随着可视化协作范式的成熟,Canvas 这类工具或将重新定义我们与 AI 协作的方式——从「向 AI 提问」进化为「与 AI 共建」。对于感兴趣的开发者,现在就可以在 GitHub Copilot App 中亲自体验这一功能。
核心要点
核心要点
核心要点
相关推荐

空陆两栖变形无人机:除了省电100倍,还有什么真需求?
空陆两栖变形无人机是否只是噱头?从M4 Morphobot的100倍功耗差异出发,探讨变形无人机的真实应用场景与论文选题思路,分析纯无人机和纯地面机器人均失效的边界条件。

Warhound融资2亿美元:基因工程“战犬”搭配Anduril装备
Warhound完成2亿美元融资,由Ben Lamm和Palmer Luckey推动,通过基因工程改造犬类用于军事和执法,并搭配Anduril装备。本文分析其技术方向、融资逻辑与伦理争议。

Claude API登陆Google Cloud:IAM集成与SDK接入指南
Anthropic将完整Claude API托管在Google Cloud上,通过Google Cloud IAM控制权限并统一计费。本文梳理Vertex AI与Anthropic托管两个服务入口、IAM角色配置要点及SDK接入方式,帮助企业复用现有云治理框架引入Claude模型。