GitHub Copilot接入Claude Opus 4.8快模式:AI编程工具开始卷响应速度

AI编程的下一个战场:不是更聪明,而是更快
GitHub Copilot近期的一次更新,可能标志着AI编程工具竞争逻辑的一次重要转向。据B站UP主「AI变化观察」分享,GitHub Copilot已将Claude Opus 4.8 Fast Mode(快模式)正式纳入预览通道。这次更新的核心,不在于换个名字蹭热度,而是把AI编程中最令人抓狂的环节——等待时间——单独拎出来,作为一项独立能力去打磨。
官方更新说明写得相当直接:Fast Mode在保持与Opus 4.8同等智能水平的前提下,Token输出速度明显更快,更适合交互式编码和Agent工作流场景。
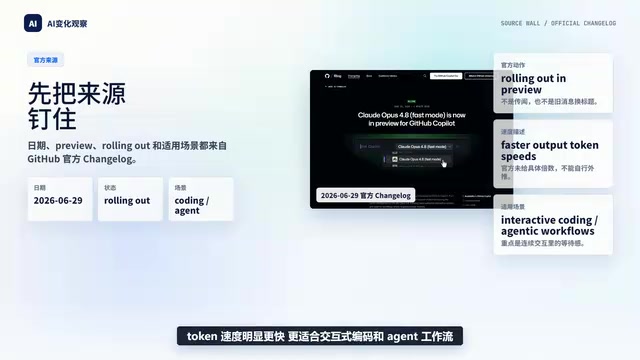
理解Token速度:大语言模型的响应延迟由两部分构成:首Token延迟(Time to First Token,TTFT)和Token生成速率(Tokens per Second,TPS)。Fast Mode的核心优化方向正是后者——在不显著降低模型推理质量的前提下,通过模型蒸馏(Knowledge Distillation,一种将大型模型「知识」迁移至更小模型的技术,让小模型模仿大模型的输出分布而非直接学习原始标签)、量化压缩(将模型权重从FP32等高精度浮点数压缩为INT8/INT4等低精度格式,大幅降低内存占用与计算量)或专用推理硬件调度等技术手段,大幅提升每秒输出的Token数量。对于交互式编程场景,TTFT决定了「点击后多久出现第一个字」,而TPS决定了「代码块是流畅滚动还是一顿一顿」。两者共同构成开发者所感知的「手感」。研究表明,用户对交互系统的感知「流畅」阈值约为100-200毫秒,超过1秒即产生明显等待感,超过10秒则会导致注意力切换与任务中断。
简单来说:当你让Copilot改代码、解释报错、执行Agent任务时,关键不仅仅是「它答得对不对」,还有「每一步是不是像在慢慢泡茶」。对于高频交互的编程场景,响应延迟带来的心理摩擦,有时比模型能力本身更影响实际体验。
尤其在Agent工作流(Agentic Workflow)场景下,这一问题被进一步放大。Agent模式脱胎于ReAct、AutoGPT等框架的普及,其本质是将LLM从「单次问答」升级为「持续决策循环」——AI模型以自主循环方式执行多步任务,持续地「感知→规划→执行→反馈」,而非只回答一次问题。在这种架构下,每一轮LLM调用的延迟会被串行叠加:若一个Agent任务需要调用模型10次,单次2秒的延迟便积累为20秒的总等待;而对于需要20步的复杂代码重构任务,总等待时间可能突破1分钟,远超开发者的心理容忍阈值。Fast Mode正是针对这类高频调用场景的专项优化。
覆盖范围广,但企业默认不开启
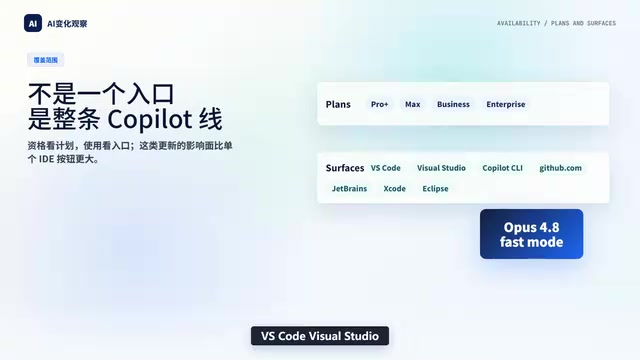
从支持范围来看,Fast Mode此次铺开面相当广泛。订阅层级涵盖Pro、Pro+、Business、Enterprise;接入入口则覆盖VS Code、Visual Studio、Copilot CLI、GitHub网站、JetBrains系列IDE、Xcode、Eclipse等几乎所有主流开发环境。
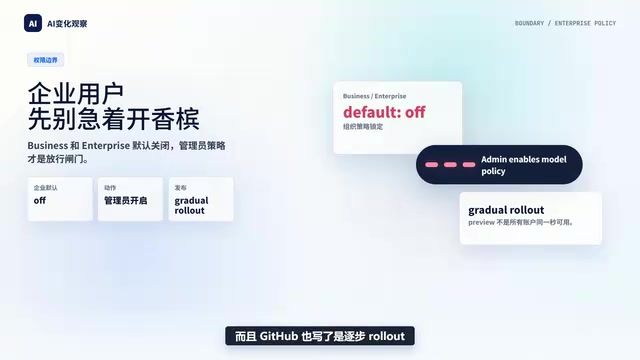
不过企业用户需要注意一个关键细节:Business和Enterprise版本默认关闭Fast Mode,需要管理员在Copilot设置中手动开启对应的模型策略。这一设计背后有三重企业级考量:合规风险(数据是否经过更多中间节点)、成本管控(高频调用快模式可能显著推高API账单)、以及模型一致性(不同速度档位的输出风格差异可能影响代码审计追溯)。
这与企业IT治理中的「最小权限原则」(Principle of Least Privilege,PoLP)一脉相承——该原则最早由Saltzer和Schroeder于1975年在操作系统安全论文中正式阐述,其核心要求是:任何系统主体仅应拥有完成当前任务所必需的最低权限,超出范围的能力默认不开放。将这一原则延伸至AI工具治理,意味着新模型能力、新数据通道均须经安全评估后由管理员显式授权,而非对所有用户默认开放。这不仅是合规要求,也是防范「影子AI」(未经审批的AI工具自发扩散使用)风险的有效手段。新能力默认不开启,需经评估后由管理员主动授权,而非让每位开发者自行决策,这恰好呼应了AI工具进入企业市场后一个绕不开的核心命题——可管理性。
逐步Rollout:快模式正成为长期分层标准
GitHub明确表示,Fast Mode采用逐步Rollout(分批推送)策略,并非一夜之间全量上线。如果你暂时没有看到该选项,属于正常现象。
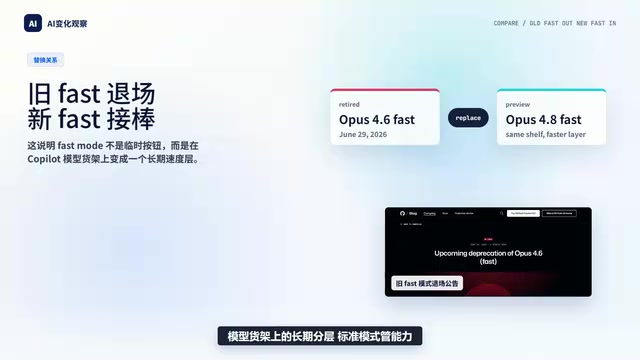
另一个值得关注的信号是:上一代Opus 4.6 Fast将逐步退场,GitHub建议用户直接迁移至Opus 4.8 Fast。这说明「Fast Mode」并非临时性的功能按钮,而是正在演变为Copilot模型体系中的长期分层标准。
未来Copilot的模型选择,很可能形成清晰的二维结构:
- 标准模式:主打能力上限,适合复杂、需要深度推理的任务;
- Fast Mode:主打响应速度,适合高频交互、Agent循环调用等场景。
用户的选择逻辑也随之升级:不再只是「选哪个模型」,而是「在同一个模型下,优先能力还是优先手感」。
定价:更便宜,但仍高于标准版
关于使用成本,官方未给出具体倍率或价格数字,仅说明:相比上一代,Fast Mode价格更低,但仍高于标准的Opus 4.8。
这个定位颇为微妙——它并非「更快且更省」的完美升级,而是一种明确的取舍:你为「更快的响应体验」支付了一定溢价。这也是AI工具将「速度」单独商品化的典型案例,而这一定价逻辑在云计算领域早有先例:AWS的预置容量实例(Provisioned Concurrency)与按需实例的差价,本质上是为「零冷启动延迟」单独定价;CDN服务商也长期将边缘节点响应时延作为不同套餐的核心差异项。AI推理市场正在复制这一结构——Anthropic、OpenAI均已推出响应速度不同的模型档位,价格梯度反映的不再只是参数规模,而是推理延迟的服务保障等级。这标志着AI服务从「按能力定价」向「按体验维度分层定价」的结构性演变。对于将Copilot深度嵌入日常工作流的开发者和团队而言,这笔账需要自行衡量:节省下来的等待时间,是否值得这部分额外成本。
趋势洞察:AI编程工具开始卷「开发者体验」
这则更新真正值得关注的,不在于Opus 4.8本身有多强,而在于它揭示了一个行业趋势——AI编程工具的竞争重心,正从「谁更聪明」转向「谁更好用」。
过去一两年,模型厂商的比拼几乎全集中在能力维度:代码通过率、推理深度、上下文长度。然而随着各家模型能力逐渐收敛,用户在真实使用中感受到的差距,越来越多来自「非能力」因素:响应够不够快、有没有明显等待感、定价是否合理、企业能否有效管控。
开发者体验(Developer Experience,DX)作为独立产品指标被系统化重视,可追溯至2010年代初Stripe重新定义支付API的方式——他们将「五分钟内完成首次集成」作为硬性产品目标,Twilio则以「发送第一条短信只需三行代码」复制了这一逻辑。他们证明了「文档好用、调试方便、响应够快」本身就是产品竞争力。DX的核心度量维度包括:首次成功调用耗时(Time to First Hello World)、错误信息的可操作性,以及响应延迟的感知流畅度。如今这一框架正被完整移植到AI工具评估体系中——模型能力的「天花板竞赛」逐渐饱和后,延迟、定价透明度、IDE集成深度这些「体验层」因素开始主导用户留存。GitHub将响应速度独立成可售卖的产品档位,本质上是将DX指标量化为明码标价的SKU。
正如「AI变化观察」在视频结尾的判断:以后评估模型更新,别只问谁更聪明,还要问它等不等人、贵不贵、企业能不能管得住。再强的能力,若每次都要卡上几秒钟,积累下来足够影响整体效率和使用意愿。
GitHub将「速度」独立成一个产品档位,本质上是在公开承认:开发者体验(Developer Experience,DX)已成为AI编程工具的核心竞争力之一。这对整个行业发出了一个清晰信号——AI工具正在从研究产品走向工程产品,接下来的竞争,将越来越多地在「手感」这个看不见却摸得着的维度上展开。
核心要点
相关推荐
Vibe Coding是什么?程序员必须掌握的AI编程能力
Vibe Coding(AI编程)到底是什么?本文解析AI编程如何重塑研发流程、为何传统程序员面临淘汰、Cursor与Claude Code两大工具,以及程序员、PM、运营等岗位为何都该掌握这项能力。
让石头思考:生成式AI与信息压缩的哲学思考
从Reddit热帖「让石头思考」出发,探讨生成式AI的信息论本质:为何压缩等价于理解,巴别图书馆式的可能性空间思辨,以及语义压缩、Hutter Prize与AI原理的深层联系。
让Claude"浪费"额度:一场AI创造力的意外实验
一位Reddit用户让Claude用剩余额度"做件荒唐的事",结果AI生成了监控一块石头的企业级平台RockOps。本文分析这一趣味案例背后的AI创造力与产品设计能力。