GitHub 再现重大故障:PR、Git 操作与 Issues 集体宕机
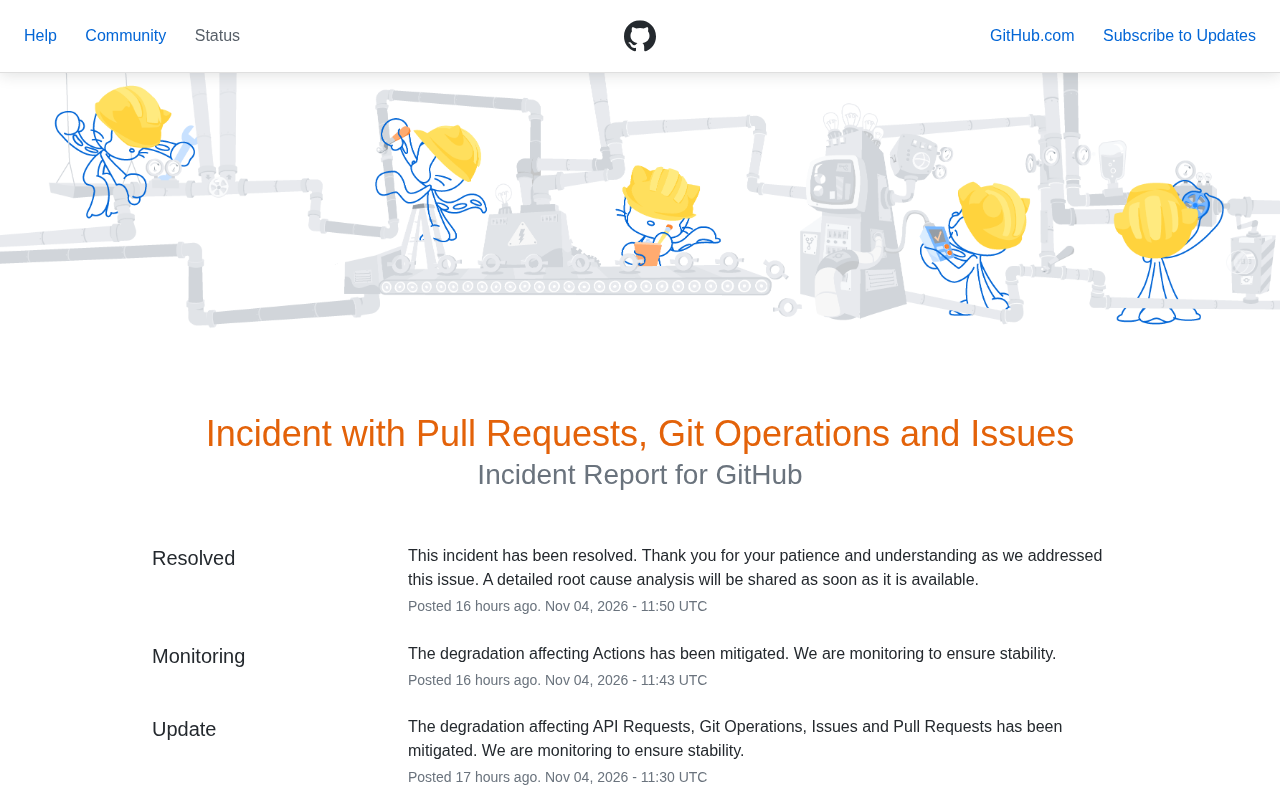
GitHub 三大核心服务同时故障,暴露集中化代码托管的系统性风险。
GitHub 的 Pull Requests、Git 操作与 Issues 三项核心服务同时出现异常,导致从代码提交、评审到任务追踪的完整协作链路受阻。事件在 Hacker News 获得 258 点热度与 129 条评论,反映出开发者社区对基础设施稳定性的高度关注。文章分析了三个环节同时故障的叠加效应:即使局部恢复,团队仍难以维持完整工作流。更深层的议题是集中化代码托管的系统性风险——平台可用性直接等价于依赖组织的研发效率。文章建议工程团队通过确认远端状态、保留镜像推送路径、启用备用任务追踪等方式缩短故障对交付的实际影响,并指出状态页的信息局限使企业需自行判断是否启动应急预案。
一次牵动全球开发者的宕机
GitHub 再次因稳定性问题成为开发者社区的焦点。据 GitHub 官方状态页面发布的事件通告,其核心服务——Pull Requests、Git 操作与 Issues——同时出现异常,导致大量开发者的日常协作流程被迫中断。该事件在 Hacker News 上迅速引发讨论,相关帖子获得 258 点热度与 129 条评论,足见其对开发者工作流的实际冲击。
从故障范围看,此次受影响的功能并非边缘模块,而是 GitHub 协作模型中最基础的三个环节:代码提交与拉取(Git 操作)、代码评审(Pull Requests)以及任务追踪(Issues)。三者同时异常,意味着从写代码、提交代码到评审合并的整条链路都可能受阻。对于依赖 GitHub 作为唯一代码托管与协作平台的团队而言,这种级别的故障几乎等同于工作流停摆。
故障影响:不止是“不能用”那么简单
开发者工作流的连锁反应
Git 操作异常直接切断了本地与远端仓库的同步通道。开发者无法推送新提交、拉取他人更新,也无法克隆仓库,这会让并行开发中的分支管理陷入混乱。Pull Requests 不可用则阻断了代码评审与合并流程,团队不得不暂停发布或临时改用其他方式审阅代码。Issues 故障影响的是任务分配与缺陷追踪,在敏捷开发节奏下,这会让团队失去对当前工作状态的可见性。
三个环节同时故障的叠加效应值得关注:即使 Git 操作短暂恢复,若 PR 与 Issues 仍不可用,团队依然无法完成完整的“提交—评审—合并—追踪”闭环。这种耦合性放大了单点故障的影响半径。
Git 操作与 Pull Request 的依赖关系
Git 是一个分布式版本控制系统,其“分布式”特性意味着每位开发者的本地机器上保存着完整的仓库历史。理论上,本地提交、分支切换和查看历史都不依赖远端服务器。但现代团队协作模式实际上高度依赖一个中心化的远端仓库(如 GitHub 上的 origin)。git push 和 git fetch 需要与远端通信,而 Pull Request 则是建立在远端仓库之上的评审机制——它本质上是请求将某个分支合并到目标分支。因此,Git 操作异常切断了本地与远端的同步,PR 评审也随之停滞;即便 PR 页面本身可用,没有新的提交推送上去,评审也无从谈起。这种依赖关系解释了为什么三个服务的故障会形成叠加效应。
社区反应与讨论热度
Hacker News 上 129 条评论的讨论量表明,开发者对 GitHub 稳定性的关注已超出单纯的技术好奇。评论中常见的情绪包括对单一平台依赖的担忧、对故障期间工作安排的实际讨论,以及对 GitHub 官方沟通透明度的审视。258 点的热度在技术社区中属于中高关注水平,反映出此类基础设施故障的公共性——它不只是 GitHub 一家公司的问题,而是整个依赖其服务的开发生态的共同事件。
Hacker News 的热度机制
Hacker News 是 Y Combinator 运营的技术社区,其内容排序并非简单的点赞数,而是基于投票、时间衰减和评论活跃度的综合算法。帖子获得 258 点热度,意味着在短时间内有大量用户主动投票,通常反映出话题与社区成员的核心利益高度相关。129 条评论则说明讨论深度较高,因为评论数往往比投票数更能体现争议性或共鸣程度。对于基础设施类故障,Hacker News 的讨论常常超越事件本身,延伸到架构设计、供应商锁定和运维文化等更广泛的议题,这也是此类帖子容易获得中高关注度的原因。
从状态页到工程实践:稳定性为何反复成为议题
GitHub 通过状态页面对外通报事件,这本身是运维透明化的一环。但状态页能提供的信息通常限于“哪些功能受影响、当前处于什么阶段”,对于根因分析、影响范围量化以及预防措施,往往需要等待事后复盘。对于企业用户而言,这种信息节奏意味着在故障发生期间,团队需要自行判断是否启动应急预案。
更值得思考的是集中化代码托管的系统性风险。当大量组织将代码、评审记录与任务数据全部托管于同一平台时,该平台的可用性就直接等价于这些组织的研发效率。此次 PR、Git 操作与 Issues 同时故障,恰好演示了这种集中依赖的脆弱面:不是某一个工具出问题,而是协作链条上的多个关键节点同时失效。
对于工程团队,可行的应对思路包括:在关键发布窗口前确认远端仓库的可用状态、为紧急修复保留本地或镜像仓库的推送路径、以及在协作平台不可用时启用备用的任务追踪方式。这些措施无法阻止平台故障,但能缩短故障对交付节奏的实际影响。
状态页的局限与事后复盘(Postmortem)
状态页(Status Page)是 SaaS 服务对外沟通可用性的标准工具,通常以红黄绿标识各功能组件的健康状态,并发布事件时间线。然而,状态页的设计目标是“告知当前状态”,而非“解释原因”。在故障进行中,工程团队往往还在定位问题,无法立即给出根因;状态页只能反映“已知的影响范围”。事后复盘(Postmortem)则是在事件结束后发布的详细报告,通常包含时间线、根因分析、影响量化和改进措施。成熟的工程组织会将复盘公开化,但复盘存在滞后性,这意味着依赖平台的企业在故障当下只能依据有限信息自行决策,无法等待官方给出完整解释。
集中化托管的系统性风险与降级方案
集中化代码托管将代码、评审记录、任务追踪和 CI/CD 触发器等研发资产集中于单一平台,带来协作效率的同时也引入了系统性风险。当平台不可用时,依赖其 API 和 Webhook 的自动化流水线会同步失效,影响范围远超“不能访问网页”。工程团队常用的缓解手段包括:维护一个只读镜像仓库(如通过定时 git clone --mirror 同步到自建 Git 服务),确保紧急修复时仍有推送路径;将关键发布流程与平台状态解耦,例如在发布检查清单中加入“确认远端仓库可用”步骤;以及准备备用的任务追踪方式(如共享文档或本地看板),避免 Issues 故障导致工作完全失去可见性。这些措施属于业务连续性规划(BCP)的一部分,目标不是消除故障,而是控制故障的影响时长。
写在最后
此次 GitHub 故障的具体根因与修复细节,仍需以官方后续通告为准。但从事件本身可以确认一点:现代软件开发对协作平台的依赖已经深到无法忽视其稳定性的程度。PR、Git 操作与 Issues 三者同时异常,不是一个孤立的运维事故,而是对“把工作流押注在单一平台上”这一普遍实践的一次提醒。对开发者而言,关注状态页、理解自身工作流中的单点依赖、并准备轻量级的降级方案,是比等待下一次故障更有价值的动作。
相关推荐
七年蜕变:初代折叠屏与现在差距有多大
从初代折叠屏到最新产品,七年时间带来了哪些改变?折痕变浅、亮度提升、机身更薄、软件迁移更顺畅,折叠屏是否已经跨越从发烧友到普通用户的鸿沟?本文基于视频对比分析展开讨论。
人类何时开始吃盐?一段跨越万年的盐史
人类何时开始吃盐?从11000年前农业兴起时的加盐实践,到古代海水蒸发、岩盐开采,再到盐贸易、盐税与甘地食盐长征,本文梳理盐在人类文明中的关键角色。
微软Paza研究:非洲语言语音识别如何突破架构与数据瓶颈
微软Paza研究系统评估53个语音模型在39种非洲语言上的表现,揭示架构选择比预训练覆盖更关键、200-300小时为实用数据门槛,以及语言类型学对识别性能的深层影响。