GitHub爆款:让Claude Code获得无限上下文的代理方案
Billion Context 用可逆压缩代理让长会话不再溢出,省钱且性能不降。
Billion Context 是一个部署在 agent 与模型 API 之间的小型代理服务器,通过 compress、decompress、search context、acp status 四个工具,把「何时压缩、压缩什么」的决定权交给模型本身。它采用逐步、可逆的压缩方式,避免破坏 prompt cache,使缓存命中率可达 95%-97%,压缩成本仅约 2%。作者四个月半的实测显示,17.4 万次调用、187.6 亿输入 token 下零次上下文溢出;Context Bench 中 F1 为 0.31 略高于 full context 的 0.29,成本降低 58%。代价是逐字复现能力下降,needle in a haystack 从 69% 降至 27%。项目支持 Anthropic 与 OpenAI 风格接口,可作为 Claude Code、OpenCode 等客户端的插件使用。
引言:当长会话撞上上下文墙
运行长时间AI编程会话时,最令人头疼的莫过于上下文窗口被塞满,导致历史记录被截断、代理性能骤降。GitHub上一个名为Billion Context的项目正试图解决这一痛点。据B站UP主介绍,该项目在不到三个月内斩获约3700个star和300个fork,其核心思路是用每月一次的session将数十亿token通过一个context window处理掉——这个窗口一次能装下十万个token,从而把token开销降到原来的五分之一。
更关键的是,它并非简单截断,而是让模型自主决定何时压缩、压缩什么,并保持压缩内容可逆。这种设计让Claude Code、DeepSeek广告等模型在长时间运行中不再“失忆”,同时大幅降低成本。
工作原理:可逆压缩与缓存保护
Billion Context本质上是一个很小的代理服务器,加载在你的agent和模型API之间。你把agent的base URL指向这个代理后,每个请求都会经过它。代理会读取对话,把已经执行过的部分压缩掉,再转发给真正的模型。它支持Anthropic和OpenAI风格的API,因此几乎适用于任何agent。
四个工具赋予模型自主权
最有意思的是它的压缩机制。它没有在某个长度上粗暴截断,而是给模型提供了四个新工具:
- compress:将一段消息压缩成详细摘要
- decompress:在需要精确细节时,将这段内容还原回来
- search context:在所有已压缩内容里做关键词搜索
- acp status:显示上下文已经用了多少、还能再压缩多少
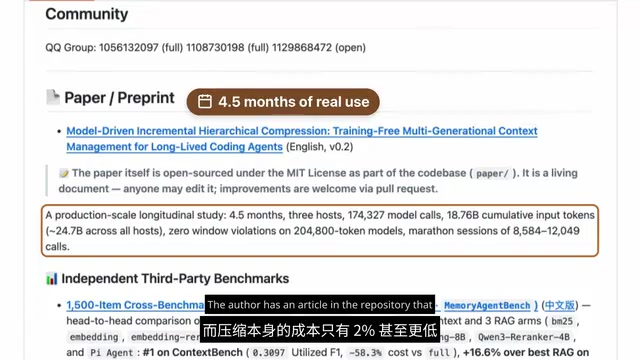
何时压缩、压缩什么,全部由模型自己决定。这与agent自带的summarizer不同:压缩是逐步进行的,只处理小范围内容,而非一次性泛化所有历史;同时压缩是可逆的,所有内容都能解压回来,从而保住prompt cache。据称,一个健康的session缓存命中率能达到95%到97%,而压缩本身的成本只有2%甚至更低。
Prompt cache(提示缓存) 是理解 Billion Context 经济性的关键。主流大模型 API 会把请求前缀(system prompt、历史对话等)的 KV 计算结果缓存在服务端,当后续请求共享同一前缀时可以直接复用,从而按远低于常规输入 token 的价格计费(通常为原价的 10% 左右)。因此「缓存命中率」直接决定了长会话的边际成本。Billion Context 之所以坚持可逆压缩、逐步压缩,正是为了避免改动对话前缀结构——一旦前缀变化,缓存即失效,全部历史都要按全价重新计算。它把压缩结果作为新内容追加而非重写历史,使缓存前缀尽可能保持稳定,这也是 95%-97% 命中率能够成立的前提。
Agent 自带的 summarizer(摘要器) 通常是触发式的:当上下文接近窗口上限时,把较早的消息整体概括成一段文本并丢弃原文。这种做法有两个固有缺陷:一是摘要是一次性、不可逆的,细节永久丢失;二是重写历史会破坏 prompt cache 前缀。Billion Context 的差异在于把压缩从「被动兜底」变成「模型主动调用的工具」——模型可以只压缩一段已完成的工具调用结果,保留其余部分原样,压缩粒度更细,且原文以可检索、可解压的形式留存。换言之,前者是上下文管理策略,后者是把上下文管理变成 agent 可自主规划的动作。
实测数据:省钱且性能不降
项目作者在仓库里放了一篇文章,介绍了四个半月的真实使用情况:17万4千次模型调用,187.6亿个输入token,在20万token模型上零次context window overflow。
第三方基准测试进一步验证了其价值。在Context Bench测试中,coding agent需要探索真实仓库,Billion Context拿到第一,F1为0.31,超过full context的0.29;成本从11.05美元降到461美元,便宜了58%,表现还更好一点。在Long Memo Well测试里,它的得分是79.2%,而full context是83.2%,表现最好的reg设置是62.6%,但成本低了71%。
有意思的是,在needle in a haystack测试中,要求找回一句完全准确的话,结果从69%降到了27%。摘要能保留意思但不会逐字照搬,对编码agent来说这通常是个合适的折中,但你需要知道这一点。
Context Bench 是评估编码 agent 在真实代码仓库中定位、修改与验证能力的基准,常用 F1 衡量其检索与作答的准确性;Long Memo Well 侧重长程记忆的保持与调用;needle in a haystack(大海捞针) 则要求在大量无关文本中逐字找回指定句子。三者的考察重点不同:前两者关注「意思是否保住」,后者关注「原文是否逐字保留」。这解释了为何 Billion Context 在前两项接近甚至反超 full context,而在逐字召回上明显下滑——摘要保留语义但会改写措辞,属于压缩的必然代价,而非实现缺陷。
配置与生态:与Claude Code无缝集成
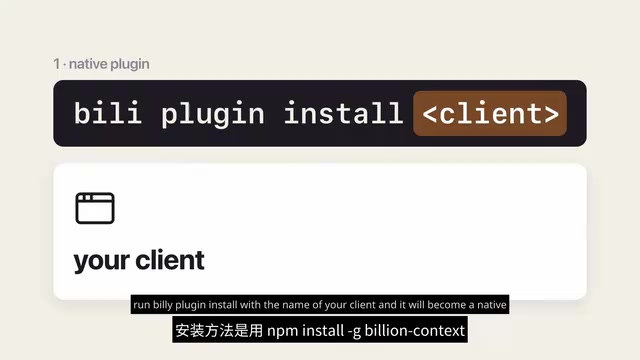
安装方法是用npm install -g billion-context接上你的本地文件夹,这样就会得到一个叫billion的命令。它有三种用法:
- 运行
billion plugin install带上你的client名称,它就会变成Claude Code、OpenCode等客户端的原生插件。 - 在client名后面直接运行
billion,比如billion claude或billion codex,这样会通过代理运行这个client,且不会改动你的配置。 - 直接运行
billion,然后把代理地址填在base URL前面。
你可以用到DeepSeek V4 Flash、Claude 3.1 Pro、GLM-5.3、Qwen 3.8 Max、Minimax M3.1 Flash等模型,查询额度比平时高2-5倍,只需在client控制台创建一个API key。
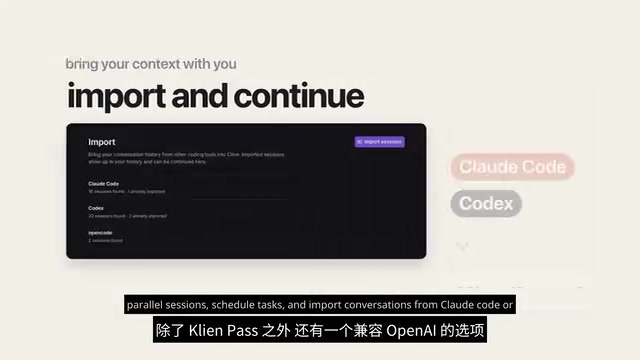
Billion Context的client仓库将其列为一个经过验证的客户端,基于OpenAI兼容接口。你只需用OpenAI的base URL来完成这个用途,这在客户端的桌面版里也应该能用。桌面版是独立应用版的client agent,很适合跑长时间任务——你可以并行开多个会话、安排任务,还能从Claude Code或Codex导入对话接着继续。在桌面版的provider列表里,除了client path之外还有一个兼容OpenAI的选项,用同一个base URL、同一个key、同一个model即可。
为什么这个组合说得通?Claude Code给你的是固定价格,但它有5小时窗口、每周限额和每月限额,而长会话会因为每一步都要重新发送历史记录很快把这些限制用完。Billion Context缩短了这个过程,所以同一个套餐能用的久很多。
一切跑通后,在浏览器打开localhost 8787,你会看到一个控制面板:会话列表、实时日志、配置编辑器。在支持的客户端里输入/acp cache,你会拿到一份报告,里面有缓存命中率、节省了多少token,以及如果发生了缓存清理还会给出原因。
Base URL 代理 是一种对客户端零侵入的接入方式:大多数兼容 OpenAI 或 Anthropic 接口的客户端都允许自定义 API 端点,把地址指向本地代理(如 localhost:8787),请求便会先经过代理再发往真实服务,客户端本身无需修改代码或配置逻辑。这使得 Billion Context 能以「中间人」身份适用于几乎任何 agent,代价是需要客户端支持自定义端点,且部分内置于桌面应用的标签页可能硬编码端点而绕过代理——这正是文中提到 Claude 桌面应用 code 标签页无法享受压缩的原因。
局限与注意事项
Billion Context并非万能。首先,项目发展非常快,目前还是0.121版本,会自动更新master分支,随时可能出问题,最好从npm安装正式版。其次,如果你在自己的网络里用host选项运行,认证是完全没有的,只能在你信任的网络里这么做。第三,Claude桌面应用里的code标签页会绕过代理,所以那里没有压缩。第四,复现准确度会下降——如果需要精确还原过去的一行代码,模型就得把它重新展开。文档非常庞大也很技术化,设置起来比较麻烦,需要时间学习。
与编排工具的协同
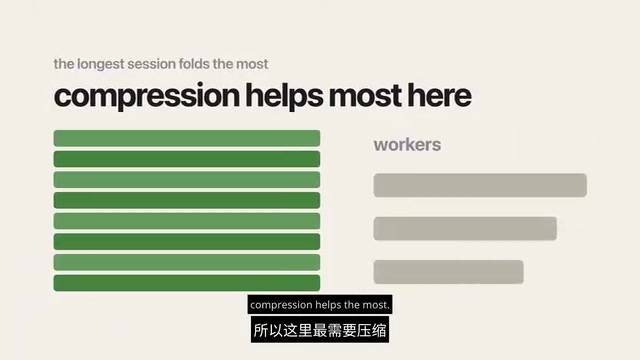
如果你需要用于编排的ai agent,Pentacode里有个architect负责跟踪所有任务,再把工作分配给多个performer,Claude也是其中一个工具。architect这个会话存活最久、增长最多,所以这里最需要压缩。由于agent可以在PyOpenCode或Pimicode上工作,这些工具都内置了billion插件,因此可以让整个团队保持精简。
简单来说,Billion Context是一种代理机制,能让模型借助工具把自己的历史压缩成小块可恢复的数据,同时保留缓存不变。在DeepSeek V4 Flash上的测试显示,它比完整上下文更省钱,而且在编程任务里效果甚至还略好一些。把它接到Claude Code或Claude Desktop上,你就能用更便宜的开源模型保持会话不中断。如果你的长时间agent会话总是被打断或者成本太高,这个方案值得一试。
相关推荐

Gemini 4 Neon评测:跑分比肩Carbon,API定价与额度解析
Google Gemini 4 Neon正式上线,跑分紧咬Carbon,API定价3/15为Hydrogen两倍。本文汇总B站UP主实测:Neon可平替90% Carbon场景,AntiGravity中额度消耗仅为Carbon三分之一,并解析订阅渠道限制与2API封号风险。

Gemini 4 Helium或将至?Google订阅限制松绑信号
Google团队成员预告发布将继续,社区推测Gemini 4 Helium(Flash Lite)或成下一款模型;订阅封禁争议获回应,产品负责人以「Soon」暗示可能开放限制。本文梳理Gemini动向、OpenAI Coding Agent与风险管理、豆包实时音视频API及算力商业动态。

AI辅助React开发实战:视频应用优化与错误处理
14年经验开发者演示如何用AI辅助优化React视频应用:通过ImageKit将视频从80MB压缩至5MB(约94%),并实现可靠的错误处理与重试机制。包含与AI协作的规划、代码理解和验证方法。