GitHub Spec-Kit实战:5条核心命令管住AI编程不跑偏

为什么AI编程总是跑偏?
用AI编程工具写代码,最怕的不是它写不出来,而是它一口气跑完之后,你回头一看代码乱成一锅粥,根本不知道从哪一步开始跑偏的。那时候再回去捞,错早就埋进代码深处,修复成本比重写还高。
说穿了就一件事:你没把话说清楚,它就只能猜。它猜错了你又没机会拦。
这背后有一个技术层面的根本原因:当前主流AI编程工具(如GitHub Copilot、Cursor、Claude Code)底层依赖大语言模型(LLM)的自回归生成机制。模型在生成每一个Token时,都是基于前文概率分布做出选择。当用户提供的上下文不够充分时,模型会依据训练数据中的统计规律进行「补全」——这在技术上叫做hallucination(幻觉)或implicit assumption(隐式假设)。对于代码生成场景,这意味着AI可能会自行决定数据库选型、API设计风格、错误处理策略等关键架构决策,而这些决策一旦在早期被默默做出,后续所有代码都会基于这些假设继续生长,形成所谓的「错误雪球效应」。
这正是GitHub官方开源的Spec-Kit要解决的核心问题。它专门配合Claude Code、Cursor、Copilot等AI编程工具使用,核心理念只有一个——每写一步都停下来,等你点头确认后再继续。
轻量AI编程工具的三个盲区
市面上那些轻量级AI编程工具,上手快、关卡少,确实好用。但根据实战经验(烧了200亿Token砸出来的教训),它们有三块永远接不住:
这里提到的200亿Token是一个值得注意的数字。Token是大语言模型处理文本的基本单位,一个英文单词通常对应1-2个Token,一个中文字约对应1.5-2个Token。200亿Token的消耗量意味着大规模的生产级AI编程实践——以GPT-4的API定价估算,这相当于数百万美元级别的调用成本。这个数字来自企业级团队在真实项目中的累积使用量,反映的是在高强度使用AI编程工具后总结出的经验教训,而非实验室环境下的理论推演。
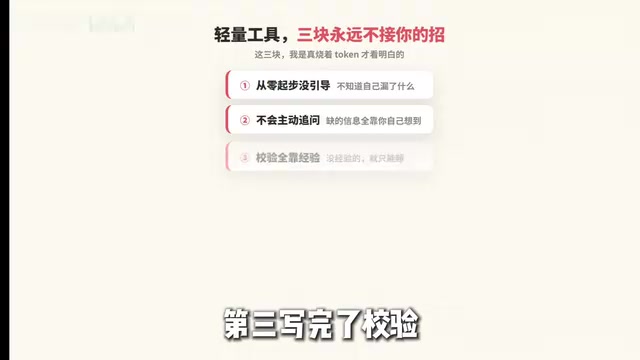
第一,从零起步没人引导。 你不知道自己漏了什么,项目边界、技术约束、架构决策,这些关键信息如果开局没有梳理清楚,后面每一步都在埋雷。
第二,它不会主动追问。 你缺的信息全靠自己想到。AI不会说"这里你没说清楚,我需要确认一下",它只会默默用自己的理解填补空白——而这种填补往往就是跑偏的起点。
第三,写完了校验全靠你自己。 没有内置的验收机制,有经验的开发者还能肉眼Review,没经验的就只能赌。
Spec-Kit干的就是把这三块全堵上:开局立规矩,中间主动追问,最后内置校验。一句话:把猜的环节全砍掉,把人的判断喂进去。
Spec-Kit五条核心命令详解
Spec-Kit一共有9个命令,但团队自己也清楚不是每个都必须用。他们把命令分成了5条核心加几道可选关卡,这就是所谓的"五命令精简哲学"——大道至简,能省的关卡就省,该卡的一道也不让你跳。
第一步:立Rules——给AI画红线
给项目先放一份文档,告诉AI什么能动、什么不能碰。在Claude Code里就是claude.md,在Cursor里就是.cursor rules。

Claude Code中的claude.md和Cursor中的.cursor rules本质上都是「系统级提示词」(System Prompt)的项目化落地。它们以Markdown文件的形式存放在项目根目录,每次AI读取代码库时都会优先加载这些规则文件。这种机制借鉴了软件工程中.editorconfig、.eslintrc等配置文件的思路——通过声明式的规则文件统一团队行为。区别在于,传统配置文件约束的是IDE或Lint工具的行为,而Rules文件约束的是AI Agent的行为边界,包括但不限于:禁止修改的文件路径、必须遵循的命名规范、技术栈约束(如「只用PostgreSQL,不要引入MongoDB」)、代码风格偏好等。
这一步最容易被跳过,但跳了你后面每一步都在摆烂。Rules就像是给AI画的一条红线,没有它,AI就是在一片空白里自由发挥。
第二步:写需求——结构化表达意图
把你要的东西写成AI能读的格式,不是聊天里那种飘忽的描述,而是结构化的、明确的需求文档。这一步的质量直接决定了后续所有环节的上限。
结构化需求不同于自然语言聊天的关键在于「可解析性」和「可验证性」。在传统软件工程中,需求文档通常遵循IEEE 830标准或用户故事(User Story)格式。在AI编程场景下,结构化需求通常包含:功能描述、输入输出规格、边界条件、非功能性要求(性能、安全)、验收标准等字段。这种格式的好处是双重的:一方面AI模型能更精确地理解意图(减少歧义),另一方面生成的代码可以直接对照验收标准进行自动化测试,形成闭环。Spec-Kit在这一步实际上是将需求工程(Requirements Engineering)的最佳实践嵌入到了AI编程工作流中。
第三步:出方案——先看思路再动手
AI拿着Rules和需求,给你一份"我打算这么干"的设计方案。注意,这里它不是直接写代码,而是先告诉你它的思路,等你确认了再动手。
让AI先输出设计方案再生成代码,本质上利用了大语言模型的Chain-of-Thought(思维链)能力。研究表明,当模型被要求先「思考」再「执行」时,输出质量显著提升。在AI编程场景中,设计方案阶段相当于让模型先进行架构推理——确定模块划分、数据流向、依赖关系——然后再基于这个推理结果生成具体代码。这不仅提高了代码质量,更重要的是给了人类一个「审查窗口」:你可以在代码生成之前就发现思路偏差,而不是等几百行代码写完后才发现方向错了。
第四步:拆任务——从大而模糊到小而精确
把方案拆成一条条具体的任务,每条都能单独验收。这是从"大而模糊"到"小而精确"的关键转化,也是企业级项目管理的基本功。
任务拆解(Task Decomposition)在软件工程中对应的是Work Breakdown Structure(WBS)方法论,也是敏捷开发中Sprint Backlog的核心实践。在AI编程场景下,任务拆解有额外的技术意义:大语言模型的上下文窗口(Context Window)是有限的(即使是最新的Claude 3.5也只有200K Token),当一个任务过于庞大时,模型需要同时处理的信息量超出其有效注意力范围,输出质量会急剧下降。将大任务拆成小任务,每个任务独立执行,实际上是在工程层面规避了模型的注意力衰减问题,同时也让每个子任务的验收变得可操作。
第五步:生成代码——逐条执行逐条验收
AI拿着任务清单去写代码,写完一条对照一条,跑没跑偏一眼就看出来。
写完这一步你才知道,前面四步省下的那点时间,全是后面要还的。
两道可选关卡:质量防线的差异化关键

除了五条核心命令,Spec-Kit还有两道可选关卡:
主动追问(Clarification): AI在执行过程中发现信息不足时,会主动停下来问你,而不是自己脑补。这一点看似简单,却是和轻量工具最本质的区别。
主动追问在AI Agent架构中属于「反射式交互」(Reflective Interaction)模式。传统的AI编程工具采用的是单轮或少轮对话模式——用户输入指令,AI直接输出结果。而主动追问要求AI具备「元认知」能力:它需要在执行过程中评估自身信息的充分性,当置信度低于某个阈值时主动暂停并向用户请求补充信息。这在技术上通常通过Prompt Engineering实现——在系统提示词中明确要求模型「当遇到歧义或信息不足时,必须先提问而非假设」。这种机制将AI从「执行者」提升为「协作者」,是Human-in-the-Loop(人在回路中)设计理念的具体体现。
一致性检查(Consistency Check): 生成的代码和最初的需求、方案做一次交叉比对,确保没有偏离轨道。
一致性检查借鉴了软件工程中的需求追溯矩阵(Requirements Traceability Matrix)概念。在传统开发中,QA团队会建立需求→设计→代码→测试的追溯链,确保每个需求都有对应的实现,每段代码都能追溯到具体需求。Spec-Kit的一致性检查将这个过程自动化:让AI将最终生成的代码与最初的需求文档和设计方案进行交叉比对,检查是否存在遗漏的功能点、偏离的设计决策或引入的未经授权的依赖。这在企业级项目中尤为关键,因为需求漂移(Scope Creep)是项目失败的首要原因之一。
这两道关卡不是每个项目都需要开启,但对于企业级项目来说,它们就是质量的最后一道防线。
跟轻量工具最大的不同就在这里:它每一步都停下来等你点头,而不是一口气跑完。 把AI编程从"赌一把跑完"变成"每一步都看得见",这是企业级项目能不能落地的分水岭。
什么项目该上Spec-Kit?
说实在的,Spec-Kit上手比轻量工具难,不是所有项目都值得上。有过这样的教训:给一个就改两行代码的小工具也上Spec-Kit,最后流程跑得比写代码还久,典型的杀鸡用牛刀。
判断标准其实很简单:
- 如果项目涉及多模块协作、需要团队交付、有明确的质量要求——上Spec-Kit
- 如果只是个人小工具、快速原型、一次性脚本——轻量工具足够
- 如果你拿不准,问自己一个问题:这个项目如果AI跑偏了,我回头修的成本有多高?成本高就上,成本低就别折腾
真正能攒下来的AI编程本事

这套方法论最值钱的地方在于它的通用性。你管AI编程的方式会从"AI替我做完了但我不放心",变成"每一步我都点过头"。
工具换成Cursor、Claude Code、Codex都成立;模型换成下一代、下下一代也成立。方法通用,工具按钮可换。 这才是AI编程这一行真正能攒下来的本事。
这一两年新框架一个接一个冒出来,看看就行,千万别指望拿来直接落地。看到别人吹某某框架功能多牛,先反问一句:那些功能你真用得上吗?大部分时候你会发现,那些花里胡哨的命令,真到了企业级项目上能用上一半就不错了。
总结
送一句话作为这篇文章的结尾,也是Spec-Kit哲学的精髓:
让AI停下来等你点头,比让AI跑得快更重要。
Spec-Kit的五条核心命令(立Rules → 写需求 → 出方案 → 拆任务 → 生成代码)加上两道可选关卡(主动追问 + 一致性检查),构成了一套完整的AI编程质量管控体系。它不是让你写代码更快,而是让你交付的代码更靠谱。在企业级项目中,靠谱永远比快速更值钱。
相关推荐
ChatGPT Space 发布:团队协作与 Pages 新功能解析
ChatGPT Space 是 OpenAI 推出的团队协作新功能,核心包含 Pages 页面、实时协作和 Slack/Google Drive 数据同步。本文解析其隐私设计、多平台集成与从对话到文档的完整工作流,帮助团队理解如何用 AI 统一项目管理与内容创作。

用AI Agent将Apache Spark UDF迁移到GPU加速
NVIDIA 开发者博客介绍如何用 AI Agent 将 Apache Spark UDF 重写为 GPU 加速版本,涵盖可迁移算子的判断标准、Agent 改写与验证流程,以及结果一致性、CPU-GPU 传输开销等落地陷阱。

Zed 编辑器 v0.40.4-rc2 发布:无需升级即可使用启动额度
Zed 编辑器发布 v0.40.4-rc2 候选版本,核心改动是允许用户在不升级付费计划的情况下使用启动额度(usage credits)调用 AI 功能,降低试用门槛。