GitHub周涨星最猛的10个AI开源项目盘点
本周GitHub涨星榜显示AI开源项目正把专业能力封装成一句指令。
本文梳理B站UP主整理的GitHub周涨星数据中的10个AI开源项目,按逆向工程、可视化生成、记忆与成本优化、垂直场景四类逐一拆解。REA以一周涨21.4万星居首,让AI调用Ghidra、IDA完成逆向并附证据;Skills、Diagram Design、OpenMontage把工程工作流与内容生产封装成技能包和流水线;Claude MEM做长期记忆,Free Claude Code用代理接入免费额度,AirLLM以层间加载实现4G显存跑28000亿参数模型;Knowledge Work Plugins、Text to CAD、OpenSRE则分别覆盖非技术岗位、零件制造与运维排障。共同趋势是专业门槛快速下降。
一周涨星榜:AI开源项目的新动向
这一周的GitHub趋势榜上,AI开源项目呈现出一种明显的分化:有的项目在极短时间内获得爆发式关注,有的则凭借长期积累在特定节点被重新发现。本文基于B站UP主整理的GitHub周涨星数据,梳理这10个项目各自解决了什么问题、为什么火,以及装上之后能获得什么新能力。
从榜单构成看,既有面向开发者的编程增强工具,也有让非技术岗位受益的插件包,还有在硬件资源受限场景下突破限制的推理方案。以下逐一拆解。
逆向工程与代码理解
REA:让AI替你拆解任何APP
REA(Reverse Engineer Anything)是本周榜单中涨星最猛的项目,总星数269000,4月建库,这一周就涨了214000颗星,单日新增超过3万。它的定位很直接:当你在别的应用里看到一个做得特别好的功能,过去需要懂汇编、会用反编译工具逐行去啃,现在只需对AI说一句“帮我搞清楚这个APP的搜索是怎么做的,把证据给我,再在我的项目里做一个类似的”。
AI会调用Ghidra、IDA这些逆向工具,顺着调用链一路往下追,每个结论都附带证据。官方放出的案例中,AI把一个老游戏里计算声音左右声道的函数还原成了C代码,3200多组测试全部对上,编译出来的63个项目字节和原版一模一样。这意味着逆向工程的门槛被大幅拉低,功能拆解从专家技能变成了一句指令。
逆向工程中的 Ghidra 与 IDA
Ghidra 是美国国家安全局(NSA)开源的反汇编与反编译框架,支持多种处理器架构,可将二进制程序还原为接近 C 语言的伪代码,是免费方案中的主流选择。IDA Pro 则是商业逆向工程工具的标杆,拥有更强的交互式分析、调试和插件生态,长期被安全研究人员用于恶意软件分析与漏洞挖掘。两者都能把机器码翻译成人类可读的汇编或高级语言表示,但面对大型应用时仍需人工逐层追踪调用链、判断数据结构。REA 的价值在于把这类工具作为「手」来调用,由大模型承担「读代码、提假设、找证据」的推理工作,从而把原本高度依赖经验的逆向流程压缩成自然语言指令。
Skills:工程化工作流的技能包
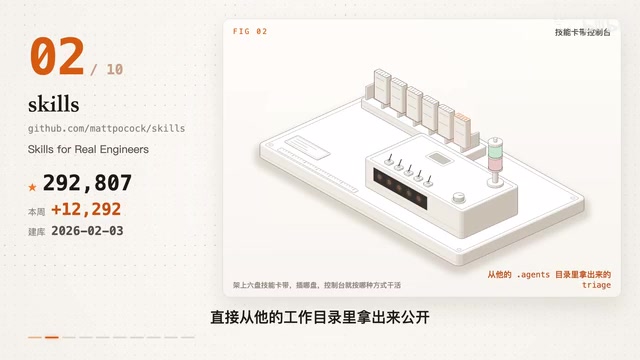
作者Matt Pocock是TypeScript圈子里知名的老师,项目总星数292000,这一周涨了12000多。他把自己每天写代码真在用的一套AI技能直接从工作目录里公开。
其中最火的一个叫“Grill Me”,思路是反过来的:AI动手之前先把你问一遍——你到底要做什么、边界在哪、哪种情况怎么处理,问清楚了再写。另一个技能是先写一个会失败的测试亮红灯,再改代码让它变绿,每一步都有反馈。还有排查Bug的流程、定期给代码架构做体检的技能。每个技能都很小,可以随意改成自己的版本。装上它,AI从一个闷头写代码的新人变成一个先问清楚再一步步验证的工程师。
可视化与内容生成
Diagram Design:教AI画专业图解
你让AI画架构图,它一般甩给你一张Mermaid方框套方框,又挤又丑。Diagram Design把45种图的规矩都定好了,包括架构图、时序图、四象限、流程图、时间线,每一种都有明暗两套样式。你只要用大白话说“给我画一张我这个应用的架构图,前端后端数据库Redis缓存”,AI自己挑图类型,排在四象限的网格上,还会检查有没有重叠、有没有出界,最后给一个HTML文件双击就能打开。
更实用的是,你给它一个网址,它会把你网站的配色和字体学过来,以后画的每一张图都是你自己品牌的样子。项目总星数55800,4月中旬建库,这一周涨了17000。
OpenMontage:一句话生成完整视频
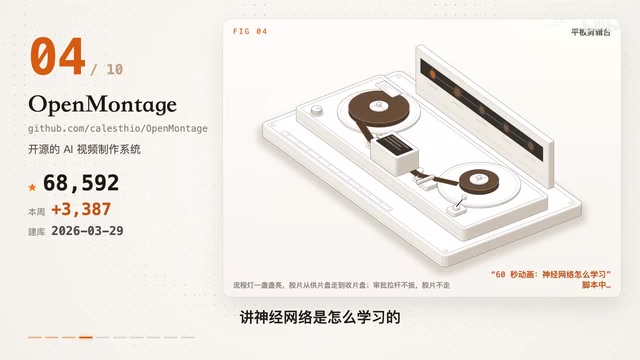
OpenMontage是一个开源的AI视频制作系统,总星数68500,这一周涨了3300多。它把你手里的AI编程助手(Claude Code、Cursor、Codex这些)直接变成一个视频工作室。你说一句“给我做一个60秒的动画讲神经网络是怎么学习的”,它就自己查资料、生成画面和配音、剪辑合成,最后出成片。
里面有十几条制作流水线、100多个工具、700多份技能和制作经验文件。开工之前先给你报价,生成素材之前先给你看分镜,你点了头才开始花钱。官方展示的一条短片“一根孤独的香蕉和一个猕猴桃交朋友”,60秒总成本1.33美元。你还能扔给它一个喜欢的视频,它会分析节奏镜头风格,照着这个路子给你做一个新题材。
记忆、成本与资源突破
Claude MEM:给AI加长期记忆
Claude MEM是去年8月就有的老项目,总星数101000,这个月涨了7000多,这一周3000多。用AI写过代码的都知道,开一个新对话它就全忘了,昨天修过的bug、定好的方案得从头再讲一遍。
Claude MEM会在后台盯着AI每次用了什么工具、改了什么,自动记下来,再用AI压缩成一条条摘要存进本地数据库。下次开新对话,它不是把所有东西一股脑塞回去,而是先查索引挑出相关的几条,需要了再去取细节。官方说这样大概能省10倍的token。Claude Code、Codex、Gemini、OpenCode都能装。装上以后,AI像一个一直跟着这个项目的老同事,上次聊到哪都记得。
Free Claude Code:零成本试用AI编程工具
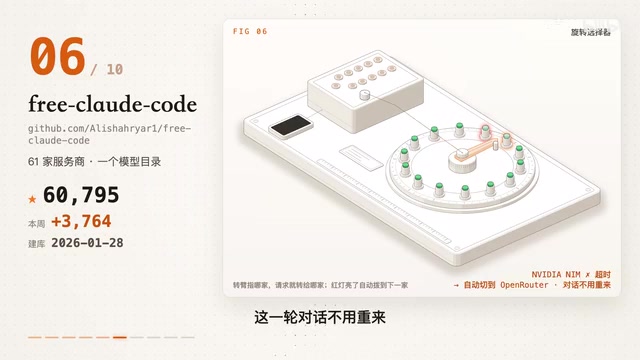
Claude Code、Codex这些编程工具很好用但是贵。Free Claude Code的做法是在你电脑上起一个代理,把这些工具发出去的请求转给别的模型服务商。它接入了多家服务商,包括各家的免费额度,合起来一个月有13亿多免费token,也能接你本地的模型。
默认用的是英伟达NIM上的模型,11种编程工具共用一个模型目录。某一家服务挂了,它自动切到你排好的下一个模型,这一轮对话不用重来。你甚至可以在手机上用Telegram或者Discord发一段指令让它去写代码。
需要说清楚:它不是Anthropic官方的项目,背后跑的也不是Claude本身的模型。但如果你想先零成本试试这类AI编程工具,这是现在门槛最低的一条路。项目总星数68000,这一周涨了3700多。
AirLLM:小显存跑超大模型
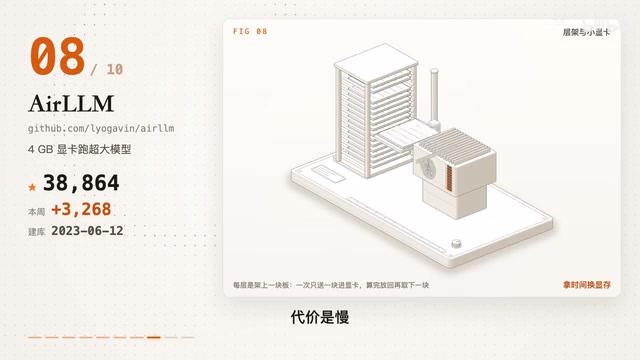
AirLLM是2023年就有的老项目,总星数38800,这周突然又涨了3200多,因为它刚支持了一批新的超大模型。平时跑一个700亿参数的模型要好几张大显卡,因为整个模型得一次全塞进显存。AirLLM的思路很简单:模型本来就是一层一层算的,那就别全装进去。模型放在硬盘上,算到哪一层就只把那一层搬进显存,算完扔掉再搬下一层。
不用量化、不用蒸馏,也不用减质。实测中,最大开源模型Kimi K2(28000亿参数)只用了3.72个G的显存;上个月它还支持了训练,1250亿参数的模型6个G显存以内就能微调。代价是慢——它是拿时间换显存。但这意味着你手边一台普通电脑也能亲手试一试原来只有机房才跑得动的模型。
为什么大模型必须「全量驻留显存」
常规推理时,GPU 需要把模型每一层的权重都放在显存里,因为矩阵乘法要在极短时间内反复读取参数,显存带宽远高于硬盘和内存。一个 700 亿参数的模型以 FP16 存储约需 140GB 显存,远超单卡容量,所以通常要靠多卡并行或量化压缩。AirLLM 采用的是层间流水:一次只加载当前计算层,算完即释放,显存占用从「整个模型」降到「单层加激活值」。代价是每层都要从硬盘搬运权重,吞吐量受 PCIe 和磁盘速度限制,因此生成速度显著变慢。这是一种典型的以时间换空间的工程取舍,适合验证、调试和低并发场景,不适合高吞吐生产服务。
垂直场景:从零件到运维
Knowledge Work Plugins:非技术岗位的AI插件
前面几个都是给写代码的人用的,这个是Anthropic官方出的,给不写代码的人——销售、法务、财务、市场、客服、产品经理、做数据的,还有做生物研究的。一个岗位一个插件,一共11个。每个插件里打包了这个岗位的专业知识、常用流程、斜杠命令,还接好了公司里常用的工具,比如Slack、Notion、Snowflake。
装了销售插件,打一个命令它就帮你把客户电话要准备的东西备好;装了法务插件,可以先帮你过一遍合同和保密协议。整个插件只是一堆Markdown和JSON文件,没有代码。把你们公司的术语和流程写进去,它就变成你们公司自己的版本。项目总星数29800,这一周涨了2600多。
Text to CAD:一句话生成可加工零件
以前做一个3D零件得打开建模软件画草图、拉伸、倒角,一步一步建。现在你跟AI说“给我做一个固定树莓派的支架,4个M2.5的螺丝孔,厚度2毫米”,它就在你本地生成3D模型,导出STEP、STL、3MF这些标准格式。它还会做可制造性检查,看这个零件到底能不能加工,再出一张带尺寸的工程图,最后还能直接连到3D打印、板金和CNC加工服务下单,把实物做出来。Claude Code、Codex、Cursor、Gemini都能装。项目总星数27000,这一周将近2000。
STEP、STL 与 3MF 的区别
STEP 是 CAD 领域的交换标准,保存的是精确的边界表示(B-rep)几何和设计历史语义,可以被 SolidWorks、Fusion 360 等软件继续编辑,适合工程制造环节。STL 只记录三角面片,丢失了曲面精确性和特征信息,主要用于 3D 打印切片,文件简单但不可参数化修改。3MF 是较新的打印格式,在网格之外还能携带材料、颜色、单位与打印设置等元数据。Text to CAD 同时导出这三种格式,意味着生成的模型既能回到 CAD 工具里继续改,也能直接送进切片软件或加工服务,覆盖了从设计到制造的不同交接点。
OpenSRE:让AI帮你值夜班
SRE就是负责线上服务稳定的工程师。半夜服务出了问题,证据散在日志、监控指标、调用链路、最近的发布记录,还有一堆聊天消息里,得一个一个去翻。OpenSRE是一套开源工具,让你搭自己的AI SRE。告警一来,它自动去拉相关的日志、指标、链路和最近的部署,先把敏感的标识打上码再交给模型,模型在你接好的60多种工具之间来回查,提出假设、验证假设,最后给你一个带证据的结论,建议怎么修。你同意的话还能直接动手修,再把总结发到Slack。
你也可以在命令行里直接问它“为什么结账接口变慢了”。项目总星数11900,目前还是公开测试版。他们想做的是AI运维的训练场,把成千上万种真实的线上故障做成测试,让AI在里面练。
SRE 与可观测性三支柱
SRE(站点可靠性工程)源自 Google 的运维方法论,核心是用软件工程手段管理服务稳定性,包括定义 SLO、控制错误预算、做故障复盘。排障时依赖的「可观测性三支柱」分别是日志(离散事件记录)、指标(随时间聚合的数值,如延迟、错误率)和链路追踪(一次请求跨服务的调用路径)。OpenSRE 之所以要同时拉取这三类数据,是因为单一信号往往不足以定位根因:指标告诉你「变慢了」,链路指出「慢在哪个服务」,日志才解释「为什么慢」。再加上最近的发布记录和聊天上下文,模型才能提出可验证的假设,而不是凭猜测给建议。
这周榜单说明了什么
这10个项目覆盖了逆向工程、代码生成、图解制作、视频生产、记忆管理、成本优化、显存突破、岗位插件、CAD生成和运维自动化。共同点是:每一个都在给AI装上一样具体的新本事,而且门槛都在快速下降。从4G显存跑28000亿参数模型,到一句话生成可加工的零件,过去需要专业工具链和多年经验的事情,正在被重新组织成一句指令加一套技能包。对于会用AI的人来说,手里可用的工具正在变得越来越多,也越来越具体。
相关推荐

Hibana:统一内存设备上的高速Agent推理引擎
Hibana是专为统一内存设备设计的推理引擎,通过模型手术、统一内存管理和自适应推测三项技术协同优化,在单台DGX Spark上相比vLLM等框架实现最高3.4倍的Agent任务完成速度和3.9倍的解码吞吐提升,助力本地AI智能体高效运行。

无需训练:LongCapHarness 如何激发大模型长上下文推理潜能
LongCapHarness 提出一种无需数据合成和模型后训练的长上下文推理增强框架,通过递归自我改进驾驭模型潜在能力,在 HELMET 和 RULER 基准上显著优于数据合成基线,开发成本不到 NExtLong 和 PolicyLong 的一半。

权重没改也能恢复被编辑知识?提示空间审计新方法
论文提出 Memento 提示空间机制,不修改权重即可恢复被编辑模型 80.07% 的留出事实,并在未编辑模型上提升 53.9% 事实召回,为模型知识审计提供黑盒友好新方法。