Git提交成功但Husky钩子静默失效:worktree陷阱与多层防御方案

Git worktree 会继承钩子路径却缺少可执行 shim,导致 pre-commit 检查静默跳过。
文章讲述了作者在 Husky 与 Git worktree 配合时遭遇的静默故障:新 worktree 继承了 core.hooksPath 配置,却没有生成 .husky/_ 下的可执行 shim,导致 pre-commit 检查从未运行,而提交仍成功、毫无报错。作者由此意识到“已配置钩子”并不等于“钩子已生效”。在并行 Cursor 会话和云代理舰队场景下,每个新 worktree 都是独立初始化边界,问题被进一步放大。为此作者将钩子保障拆成四层:可用性验证、代理编辑反馈、本地 pre-commit 与 CI 兜底,并通过共享脚本、会话启动校验和云钩子桥接,让损坏状态更易被发现、修复或在提交前拦截。
一个让代码检查形同虚设的陷阱
我习惯在多个仓库中使用 Husky ,让每次提交都经过 lint、类型检查和格式化验证。这套机制稳定运行了好几年,直到我添加了一个 git worktree。
新 worktree 继承了主检出的 core.hooksPath 配置,但没有继承 Husky 在 .husky/_ 下生成的可执行 shim。结果就是:我提交了代码,Git 欣然接受,commit 成功。没有一个 pre-commit 脚本被执行。没有报错,没有红色警告,没有失败的退出码。那些我深信不疑的强制检查,从未运行过。
那一刻我才意识到,自己一直把“已配置钩子”等同于“钩子已生效”——而这是错的。
“已配置”到底意味着什么
现代 Husky 不再把脚本直接放进 .git/hooks 目录。Git 读取 core.hooksPath(通常指向 .husky/_),Husky 在那里安装小型转发 shim,这些 shim 再去调用真正的钩子脚本,比如 .husky/pre-commit。
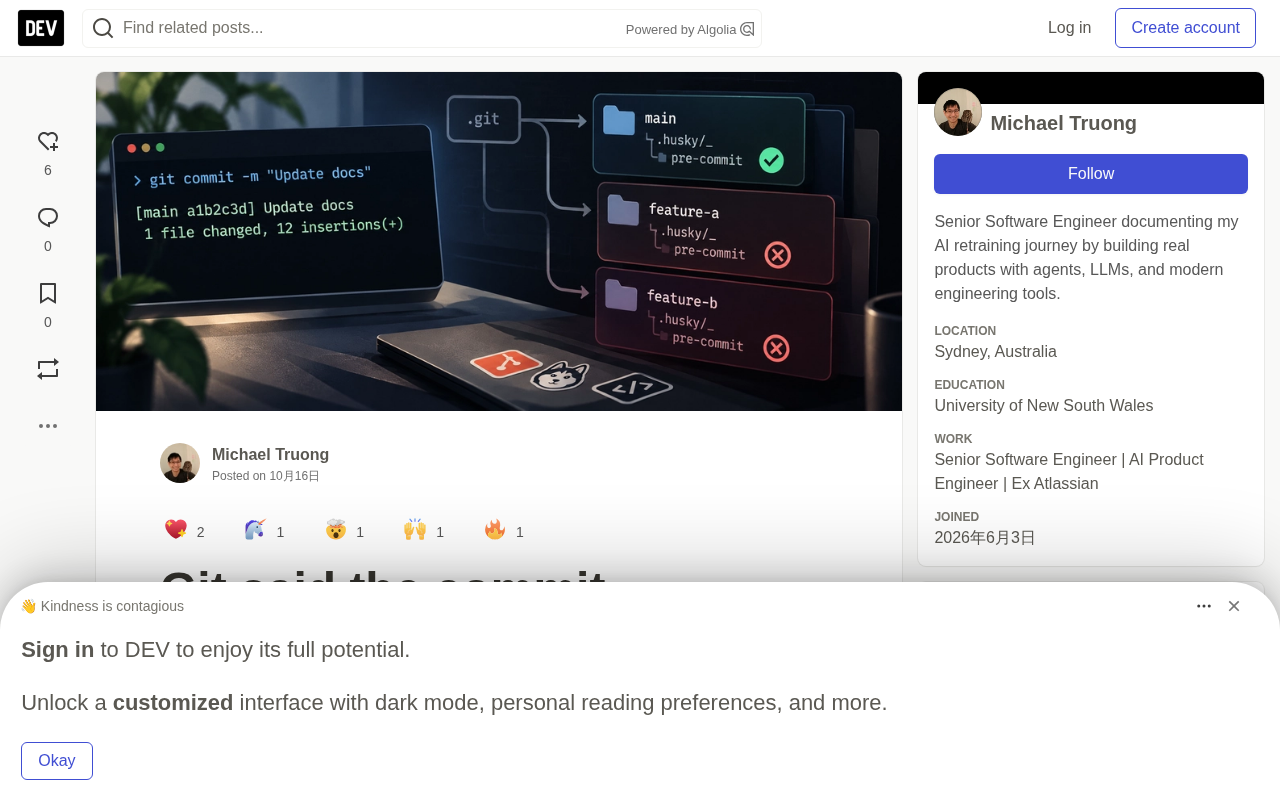
关键问题在于:新建 worktree 会继承仓库的 core.hooksPath 设置,但它不会自动生成 .husky/_ 下的可执行 shim。git worktree add 不会替你完成这一步。
已有检出
├─ core.hooksPath → .husky/_
└─ .husky/_ shims     存在 → pre-commit 运行

新建 worktree
├─ core.hooksPath → .husky/_   (已继承)
└─ .husky/_ shims     缺失 → 提交成功,钩子静默
换言之,一个全新的 worktree 完全可能拥有正确的钩子路径配置,却缺少运行检查所需的可执行 shim。Git 照样接受你的提交,一切看起来风平浪静。
core.hooksPath 是 Git 的一个配置项,用来覆盖默认的钩子查找目录(.git/hooks)。当它被设置为某个路径时,Git 在执行 pre-commit、commit-msg、pre-push 等钩子阶段时,会直接去该路径下寻找同名可执行文件,而完全忽略 .git/hooks。
这一机制本意是让钩子脚本可以纳入版本控制、跨机器复用,但它也带来一个前提:目标路径下必须真的存在可执行文件。Git 只负责“去这里找”,不负责“确保这里有”。如果路径存在但文件缺失或没有执行权限,Git 会当作没有钩子处理,静默继续提交。
理解这一点是理解全文的关键:无论 Husky 还是其他钩子管理器,都只是在替 Git 准备这些文件。配置本身与文件是否存在是两件独立的事。
当问题从单兵扩展到代理舰队
过去几年,我基本在一个相对稳定的检出环境中工作:安装依赖、初始化 Husky,之后很少再想钩子配置的事。
但这个假设在并行使用 Cursor 会话和 Git worktree 时开始崩塌。每个新 worktree 都是一个需要独立初始化钩子的检出,即便原始检出配置完全正确。
当我开始设计由 GrokBot 协调的云端代理舰队时,这个问题变得更加棘手。GrokBot 运行在云端计算机上,将编码任务分派给各自独立环境中的 Cursor 云代理。
一个云代理可以正常启动、运行安装脚本、初始化 Husky。但如果它随后又创建了一个 Git worktree,这个新检出就需要自己的初始化。启动脚本不会自动再次运行。
原始检出初始化正确,新 worktree 却没有。而在一个由多个代理组成的舰队中,我不可能依赖自己去发现并修复每一个缺失的钩子。
Git 和 Husky 都没变。变的是我——我开始把代理启动当作初始化的边界,而实际上每个新 worktree 都会引入一个新的边界。
Git worktree 是 Git 2.5 引入的功能,允许在同一个仓库对象库上同时检出多个工作目录,常用于并行开发不同分支或同时运行多套构建。共享的是 .git 对象库与配置,但每个 worktree 拥有自己的工作区文件和独立的检出状态。
这一点常被误解:很多工具链的初始化步骤(安装依赖、生成钩子 shim、写入本地配置)是针对“某个检出目录”而非“整个仓库”的。新建 worktree 时,这些步骤不会自动重放,因此会出现配置继承但文件缺失的错位。
在并行代理或 CI 环境中,这种错位会被放大:每个 worktree 都是一个新的初始化边界,任何依赖“只初始化一次”的假设都会在边界处失效。
四层责任划分
我需要钩子的可用性在每个环境中都可验证、无需我干预即可修复,并且由不依赖本地钩子运行的检查来兜底。
我把这些职责拆成四层:
| 层级 | 职责 |
|---|---|
| 1. 可用性 | 验证钩子在此检出中可运行 |
| 2. 代理反馈 | 在编辑过程中改善格式化 |
| 3. Pre-commit | 提交前运行本地验证 |
| 4. CI | 独立验证变更 |
模糊这些职责的边界,正是静默跳过得以藏身的地方。
第一层是观测性,本身不是强制执行。 代理不能因为 core.hooksPath 已设置就假定钩子激活。我的 verify:git-hooks 脚本会检查 .husky/ 下的每个钩子在此 worktree 的 .husky/_ 中是否有对应的可执行 shim。绿色通过只意味着管道存在,并不证明 Git 下次提交时会调用这些钩子,也不代表 pre-commit 检查会通过。第三、四层仍然负责“下次提交是否真的受保护”。
第二层刻意保持弱约束。 代理编辑文件时的可选格式化有助于 diff 保持可读,但这是便利性,不是保证,不能替代 pre-commit 或 CI。
第三、四层故意分离。 本地 pre-commit 是每个仓库自行选择的配方;CI 则是当某个检出、某个代理会话或某个被跳过的钩子放了东西过去时的最后防线。
我做出的改变
我把钩子验证和修复移入共享脚本,在 Cursor 会话启动时运行。它们检查当前检出中是否存在 Husky 的可执行 shim,缺失时尝试修复,如果问题依旧存在就发出 HOOKS NOT RUNNABLE 警告。会话启动保持 fail-open,这样坏掉的钩子不会阻止我继续编辑。
云代理需要另一重保障。Cursor 的钩子桥接会在提交时把 Git 钩子执行路由到当前仓库。当桥接激活时,缺失的 Husky shim 会产生显式的提交失败,而不是静默跳过。在我配置了阻塞式云启动门的仓库中,代理还会等待桥接可用后才开始工作。
这些都不会自动初始化会话中稍后创建的 worktree。每个新检出仍然需要自己的 prepare 运行。我把验证、修复和云生命周期脚本打包进我的市场插件,并在多个仓库中复用。但每个仓库仍需将这些脚本接入自己的安装和会话启动生命周期——单独安装插件不会激活这些保障。
改变的不是所有可能的钩子故障都被消除,而是损坏的钩子状态变得更容易被发现、修复或在未检查提交溜走之前被拦截。
核心结论: 配置好的钩子路径告诉我 Git 会去哪里查找,但它没有告诉我那里到底有没有东西会运行。
实现代码: 我发布的钩子验证与修复脚本已公开,如果你对解决思路感兴趣可以参考。
“fail-open”与“fail-closed”是描述故障策略的术语。fail-open 指校验或防护失败时选择放行,保证流程不中断,但风险可能漏过;fail-closed 指失败时选择阻断,保证安全但可能误伤正常操作。
作者让会话启动保持 fail-open,是为了避免坏掉的钩子阻碍编辑;而云端的“阻塞式启动门”则偏向 fail-closed,让缺失 shim 直接变成显式提交失败。两者结合,是把不同阶段的风险与可用性需求分别处理,而不是用单一策略覆盖所有场景。
相关推荐

零成本搭建AI超级员工系统:智能体自动工作流全解析
深度拆解B站演示的AI超级员工系统:Agent智能体编排、数字人口播、地图与企业获客、24小时智能客服及法务模块全覆盖。分析零成本开户背后的商业逻辑与合规风险,帮助创业者判断这套AI数字员工系统的真实投产比。

Chatbot与AI Agent的本质区别:从对话到执行的跨越
Chatbot和AI Agent有什么区别?本文基于Learn Tech频道的MCP系列讲解,用订机票、笔记摘要等实例说明:Chatbot只给答案,Agent通过思考-行动-观察循环真正完成任务,并拆解模型、工具、记忆、目标四大部件及MCP的桥梁作用,同时讨论Agent的适用边界与权限风险。

免费GitHub仓库:342小时AI课程,从数学到MCP服务器
一个免费GitHub仓库提供342小时AI课程,包含523节课、20个阶段,覆盖数学基础到Agent构建和MCP服务器。支持目标驱动学习,每节课产出可留存的prompt、skill或agent,已有近10万人开始学习。