GLM-5.2 vs GPT-5.5:思维导图组件垂直居中难题实测对比

一个真实场景引发的模型对比
在AI编程辅助工具日益普及的今天,开发者越来越依赖大模型生成代码组件。但一个现实问题也随之浮现:没有任何一个模型能解决所有问题。近日,一位B站UP主在实际开发中遇到了颇具代表性的案例——GPT-5.5始终无法解决的思维导图组件垂直居中难题,最终被GLM-5.2轻松搞定。
这个案例虽小,却折射出当前大模型应用中一个重要趋势:多模型协作正在成为专业开发者的标配策略。
问题的来龙去脉
GPT-5.5从0到1的构建过程
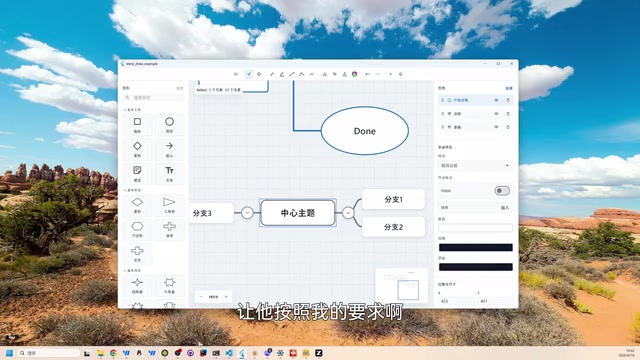
据UP主实测演示,他最初使用GPT-5.5从零构建一个思维导图组件。在整体框架搭建上,GPT-5.5表现相当不错,按需完成了组件主体功能。可以说,在从0到1的创造性构建阶段,GPT-5.5展现出了扎实的代码生成能力。
卡在最后一步的居中难题
问题出在最后的细节打磨上。UP主希望思维导图组件在不同窗口状态下——无论最小化还是最大化——都能保持垂直居中。
技术背景:CSS垂直居中的历史难题 CSS垂直居中问题长期以来是前端开发的经典难题,其根源在于CSS盒模型的设计哲学——CSS最初面向文档流排版而非应用界面布局,导致垂直方向的尺寸计算逻辑远比水平方向复杂。在Flexbox和Grid规范成熟之前,开发者通常需要借助负边距(negative margin)、绝对定位(absolute positioning)配合
top: 50%、或display: table-cell等非语义化hack手段实现垂直居中,这些方案均依赖父容器具有明确的固定高度,一旦遭遇动态尺寸便会失效。现代CSS的主流方案包括:Flexbox(display: flex; align-items: center; justify-content: center)、CSS Grid(display: grid; place-items: center),以及针对绝对定位元素的transform: translate(-50%, -50%)组合技。然而在响应式场景下,窗口尺寸变化会触发浏览器的布局重排(Reflow),若父容器高度未通过height: 100vh(视口高度单位)或height: 100%的完整继承链正确声明,居中效果极易在缩放时产生偏移。更隐蔽的陷阱在于:部分JavaScript渲染框架(如React、Vue)会在组件挂载后动态插入DOM节点,若CSS居中方案与组件生命周期的时序存在冲突,也会导致初始渲染正常而调整窗口后错位的现象。这正是该案例中反复出现的核心技术痛点——看似简单,实则涉及浏览器渲染机制、视口单位语义与框架渲染时序的多重细节积累。
据UP主描述,GPT-5.5生成的版本在放大和缩小时组件位置会发生偏移,无法维持稳定的居中状态。无论如何调整描述、反复沟通需求,GPT-5.5都没能真正解决这个问题。
GLM-5.2的破局表现
一句精准描述换来的解决方案
转机出现在切换到GLM-5.2之后。UP主将同样的需求——明确要求组件"垂直居中"并"适配垂直居中效果"——发给GLM-5.2,模型很快给出了有效解决方案。
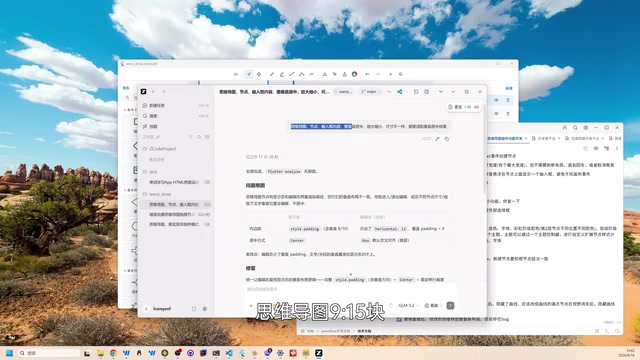
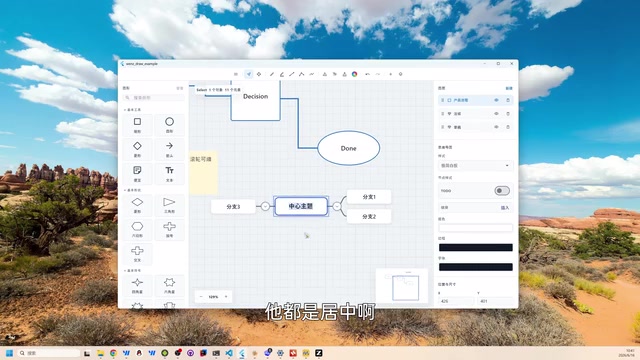
从最终效果来看,改进相当明显。UP主演示时通过双击切换窗口状态,无论最小化还是最大化,组件都能稳定保持垂直居中。虽然仔细观察仍存在极其轻微的错位,但相比GPT-5.5此前的版本已经"好很多了"。
遗留的小瑕疵
值得客观指出的是,GLM-5.2的方案并非完美。UP主提到组件目前"没有办法选择",可能属于另一层面的功能问题,仍需进一步优化。这也提醒我们,即便解决了核心痛点的模型,也可能在其他细节上留有提升空间。
为什么会出现这种能力差异?
大模型各有所长:训练数据与优化目标的分野
这个案例最有价值的启示在于:不同大模型在具体任务上存在能力差异,这种差异并不总体现为"谁更强",而是"谁更适合当前场景"。
不同大模型在代码生成任务上的能力差异,本质上源于训练数据分布、强化学习人类反馈(RLHF)的标注偏好,以及模型架构对特定领域的适应程度。要理解这一点,需要从大模型的训练流程说起:现代大语言模型通常经历预训练(Pre-training)、指令微调(Instruction Fine-tuning)和基于人类反馈的强化学习(RLHF)三个阶段。预训练阶段决定了模型"见过什么",指令微调决定了模型"怎样回应",而RLHF的标注偏好则直接塑造了模型在模糊需求下的"选择倾向"。GPT系列由OpenAI以英文互联网语料为主体训练,标注团队以英语母语开发者为主,在逻辑推理和整体架构设计上积累了大量优化;而GLM系列由清华大学智谱AI研发,针对中文开发者社区语料和国内编程生态做了定向强化,其RLHF标注数据中包含了大量来自国内开发者真实提问场景的样本,对某些中文提示词的理解粒度可能更贴近国内开发者的表达习惯。此外,代码能力评测基准(如HumanEval、MBPP、SWE-bench)往往侧重算法解题与函数级补全,而非CSS布局这类偏向经验积累的前端细节,导致基准分数不能完全预测实战表现——这也是"基准失真"(Benchmark Gaming)问题在实际应用中的一个缩影。
GPT-5.5在组件整体构建、逻辑架构上表现出色,能从0到1完成复杂组件的搭建;GLM-5.2则在这个特定的CSS布局与居中适配问题上给出了更精准的解法。模型的能力边界是多维度的,在某一维度领先的模型,未必在所有细分场景中都占优。
提示词与模型理解的匹配度:提示敏感性的深层机制
另一个值得深入思考的角度是提示词与模型的匹配问题。UP主坦言,GPT-5.5解决不了问题也可能"是因为我描述的问题"。
这一现象在学术上被称为"提示敏感性"(Prompt Sensitivity)。研究表明,语义相近但措辞不同的提示,在同一模型上可能产生截然不同的输出质量。这是因为大模型本质上是在高维语义空间中进行概率采样——特定词组会激活模型在训练过程中形成的不同"知识路径"。从技术层面看,Transformer架构中的注意力机制(Attention Mechanism)会为输入序列中的每个token分配权重,某些"触发词"能显著提升相关知识神经元的激活概率,这一现象被研究者称为"上下文窗口偏置"(Context Window Bias)。"垂直居中适配"这一中文表述,可能恰好对应GLM-5.2训练语料中某段高质量CSS解决方案的token序列,从而触发更精准的代码生成;而相同语义的英文表述在GPT-5.5上也许能产生同等效果,但中文表达在GLM上显然更具"共振"优势。这也解释了为何"提示词工程"(Prompt Engineering)在多模型工作流中至关重要:同一需求用不同语言、不同粒度表述,往往需要在多个模型间交叉验证才能找到最优解。近年来,"元提示"(Meta-Prompting)和"思维链提示"(Chain-of-Thought Prompting)等技术的兴起,正是开发者和研究者试图系统化驾驭提示敏感性的具体实践。
多模型协作:专业开发者的实用策略
换个模型试试,往往事半功倍
UP主在视频结尾给出的建议相当务实:当一个模型解决不了问题时,直接换另一个模型来试。这种"多模型结合"的思路,正成为越来越多专业开发者的日常工作习惯。
多模型协作(Multi-Model Orchestration)已成为AI工程领域的重要研究方向,其背后有着坚实的工程实践基础。LangChain、LlamaIndex等主流AI应用框架均内置了模型路由(Model Routing)机制,允许开发者根据任务类型、复杂度和成本约束自动分发至最适合的模型。更进一步的"混合专家"(Mixture of Experts,MoE)架构思想也开始从模型内部延伸至系统层面——不同模型扮演不同"专家角色",由调度层根据任务特征动态选择。Anthropic、OpenAI等机构的内部评测也显示,在复杂工程任务中,"模型组合"策略的平均表现优于任何单一最强模型,这与集成学习(Ensemble Learning)在传统机器学习领域的经典结论高度吻合。从成本角度而言,多模型协作还能实现效能优化——用轻量模型(如GPT-4o-mini、GLM-4-Flash)处理简单任务,仅在瓶颈处调用高算力旗舰模型,从而在质量与成本之间取得平衡,这对于高频调用API的生产环境尤为重要。
与其在一个模型上反复纠缠、消耗大量时间调试提示词,不如快速切换到另一个模型验证思路。不同模型的训练数据和优化重点各不相同,往往能在对方的"盲区"给出突破。
国产大模型GLM系列的代码能力观察
GLM(General Language Model)系列由清华大学知识工程实验室(KEG)与智谱AI联合研发,是国内学术界与产业界深度融合的代表性成果。其技术路线与GPT系列的纯自回归(Autoregressive)架构有所不同——早期GLM采用了自回归填空(Autoregressive Blank Infilling)的创新预训练目标,通过随机遮蔽文本片段并要求模型以自回归方式填充,同时兼顾了BERT类模型的双向理解能力与GPT类模型的生成能力,在自然语言理解与生成的双向能力上进行了有意识的平衡。这一架构选择使得GLM在处理需要"理解上下文再生成"的任务(如代码补全、指令跟随)时具备了独特的结构优势。进入GLM-4系列后,智谱AI在代码生成、工具调用(Function Calling)、长上下文处理(支持128K tokens上下文窗口)和多模态能力上进行了专项强化,并依托国内庞大的开发者用户群积累了大量真实编程场景的对齐数据,使其在处理中文开发者日常描述的前端、全栈和数据工程问题时具备了显著的本土化优势。
这个案例也从侧面印证了这一点:在GPT-5.5未能攻克的具体问题上,GLM-5.2给出了可用的解决方案,至少说明国产模型在某些细分任务上已具备与顶级模型正面竞争的能力。
当然,保持理性同样重要——这是单一开发者在特定场景下的个案,不能就此得出GLM-5.2全面超越GPT-5.5的结论。但它确实为"多模型协作"提供了一个生动的实证。
结语
这个看似微小的垂直居中难题,实际上浓缩了当下AI编程实践的核心智慧:没有万能的模型,只有合适的组合。在实际开发中,与其执着于寻找"最强模型",不如建立灵活的多模型协作工作流。当GPT遇到瓶颈时,不妨让GLM来试试;反之亦然。善用每个模型的长处,互补配合,才是真正提升开发效率的正解。
核心要点
- 没有万能模型:不同大模型在训练数据、优化目标和架构设计上的差异,决定了各自的能力边界,单一模型难以覆盖所有场景
- 提示敏感性真实存在:同一需求的不同表述方式会在不同模型上触发截然不同的输出质量,语言习惯与模型训练语料的匹配度至关重要
- 多模型协作是工程实践的趋势:LangChain等主流框架已将模型路由内置为核心功能,"模型组合"策略在复杂任务上的表现优于任何单一最强模型
- 国产大模型已具备场景竞争力:GLM系列凭借本土化训练数据和双向架构优势,在中文开发者常见的前端与全栈场景中展现出不容忽视的实战能力
- 基准分数≠实战表现:HumanEval等标准评测侧重算法题,无法预测CSS布局等依赖经验积累的前端细节任务,实际开发中的多模型交叉验证不可替代
相关推荐

Claude被曝可在正常图片中隐藏秘密信息
Reddit帖子称Claude Fable 5.1能在正常图片中隐藏秘密信息,本文梳理事件背景、图片隐写技术原理及潜在安全风险,并给出从传闻走向验证的测试路径建议。

AI助手何时该主动建议?时机决定一切
AI助手何时该主动建议?Reddit讨论揭示:同样的建议在不同时机感受迥异。本文分析主动建议的双面性、用户期待的分界线及设计原则,探讨如何平衡自动化与用户控制。

联邦政府拨款8500万美元,CFS研发聚变专用半导体
联邦政府向Commonwealth Fusion Systems拨款8500万美元,用于研发聚变电站所需的导体与功率半导体。本文解读这笔资助对聚变产业链与商业化路径的意义。