GLM 5.3 Flash登陆Token Pass:百万上下文多模态编程模型
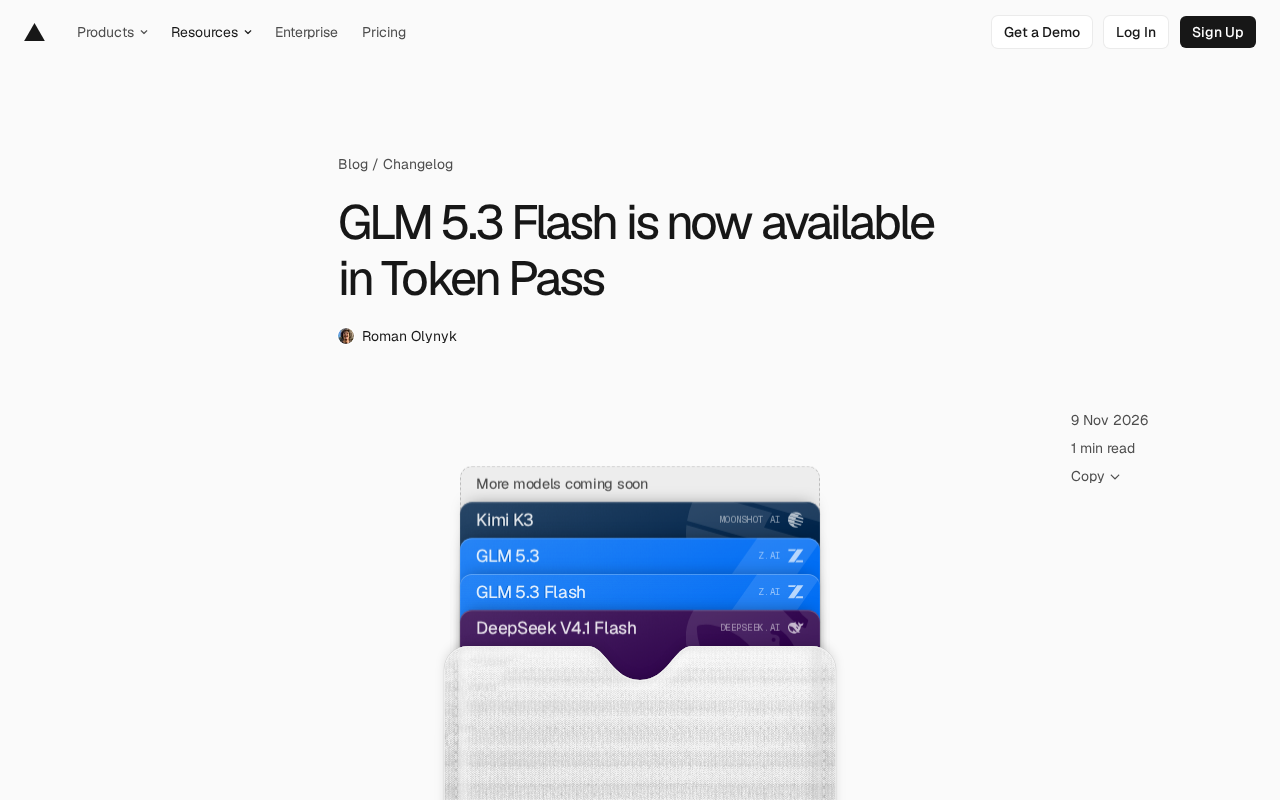
Z.ai 的 GLM 5.3 Flash 加入 Token Pass 模型池,主打多模态与百万级上下文。
Token Pass 是 Pro 团队每月 30 美元、提供 80 美元额度并通过 AI Gateway 调度的订阅服务,支持 fx、Pi、Cline、Command Code 等编程 agent,也可用 AI SDK 自建工具,默认启用零数据保留。Z.ai 的 GLM 5.3 Flash 正式加入,与 Kimi K3、GLM 5.3、DeepSeek V4.1 Flash 并列,官方称后续还会有更多模型接入。GLM 5.3 Flash 是原生多模态编程模型,拥有 100 万 token 上下文窗口,适合理解界面截图、设计稿与大规模代码库。接入只需在网关仪表盘添加模型或查阅文档配置,现有工作流无需改动。文章同时提醒,长上下文的实际有效利用率仍需实测,且不同模型间的额度消耗速率是否一致值得关注。
Token Pass 的模型阵容再次扩充。据官方消息,Z.ai 的 GLM 5.3 Flash 已正式加入 Token Pass,与 Kimi K3、GLM 5.3、DeepSeek V4.1 Flash 并列,官方表示后续还会有更多模型接入。
Token Pass 是什么
Token Pass 是 Pro 团队的一项订阅服务,每月 30 美元,提供 80 美元的月度额度,并通过 AI Gateway 运行。它支持 fx、Pi、Cline、Command Code 等各类编程 agent,开发者也可以用 AI SDK 自行构建工具,且默认启用零数据保留(Zero Data Retention)。
这个定价结构对高频使用编程 agent 的团队有一定吸引力:订阅费用与实际可用额度之间存在明显差价,相当于用固定月费换取更高的模型调用预算。
AI Gateway 是位于应用与各模型供应商之间的统一代理层。开发者只需对接一个端点,网关负责鉴权、路由、限流、用量计量与故障回退,并在不同供应商的 API 之间做格式转换。它的实际价值在于解耦:更换模型时改的是网关配置而非业务代码,团队还能按任务、成本或延迟策略把请求分流到不同模型。与直接用各家官方 API 相比,网关多了一层可观测性和集中计费能力,代价是多一跳网络延迟,并需要信任网关运营方的数据处理方式。
零数据保留(Zero Data Retention) 指服务方在请求完成后不持久化保存提示词与输出内容,仅保留必要的计费与滥用监控元数据。它通常区别于「不用于训练」这一较弱承诺,属于更严格的数据处理模式,常见于企业采购条款。对把私有代码提交给第三方模型的团队而言,零数据保留能显著降低源码外泄与合规审计风险,但具体保留范围、日志期限仍应以服务条款为准。
GLM 5.3 Flash 的定位
GLM 5.3 Flash 是 Z.ai 的原生多模态编程模型,拥有 100 万 token 的上下文窗口。这个规格意味着它可以一次性处理大规模代码库或长文档,减少分段调用的次数。
与同批次的 Kimi K3、GLM 5.3、DeepSeek广告 V4.1 Flash 相比,GLM 5.3 Flash 强调的是多模态能力与编程场景的结合——不仅能读代码,也能处理图像等非文本输入,这对于需要理解界面截图、设计稿或图表的前端与全栈开发任务尤其相关。
上下文窗口指模型单次请求中可容纳的 token 总量,涵盖输入提示与输出。100 万 token 大致相当于数十万行代码或数本长篇文档。长上下文的主要收益是减少检索增强(RAG)环节,把整个仓库相关文件直接放入提示,避免分块检索带来的信息遗漏与误差累积。但需要注意「有效上下文」问题:模型对超长输入中部信息的利用率往往低于首尾两端,即所谓「中间遗失」现象,且长输入会显著抬高延迟与单次调用成本。因此实际工程中通常仍需配合文件筛选与结构化摘要,而非无差别塞满窗口。
如何接入
接入路径很直接:在团队 AI Gateway 仪表盘的 Token Pass 页面添加 GLM 5.3 Flash,或查阅 Token Pass 文档完成配置。由于 Token Pass 本身通过 AI Gateway 统一调度,开发者不需要为每个模型单独维护一套接入逻辑。
对于已经在使用 fx、Cline 等 agent 的团队,新增模型基本是配置层面的操作,不需要改动现有工作流。这种「模型池 + 统一网关」的设计,也让团队可以在不同任务间切换模型,而不必绑定单一供应商。
值得关注的点
多模态编程模型的实用价值正在被重新评估。过去编程模型主要比拼代码生成与补全的准确率,而随着 agent 承担的任务变复杂——读取截图复现 bug、根据设计稿生成组件、理解流程图——多模态输入从加分项变成了必要能力。GLM 5.3 Flash 的加入,让 Token Pass 在这类场景下多了一个选择。
100 万 token 的上下文窗口则是另一个方向上的竞争。长上下文配合编程 agent,可以直接把整个仓库的相关文件纳入上下文,减少检索环节的误差累积。当然,上下文长度与实际有效利用率之间仍有差距,具体表现还需要实测验证。
零数据保留默认开启,对企业用户来说是合规层面的加分项。在把代码交给第三方模型处理时,数据留存策略往往是采购决策的关键门槛之一。
Token Pass 目前仍处于模型持续扩充的阶段,官方明确表示会有更多模型接入。对开发者而言,这意味着同一份订阅可以覆盖更多模型选择,但也需要关注额度在不同模型间的消耗速率是否一致。
相关推荐

告别Copilot订阅费:三款免费本地AI编程工具推荐
GitHub Copilot每月20美元太贵?Workflows HQ推荐三款免费本地AI编程工具:Cursor离线补全、Clawed 3.7处理多文件架构、Make自动化测试部署,覆盖开发全流程。

AI编程代理如何工作?Codex、Claude Code与Cursor解析
深入解析AI编程代理的工作原理:从探索代码库、拆解任务、生成代码到运行测试与修复错误,揭秘Codex、Claude Code、Cursor等工具背后的代理循环机制,并探讨开发者如何审查与验证AI生成的代码。

Cursor AI 自动搜索:Python+Selenium 实战
用 Cursor AI 生成 Python + Selenium 脚本,一句话提示词实现 Google 自动搜索:定位搜索框、输入关键词、回车提交、打印页面标题,附关键 API 解析与实践注意事项。